
Ein Bericht, wonach zwei Chipunternehmen möglicherweise an einem KI-Beschleuniger arbeiten, ist keine Produktankündigung. Er kann dennoch zeigen, wo ein Anbieter mehr geistiges Eigentum platzieren oder ein Hersteller Nachfrage sieht. Dieses strategische Signal muss aber von den Belegen getrennt werden, die zur Bewertung eines fertigen Geräts nötig sind.
Die Berichte über Arm und Samsung eignen sich gut für diese Unterscheidung. Sie beschreiben eine mögliche Zusammenarbeit für einen Edge-Beschleuniger; Samsungs öffentliches Material zu Arm SME2 erklärt, warum lokale KI-Lasten mehrere Recheneinheiten verbinden. Keine der Quellen bestätigt jedoch einen finalen Chip, Kunden, Benchmarks, eine Modellliste, Tape-out oder ein Lieferdatum. Diese Lücken begrenzen die Aussage.

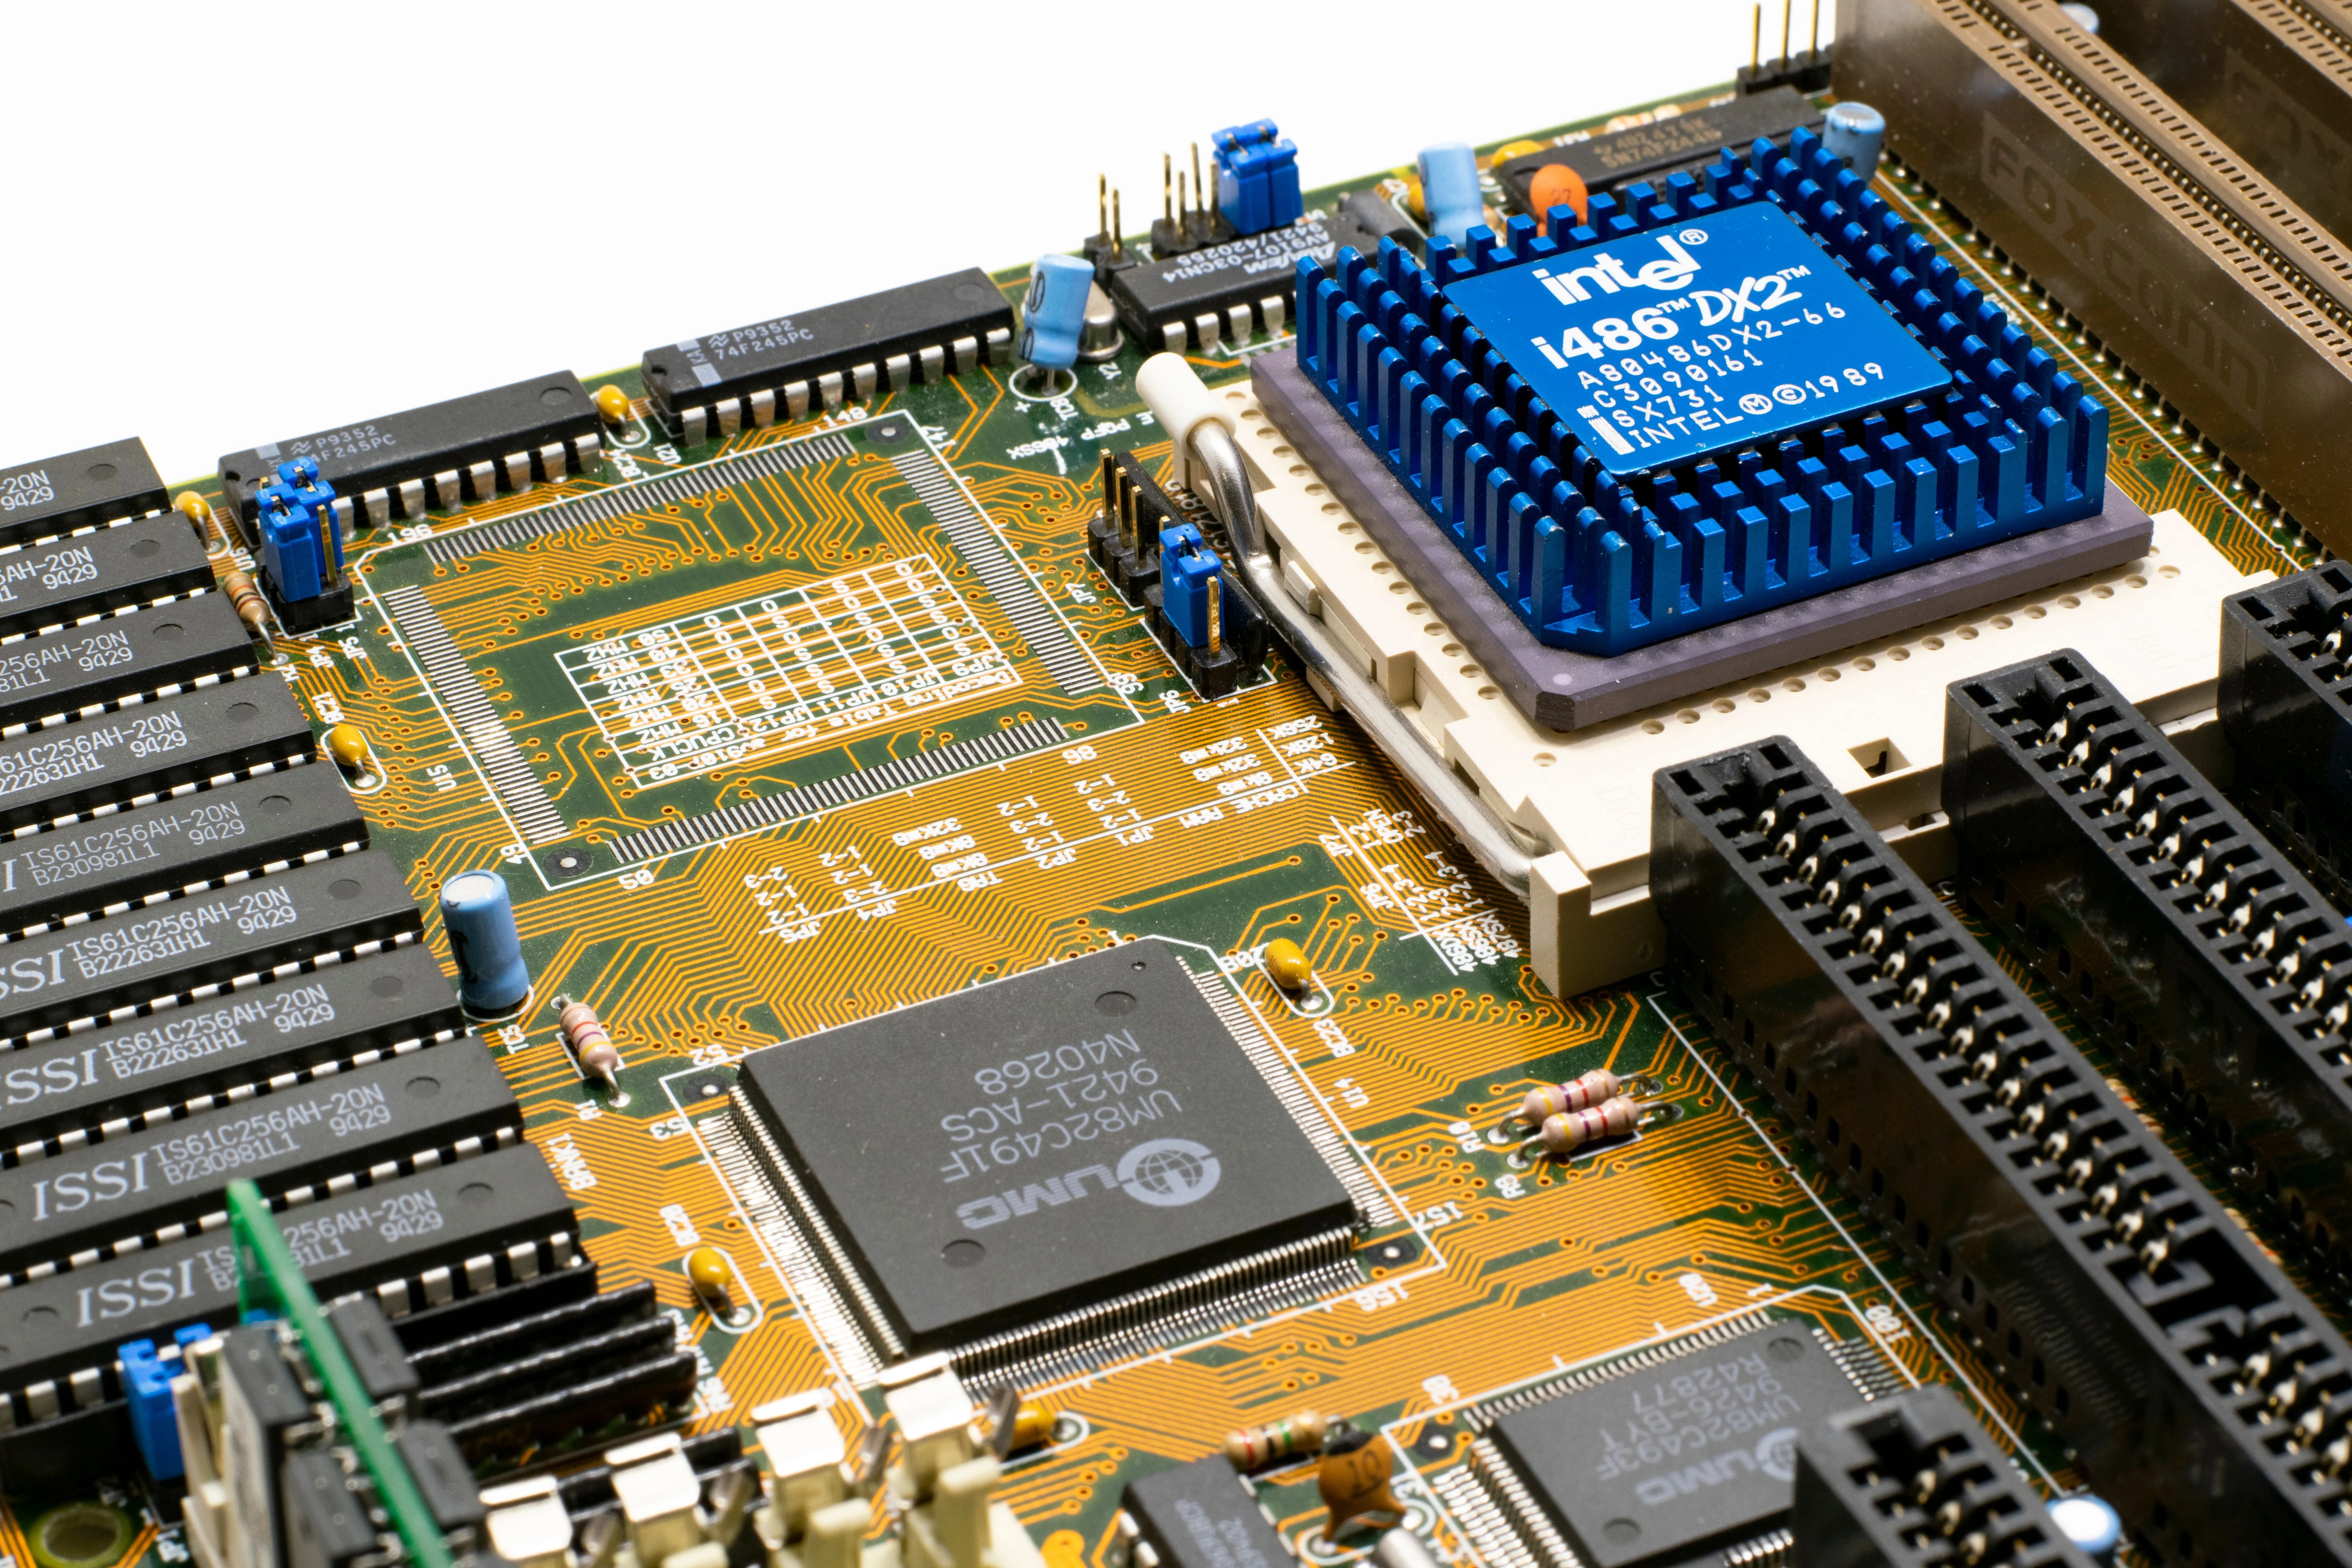
Foto von Nicolas Foster auf Pexels, verwendet unter der Pexels License. Es illustriert Halbleiterkontext, nicht das berichtete Projekt oder dessen Spezifikation.
Zuerst die Behauptung benennen
Ein KI-Beschleuniger kann ein wiederverwendbarer IP-Block, eine NPU in einem Smartphone-SoC, ein kundenspezifischer Chip oder ein Serverprodukt mit Hochbandbreitenspeicher und Netzwerk sein. Der erste Schritt ist daher, die tatsächliche Behauptung der Quelle zu bestimmen.
Eine berichtete Partnerschaft belegt Interesse, nicht Serienfertigung. Formale Ankündigung, Designverantwortung, Tape-out, Prozess, Qualifikation, Softwareunterstützung, Geräteintegration, Volumenfertigung und Verfügbarkeit sollten als getrennte, noch fehlende Meilensteine geführt werden. So wird aus einer frühen Designmeldung nicht versehentlich ein Einstieg in jede Ebene der KI-Infrastruktur.
Dasselbe gilt für Kundenspekulationen. Ohne primäre Bestätigung durch Kunde oder Partner bleibt ein möglicher Kunde unbestätigt. Ein Firmenname in einer Sekundärquelle ist weder Leistungsanforderung noch Bestellung oder Marktzusage.
Hardware dem Workload zuordnen
On-Device-Inferenz hat andere Grenzen als ein Rechenzentrum. Telefon, Laptop, Kamera oder Fahrzeug teilen Energie, Speicherbandbreite und Kühlung mit Anwendungen, Grafik, Konnektivität und Betriebssystem. Entscheidend ist nicht nur die Matrixarithmetik, sondern ob das gesamte Gerät eine nützliche Aufgabe mit akzeptabler Latenz, Energie und Temperatur abschließt.
Samsungs SME2-Beitrag beschreibt den Kontext heterogener Berechnung: kurze oder flexible Aufgaben können auf der CPU laufen, andere auf Spezialhardware. Das macht eine CPU nicht zur NPU und bestätigt keinen unangekündigten Beschleuniger. Es zeigt, warum Geräteergebnisse Datenbewegung, Scheduling und Modellform enthalten müssen, statt nur eine Spitzenzahl für Operationen zu nennen.
Fragen Sie nach Modell, Präzision, Batch-Größe und Kontextlänge. Ein kleiner Bildklassifikator, ein Offline-Sprachmodell und ein interaktiver Sprachassistent belasten Speicher und Rechenwerk unterschiedlich. Auch Netzbetrieb, externe Kühlung, frischer Neustart und ungewöhnliche Leistungsmodi müssen angegeben werden.
Software als Teil des Chips behandeln
Ein Beschleuniger ohne nutzbaren Softwarepfad ist keine fertige Fähigkeit. Entwickler brauchen Compiler, Modellkonvertierung, unterstützte Operatoren, Profiling, Dokumentation und einen vorhersehbaren Fallback. CPU-Kompatibilität liefert diesen Stack für eine separate Neural Engine nicht automatisch.
Eine glaubwürdige Veröffentlichung benennt Frameworks und Betriebssysteme, den Weg eines Modells zum Beschleuniger und das Verhalten bei nicht ausführbaren Operatoren. Sie trennt eine Demo-Umgebung von einem SDK für gewöhnliche Entwickler. Besonders aussagekräftig ist ein reproduzierbarer Workload mit offenem Modell, Softwareversion und Messmethode.
Das gilt auch für Datenschutzbehauptungen. Lokale Ausführung kann Übertragungen verringern, doch Datenfluss, Protokolle, Kontofunktionen, Updates und Fallbacks entscheiden über das Ergebnis. Ein lokaler Beschleuniger ist keine Datenschutzgarantie.
Auf Geräteebene und dauerhaft messen
Ein Chipbenchmark ist nur ein Anfang. Gekauft wird ein Gerät; messen Sie End-to-End-Zeit, Energie, Spitzen- und Dauertemperatur, Speicherdruck und Ergebnisqualität. Wiederholen Sie den Test nach dem Aufwärmen. Kurze Demos enden oft, bevor thermische Grenzen oder Hintergrund-Scheduling sichtbar werden.
Vergleiche brauchen dasselbe Modell, dieselbe Präzision, Software, Eingabe und Leistungsart. Nutzt ein Ergebnis eine neue App oder einen anderen Betriebssystem-Scheduler, ist es ein Plattformvergleich, nicht der Gewinn eines einzelnen Blocks. Fehler und Fallbacks gehören neben den erfolgreichen Pfad.
Das berichtete Projekt kann später nützliche lokale KI-Hardware hervorbringen. Bis zur Bestätigung ist die belastbarste Aussage enger: Es zeigt die wachsende Bedeutung heterogener, energieorientierter Rechenarbeit in Geräten. Als Nächstes zählen ein benanntes Produkt, ein öffentlicher Softwarepfad, reproduzierbare Gerätetests und dauerhafte Auslieferungen – nicht eine weitreichende Lesart eines frühen Berichts.
Wir verbinden Primärquellen, Produktdokumentation und reale Anwendungsszenarien, damit Sie besser einschätzen können, ob ein Tool zu Ihrem Workflow passt.