
两家芯片公司可能合作研发 AI 加速器的报道,并不等于产品已经发布。它仍可能有意义:报道或许揭示供应商想把更多知识产权放进何处,也可能反映制造商看见的需求。但要判断一台完成的设备,必须把这种战略信号与所需证据分开。
关于 Arm 与三星项目的报道正适合用这套方法。现有报道描述了一种可能面向端侧的加速器合作,而三星公开的 Arm SME2 材料解释了本地 AI 工作为何越来越需要多个计算单元协作。两类材料都没有确认最终芯片、客户、基准测试、模型清单、流片或出货日期。这些空白应当决定结论的边界。

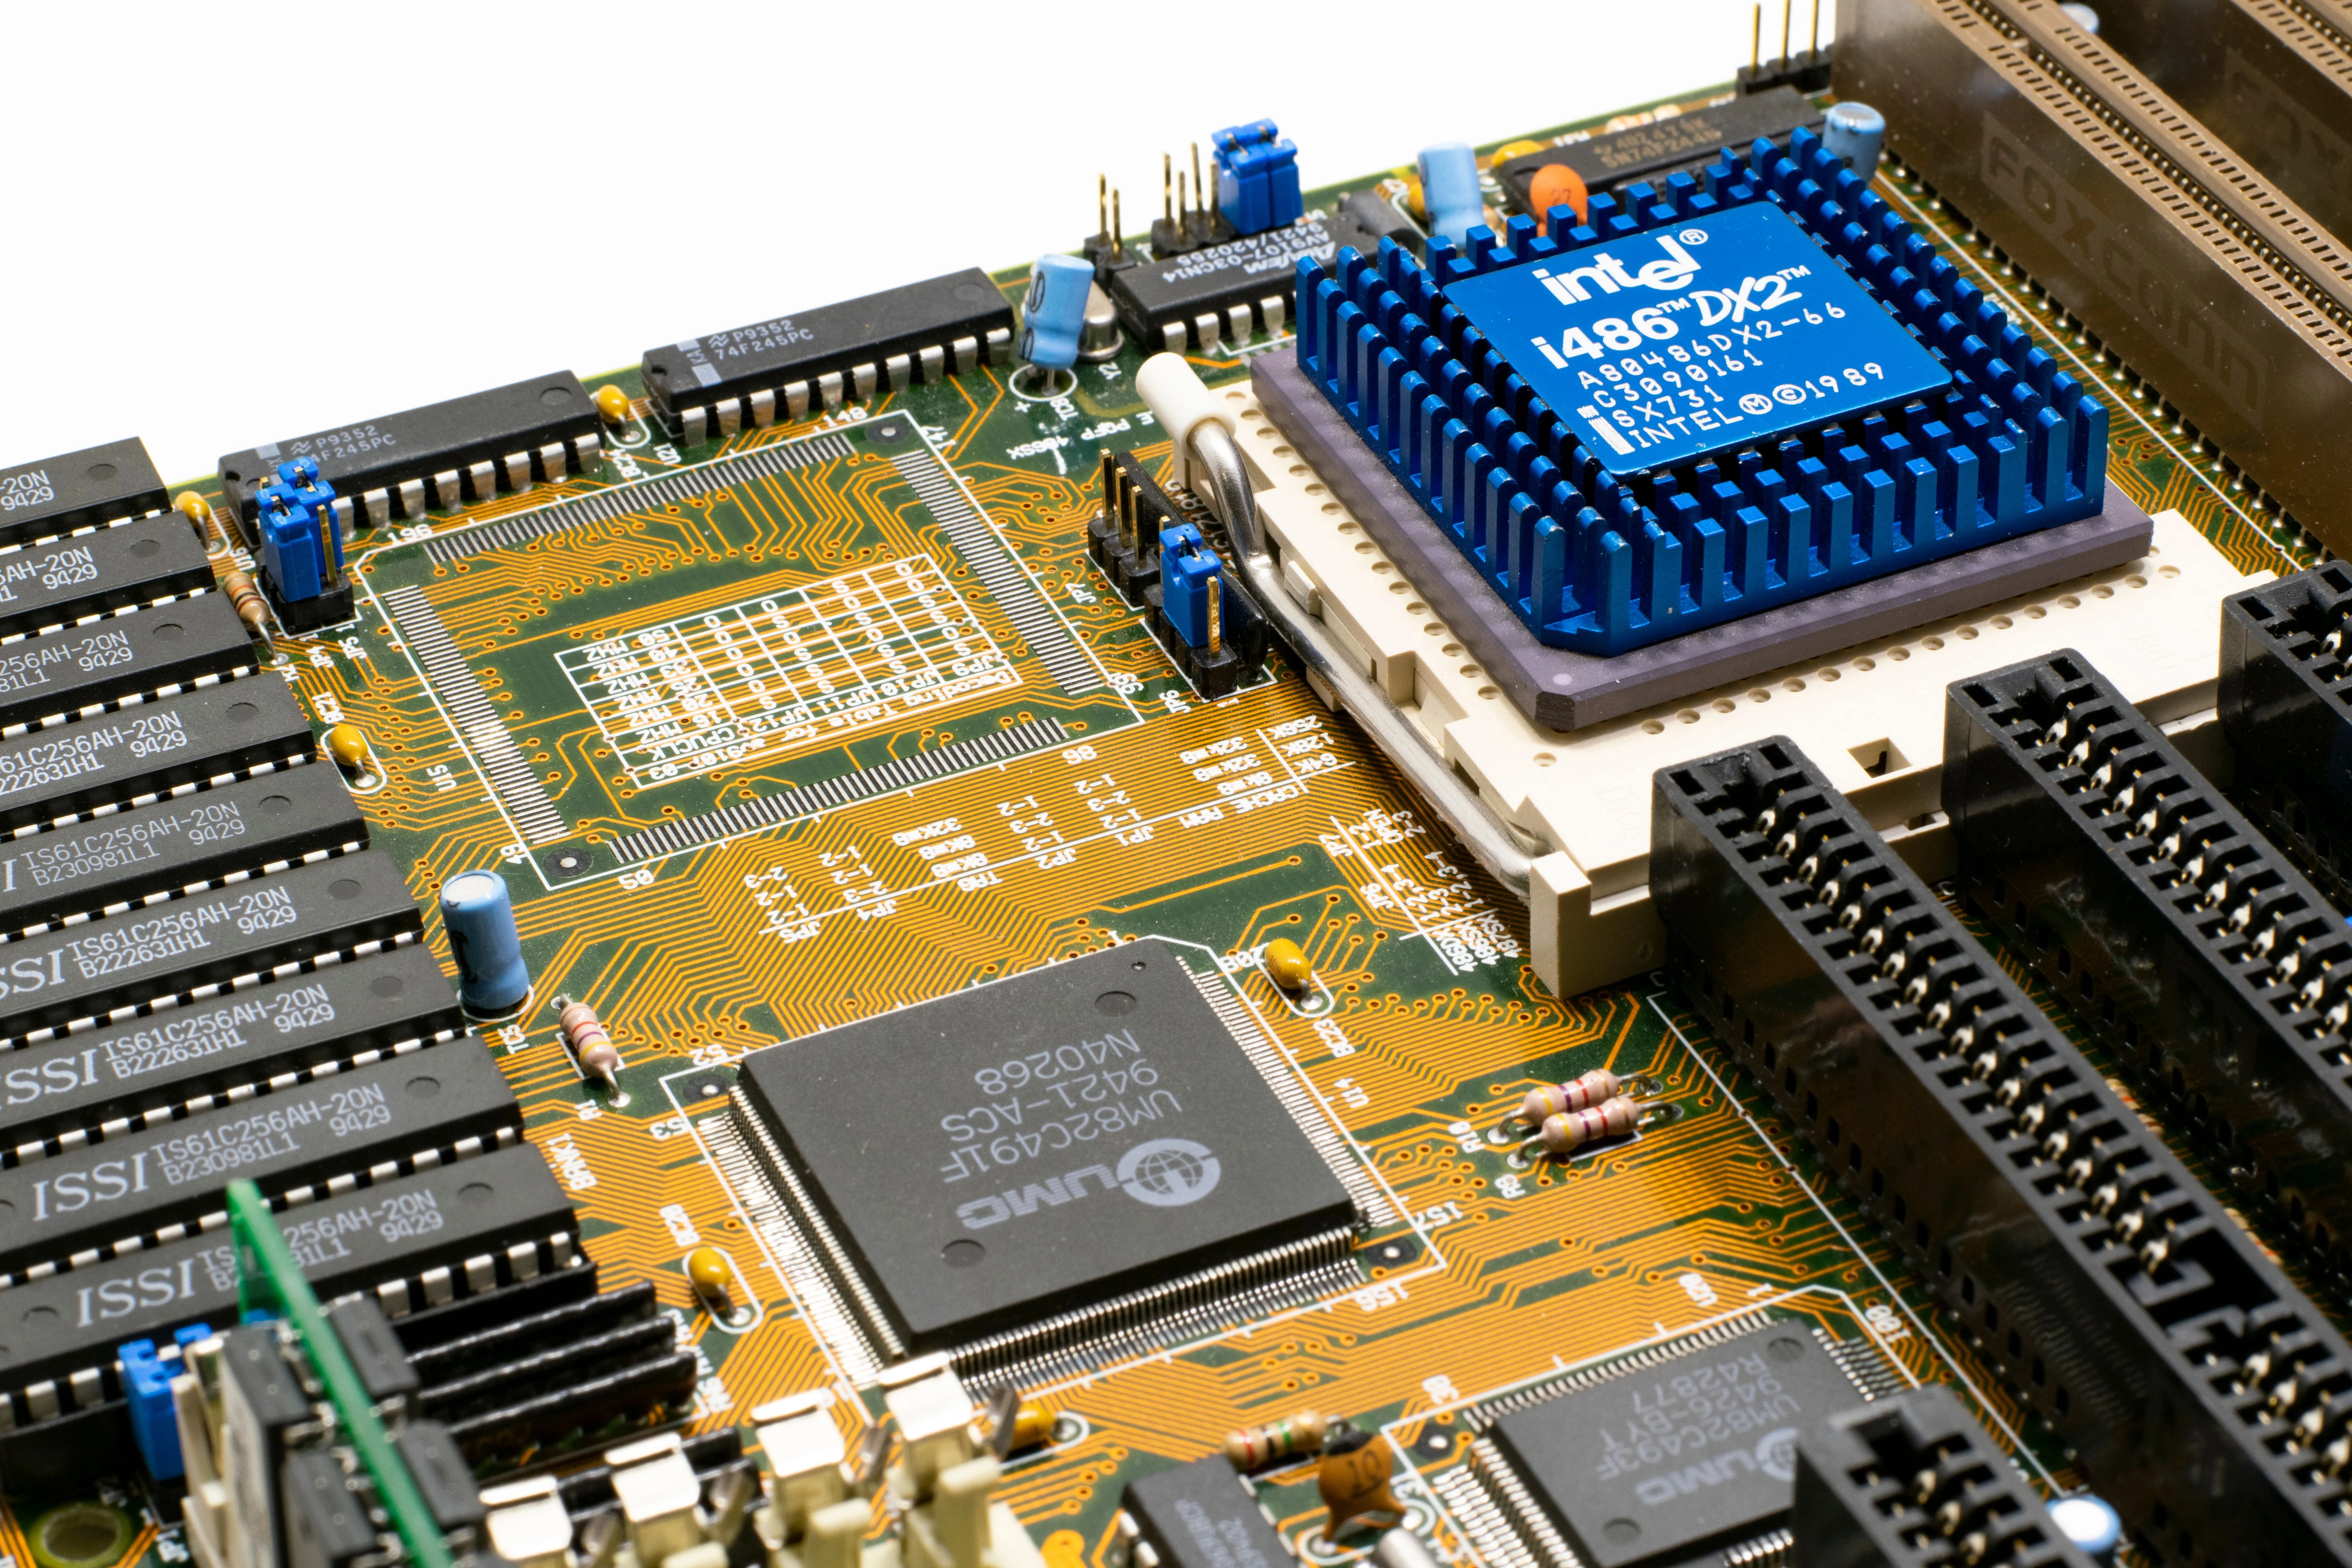
照片由 Nicolas Foster 在 Pexels 发布,按 Pexels License 使用。它用于说明半导体背景,不是所报道项目的图片,也不证明其规格。
先把声明说清楚
“AI 加速器”可能是可复用的知识产权模块、手机系统级芯片中的神经处理单元、为单一设备商定制的芯片,或带有高带宽内存和网络能力的服务器产品。第一步是辨认来源究竟提出了哪一种主张。
被报道的合作只能证明存在兴趣,不能证明芯片已经量产。应分别记录尚未出现的里程碑:正式公告、设计责任方、流片、制程、认证、软件支持、设备集成、量产和公开销售。这样就不会把早期设计新闻写成企业已经进入 AI 基础设施的每一个环节。
同样的谨慎也适用于客户猜测。除非客户或合作方在一手声明中确认产品,否则只能称为未获证实。二手报道中出现某公司名称,并不是性能要求、采购订单或上市承诺。
让硬件和工作负载对应
端侧推理面对的限制与数据中心不同。手机、笔记本、摄像头或车辆必须在应用、图形、连接功能和操作系统之间共享电力、内存带宽和散热能力。关键问题不是一个模块能否进行矩阵运算,而是整台设备能否以可接受的延迟、能耗和温度完成有用任务。
三星的 SME2 文章提供了一个有价值的背景:某些短小或灵活的工作可由 CPU 承担,另一些则适合专用加速。这不代表 CPU 就是 NPU,也不能验证一款尚未公布的加速器;它说明设备结果必须涵盖数据移动、调度和模型结构,而不能只看峰值运算次数。
应询问使用的模型、精度、批量大小和上下文长度。小型图像分类器、离线语音模型和交互式语言助手对内存与算力的压力并不相同。结果还应说明设备是否接电、是否外接散热、是否刚重启,或是否处于用户日常不会选择的性能模式。
把软件视为芯片的一部分
没有可用软件路径的加速器,不是完成的能力。开发者需要编译器支持、模型转换、已支持的算子、性能分析、文档,以及不支持工作负载时可预测的回退机制。CPU 兼容并不会自动为独立神经引擎提供这一整套能力。
可信的发布应说明支持哪些框架和操作系统、模型如何进入加速器,以及算子不能运行时会发生什么。还要区分演示环境与普通应用开发者可取得的 SDK。最有价值的证据,是公开模型、软件版本和测量方法的可复现实验。
这也影响隐私主张。本地执行可以减少传输输入的需要,但最终取决于产品的数据流、日志、账号功能、更新和回退行为。端侧加速器本身不是隐私保证。
要求设备层面和持续测试
芯片级基准只是起点。人们购买的是设备,因此应测量端到端完成时间、能耗、峰值和持续温度、内存压力以及结果质量。设备升温后还要重复测试;许多短演示在散热限制和后台调度显现前就结束了。
比较必须使用相同模型、精度、软件、输入和电源模式,并清楚说明基线。如果一个结果采用更新的应用或不同的操作系统调度器,应称为平台比较,而不能把提升归因于单一模块。失败和回退路径也应与顺利路径一起记录。
这一项目未来可能带来有价值的本地 AI 硬件。在得到确认之前,最强的结论更窄:它说明异构、重视功耗的计算对设备产品日益重要。下一步真正重要的证据很具体——明确产品、公开软件路径、可复现的设备测试与持续出货,而不是对早期报道作更宽泛的解读。
我们会结合一手资料、产品文档与实际使用场景,帮助你更清楚地判断工具是否适合你的工作流。