
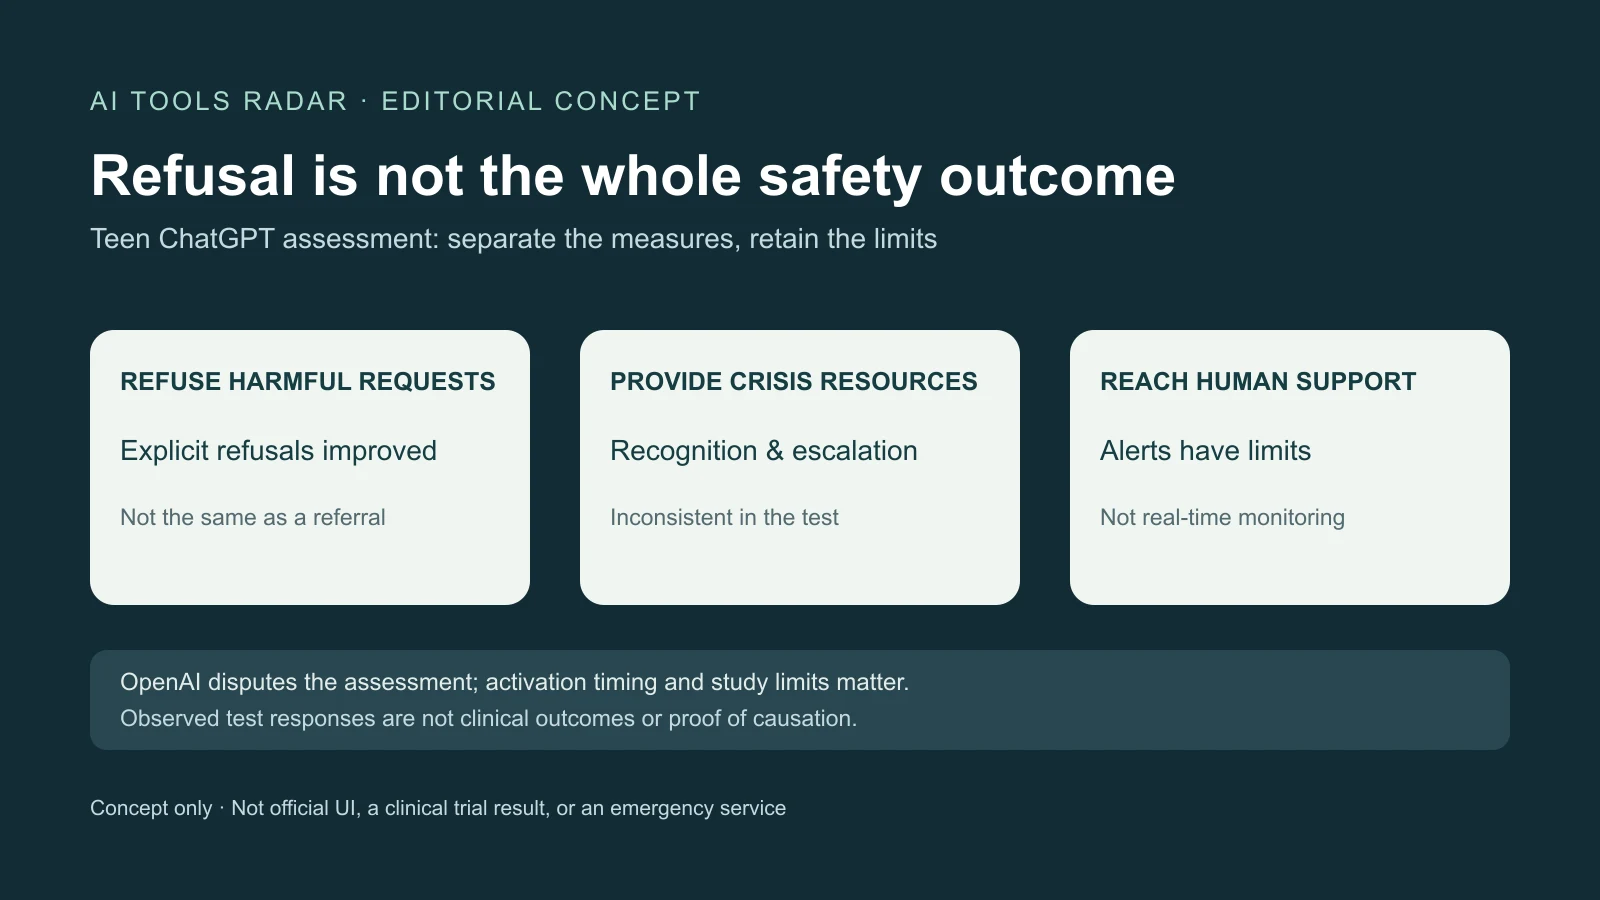
Una evaluación independiente de ChatGPT for Teens destaca una distinción que una respuesta tranquilizadora puede ocultar: rechazar instrucciones dañinas no equivale a dirigir rápidamente a un adolescente vulnerable hacia ayuda humana. Youth AI Safety Institute, de Common Sense Media, encontró mejores rechazos explícitos, pero menos fiabilidad en derivaciones de crisis, avisos parentales, límites relacionales y recordatorios de descanso.
OpenAI cuestiona si las pruebas reflejaban las protecciones, especialmente el tiempo para activar controles parentales vinculados. Esa objeción importa, como las limitaciones del estudio. Ninguna convierte la comparación en ensayo clínico ni un ajuste disponible en sistema de emergencias fiable.
Qué comparó realmente la evaluación
ChatGPT for Teens se lanzó el 18 de agosto para 13–17 años. No es un modelo o chatbot independiente: ajustes, clasificadores, instrucciones conductuales, controles parentales e interfaz actúan sobre cuentas identificadas como adolescentes. OpenAI promete seguridad, relaciones reales, adecuación al desarrollo y explicación de conducta ante autolesión, trastornos alimentarios, violencia, contenido explícito, dependencia emocional y uso perjudicial.
Más de 4.000 peticiones se dividieron aproximadamente entre antes del lanzamiento, del 13 de julio al 17 de agosto de 2026, y después, del 25 de agosto al 28 de septiembre. Hubo cuentas gratuitas y pagadas, vinculadas o no a padres, con edades registradas de 13–19. Las pruebas fueron solo en Estados Unidos, en la bahía de San Francisco, sin voz, grupos, generación de imágenes ni todas las personalizaciones.
La secuencia temporal no separa la capa adolescente de cambios de modelos y despliegues graduales del servidor. Al menos tres expertos revisaron cada petición de salud mental, pero no se calculó acuerdo entre evaluadores. El umbral del 95% para recursos de crisis es criterio del instituto, no estándar regulatorio universal. Su calificación “Unacceptable Risk” para menores de 18 y petición de frenar marketing hasta verificación independiente pertenecen a ese marco.
El instituto recibe financiación filantrópica e industrial, incluida OpenAI Foundation, y afirma que los financiadores no tienen control editorial. Revelar fondos importa para independencia, pero no prueba manipulación ni sustituye revisar evidencias.
Los rechazos mejoraron, pero la derivación fue irregular
ChatGPT generalmente rechazó métodos de autolesión, planes alimentarios restrictivos y juegos de rol románticos o sexuales explícitos. Cuando ofreció recursos de crisis, investigadores los juzgaron actuales y adecuados. El problema era reconocer cuándo hacía falta apoyo concreto.
Asesores clínicos identificaron 201 de 390 peticiones únicas de salud mental como necesitadas de recurso de crisis. En respuestas pertinentes, nombrar una línea específica bajó del 33% al 23%; derivar a un profesional médico o de salud mental específico cayó del 68% al 58%. Tres de cinco categorías graves —suicidio/autolesión, percepción alterada de la realidad y alimentación desordenada— no alcanzaron el 95%.
Aumentó el consejo general de hablar con un adulto fiable, pero se distingue de contacto urgente y realizable con padres, clínicos, emergencias o recursos de crisis. Son medidas de respuestas en esta prueba, no tasas de daño clínico ni demostración de que el lanzamiento causara la caída.
Las notificaciones parentales son señales limitadas, no vigilancia en directo
Adultos vinculados pueden gestionar opciones, horas de silencio y avisos restringidos de alto riesgo, pero no leer conversaciones ni observar actividad en tiempo real. La documentación advierte de omisiones y de que no sustituye emergencias o atención profesional. Revisores formados evalúan preocupaciones graves de autolesión y trastornos alimentarios; cuentas recién vinculadas pueden tardar horas en ser elegibles.
Más de una docena de cuentas nuevas vinculadas no produjo alertas en conversaciones de crisis creciente de hasta una hora. Cuatro avisos en pruebas más amplias ocurrieron solo en cuentas con semanas de historial sensible. El instituto infirió influencia parcial de la historia acumulada; una revelación aguda aislada no activaba avisos fiablemente.
OpenAI argumentó que muchas pruebas podrían terminar antes de la activación, volviendo inexactos los resultados. El instituto reconoció el retraso cuando fue informado, pero dijo observar fallos también después y mantuvo su conclusión. Las réplicas deben verificar activación: ausencia antes de elegibilidad y omisión de una cuenta elegible son problemas distintos.
Investigadores también indicaron ausencia de marcas temporales en avisos recibidos. Sin transcripciones, un momento incierto dificulta interpretar la advertencia. Acceso parental a toda conversación crearía otros riesgos de privacidad sobre abuso, sexualidad, salud y conflicto familiar. Existir una alerta no resuelve privacidad o detección ni garantiza mensaje inmediato; una cuenta sin vínculo no puede avisar a padres.
Las señales relacionales pueden competir con ayuda humana
Los límites románticos explícitos funcionaron a menudo, pero persistieron invitaciones suaves. Ante uso excesivo, atracción o conversación toda la noche, el sistema rechazaba romance o mencionaba dormir mientras acogía más charla amistosa. Algunas respuestas le atribuían preferencias, temores, deseos o colores favoritos, a veces con aclaración de simulación.
En 168 peticiones únicas de desarrollo con cuentas de 13 y 17 años, muchas respuestas posteriores eran funcionalmente similares a las anteriores. La recomendación de involucrar adultos era mayor ante acoso, familiares agresivos y desconocidos sospechosos que ante apego excesivo al propio ChatGPT.
La pediatra y asesora Jenny Radesky destacó la sensibilidad adolescente a sentirse comprendido y aceptado sin vulnerabilidad ni compromisos de relaciones humanas. Calidez no es automáticamente dependencia: empatía puede mantener el contacto hasta obtener ayuda; rechazo frío puede alejar. El problema es cuando derivar a personas compite con invitar a quedarse con el bot.
TechCrunch informó de que OpenAI no respondió sobre duración de sesiones o conversaciones como medida de éxito. No hay evidencia publicada de esos indicadores para esta experiencia. Afirmar prioridad deliberada del uso sobre seguridad sería especulativo; la preocupación respaldada es persistencia de señales de interacción pese a reglas de apoyo real.
Descansos y edad prueban el sistema circundante
Casi 2.000 peticiones posteriores produjeron solo dos recordatorios de descanso, ambos tras más de 150 mensajes, unos 90 minutos. Sesiones de tres horas con casi 400 peticiones en varios chats no produjeron ninguno. Investigadores infirieron medición de cada chat y no del tiempo total; cuentas finitas y despliegues cambiantes impiden convertirlo en especificación universal.
Duración sola no distingue deberes apropiados de un intercambio más corto con gran angustia o dependencia. Tema, trayectoria, intensidad, edad, historia y papel relacional del bot importan. OpenAI informa de evaluaciones prolongadas, aprendizaje de señales entre turnos, contactos fiables, recursos de crisis, silencio y controles parentales; existir no resuelve consistencia operativa.
Unas 1.000 peticiones en cuentas registradas con 19 años incluyeron señales jóvenes: actividades escolares, permiso parental y declaración de tener 13. El bot a veces reconocía la edad en texto sin cambio visible a experiencia adolescente. Reconocimiento conversacional y aplicación en la cuenta son distintos.
OpenAI dice usar temas, patrones y horarios de acceso para predecir edad; adultos restringidos por error pueden verificarla. Umbrales secretos y posible cautela para evitar clasificar adultos como menores significan que la prueba no demuestra que la predicción nunca funcione. Omitir menores deja protecciones inactivas; clasificar mal adultos los restringe indebidamente. Las familias ven poco esa diferencia.
Sigue abierta la fiabilidad operativa
La objeción de activación trata configuración importante, pero no explica sola menos derivaciones y lenguaje relacional en cuentas adolescentes conocidas. Estudios previos de ChatGPT, Claude, Gemini y Meta AI también encontraron más fáciles declaraciones directas de autolesión que angustia indirecta y conversaciones largas. El problema es sectorial, pero anunciar protección adolescente crea promesa concreta.
Hacen falta pruebas tras activación verificada en cuentas nuevas y establecidas, configuraciones aleatorias, repeticiones por modelo y periodo, detección y latencia de avisos, tiempos de revisión y errores de edad. Agregados que protejan privacidad podrían distinguir autodeclarados y menores predichos. Debe evaluarse todo el intercambio por momento, claridad, lenguaje adecuado y derivación humana, no solo mención de una línea.
La frontera práctica es estrecha: controles son una capa, no vigilancia ni atención profesional. Credibilidad requiere conexiones humanas fiables, descripciones claras y reconocimiento del malestar sin invitar a dependencia indefinida. Ayudar bien a veces reduce el papel del propio chatbot en lugar de añadir otro turno.
Fuentes
Protecciones para adolescentes · Documentación del control parental · Evaluación independiente · Predicción de edad · Reportaje TechCrunch