
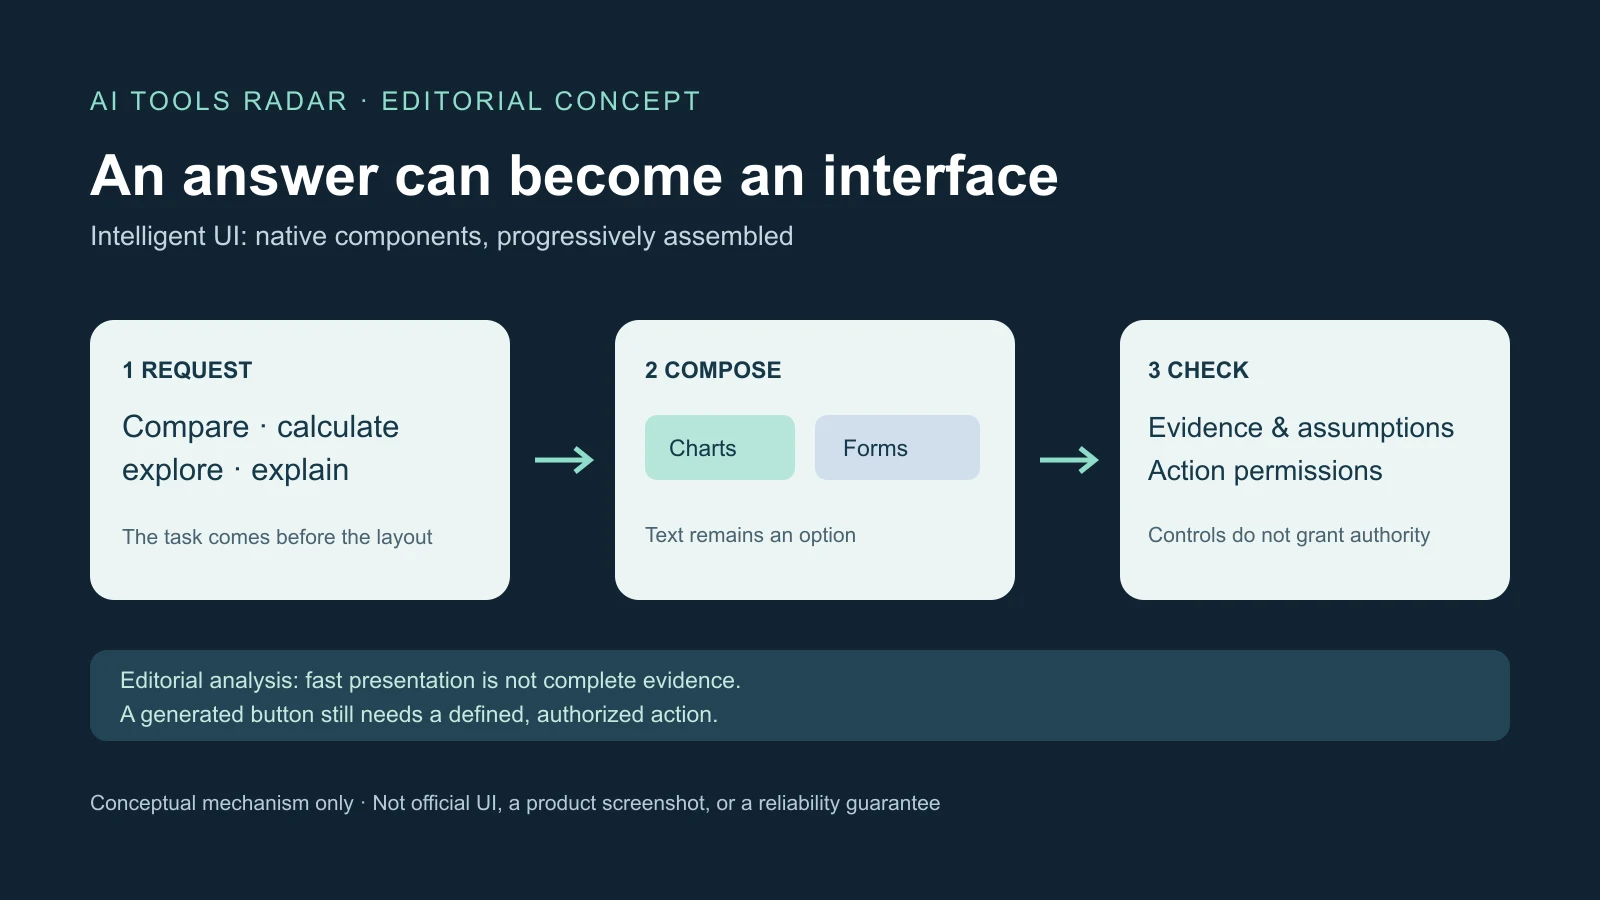
OpenAI가 10월 7일 발표한 Intelligent UI는 ChatGPT 답변의 형태를 바꾼다. GPT-6는 세로로 이어지는 텍스트뿐 아니라 차트, 양식, 도표, 지도, 버튼, 특정 목적의 작은 도구를 선택할 수 있다. 핵심은 장식이 아니다. 사용자가 어떤 선택지를 보고 과제를 어떻게 탐색할지까지 모델이 판단한다.
레시피에는 준비 시간표, 여행 경로에는 정차 지점을 연결한 지도, 비교에는 나란히 놓인 대안을 붙일 수 있다. 저축 계산기, 식사비 나누기, 간단한 게임은 앱을 먼저 선택하는 대신 요청에 맞춰 소프트웨어를 조립하는 사례다. 조작 요소가 도움이 되지 않으면 일반 텍스트가 여전히 적절하다.
네이티브 구성요소와 스트리밍이 작동 방식을 정한다
OpenAI는 네이티브 구성요소 라이브러리와 GPT-6 생성 중 인터페이스를 처리하는 컴파일러를 설명한다. 모델은 표준 버튼과 입력란을 배치하며, 모든 동작을 새로 만드는 무제한 웹페이지를 생성하는 방식이 아니다. 통제된 표현 체계는 일관성을 돕지만 조합의 범위도 플랫폼 선택으로 제한한다.
구성요소는 점진적으로 전달돼 답변 완료 전에 읽거나 조작할 수 있다. 업데이트 설명은 첫 응답 뒤에도 GPT-6가 사고나 도구 사용을 계속하고 새 요청 없이 결과를 추가할 수 있다고 한다. 연구가 끝나기 전에 요약을 보여주거나, 설명이 이어지는 동안 계산기 입력란을 열 수 있다.
이는 풍부한 답변을 기다리는 빈 화면 시간을 줄이지만 완결성 문제를 만든다. 차트는 데이터가 잠정적이거나 수정됐음을 알려야 한다. 계산기는 핵심 입력이 확정되기 전에 결과에 의존하도록 유도해서는 안 된다. 빠른 표시와 근거가 모두 갖춰진 상태는 서로 다르다.
계정 제공은 모든 GPT-6 화면의 기능 일치를 뜻하지 않는다
Plus·Pro·Business·Enterprise는 10월 7일, Free·Go는 10월 8일 순차 제공을 시작했다. 전 세계 Chat 탭이 대상이지만 계정, 클라이언트, 작업공간 설정과 관리자의 모델 사용 권한이 실제 접근에 영향을 준다. 배포 시작 날짜는 모든 계정과 기기에 기능이 도착했다는 확인이 아니다.
OpenAI는 유료·관리 계정의 일상 Chat에 GPT-6 Sol, Free·Go에 Luna를 지정한다. Astra는 지원되는 고급 추론에 남지만 Pro 추론 옵션은 Intelligent UI를 지원하지 않는다. 이 발표가 ChatGPT Work나 Codex 모델을 대체하거나 모든 GPT-6 제품의 같은 상호작용을 보장하는 것은 아니다.
회사는 레이아웃, 상호작용, 명확성, 완결성과 텍스트를 선택해야 할 상황을 학습·평가했다고 하며 설계 판단의 개선 필요성도 인정한다. 주간 12억 명 이상은 ChatGPT 전체의 보고된 이용 규모다. 모두가 새 UI를 사용했거나 혜택을 얻었다는 증거가 아니다.
좋은 조작 요소는 가정을 대화에 붙들어 둔다
설명 다음에 다른 작업이 필요한 경우 이점이 분명하다. 은퇴 시나리오는 성장 가정을 조절해야 하고, 확률 수업은 변수를 바꾸며 배울 수 있다. 식사비 분담은 공식만 설명하는 대신 총액·인원·세금·팁을 받는다. 대화가 맥락을 보존하므로 사용자는 가정을 반박하거나 결과가 달라진 이유를 물을 수 있다.
지식 업무도 글만 아니라 점검할 수 있는 판단과 수정 가능한 대안을 필요로 한다. 비교 패널은 문서 간 불일치를 드러내지만 빠진 근거를 숨길 수도 있다. 출처 검토와 지식 통합은 계속 필요하다. 주장을 보기 좋게 배열해도 그 출처를 입증하지는 못한다.
유통 전략이기도 하다. 추천 후 경로 비교, 학습 연습, 상품 추리기를 ChatGPT 안에 남길 수 있다. OpenAI는 이것이 클릭이나 낯선 조작 요소를 해독하는 시간만 늘리는 것이 아니라 실제 일을 줄인다는 점을 보여야 한다.
경쟁 제품은 생성 소프트웨어의 다른 경계를 보여준다
Claude Artifacts는 문서·대시보드·웹사이트·코드·대화형 도구를 대화 옆의 별개 객체로 제시한다. 지속되는 객체는 반복 수정과 공유를 돕는다. Gemini 시뮬레이션은 교육과 탐색의 조절 가능한 모델을 강조한다. Microsoft 365 Copilot 위젯은 정의된 구성요소를 서비스 및 기업 업무에 연결한다.
Intelligent UI의 차이는 별도 빌더나 명시적 Artifact 요청 없이 일상 대화에서 형식을 자동 선택한다는 점이다. 사용자는 어떤 인터페이스를 요구해야 할지 미리 알 필요가 줄어든다. 반대로 생성 앱에 들어가기로 의식적으로 선택하지 않아도 조작 요소를 만날 수 있다.
경쟁은 생성 UI와 고정 소프트웨어 사이에도 있다. 고정 제품에는 익숙해질 기준점과 테스트된 화면이 있다. 의도 중심 조합은 불필요한 메뉴를 없애지만 매번 새 배치를 이해하게 한다. 좁은 라이브러리는 유연성을 줄이고, 자유 생성은 고장 난 컨트롤·접근성 문제·불안전한 동작을 늘린다. 네이티브 구성요소는 통제된 중간 경로이지 올바른 판단의 보증이 아니다.
시각적 확신이 사실의 확실성을 앞서면 안 된다
계산기는 검증된 전문 도구가 아니라 설명용 모델일 수 있다. 양식은 답변을 다듬거나 도구 호출용 정보를 모으거나 외부 작업을 실행할 수도 있다. ‘예약’·‘전송’·‘적용’은 클릭 전에 의미가 분명해야 한다. 익숙한 모양이 빠진 권한을 부여하지 않는다.
차트에는 올바른 데이터·범주·단위·척도·불확실성이 필요하다. 정확한 숫자도 묶음이나 축 설정으로 오해를 낳는다. 비교 카드의 근거가 동등해 보여도 출처 시점과 신뢰성은 다를 수 있다. 양식이 중요한 선택지를 조용히 배제하면 의료·법률·금융 맥락이 불완전할 때 특히 위험하다.
접근성은 전체 조합의 의무다. 키보드 탐색, 대비, 레이블, 텍스트 대안, 스트리밍 중 예측 가능한 초점과 읽기 순서가 필요하다. 표준 구성요소는 돕지만 접근 가능한 버튼 하나가 일관성 없는 절차를 이해 가능하게 만들지 않는다. 과도한 변화는 고정 소프트웨어를 효율적으로 만드는 학습 습관도 없앤다.
출시 자료에는 잘못된 형식 선택이나 오해를 유발하는 조합의 빈도를 확립한 폭넓은 공개 벤치마크가 없다. 증거 공백이지 실패 증명은 아니다. 새로움 때문에 클릭하거나 오래 머무르는 것으로 유용한 탐색과 혼란을 구별할 수 없다. 과제 완료와 올바른 해석이 텍스트 답변과의 더 좋은 비교 기준이다.
기업 권한은 생성 레이아웃 밖에 있어야 한다
팀은 신뢰할 데이터와 좁은 기능을 노출하고 모델이 특수 요청에 상태 패널이나 검토 양식을 조립하게 할 수 있다. 그러나 버튼을 추가하겠다는 모델 판단이 이메일 전송·결제 승인·계정 변경 권한을 주어서는 안 된다. 입력 검증, 접근 통제, 확인과 감사 기록은 소프트웨어 책임이다.
재현성도 달라진다. 요청, 대화 이력, 모델 버전과 가용 맥락에 따라 대시보드 강조점이 바뀐다. 검토자는 다른 권고가 나온 이유를 설명하려고 요청·선택 구성요소·출처 데이터·표시 선택의 근거를 기록해야 할 수 있다. 기존 관리자의 모델 접근 설정만으로 모든 생성 행동의 세밀한 통제가 증명되지 않는다.
Chat 출시는 API 개발자가 모든 인터페이스나 동일한 구성요소 동작을 재현할 수 있다는 약속이 아니다. MCP는 외부 도구·데이터를 연결하며, 서비스 기반 위젯과 OpenAI 네이티브 답변 조합은 관련되지만 다른 계층이다. 신뢰할 기능과 적응형 표시를 결합하면 모델·데이터 제공자·실행 호스트의 책임을 나눠야 한다.
실무 테스트는 출처 추적, 데이터와 추론 구분, 표시 변경과 외부 작업 구분, 확인, 불완전 데이터, 수정 후 복원, 키보드만의 사용을 점검해야 한다. 필터링·가정 조절·근거 정리·초안 작성 같은 되돌릴 수 있는 탐색은 비가역 거래보다 좁은 출발점이다. 고위험 입력·권한·결과는 결정론적 보호장치로 검증해야 한다.
지속 가능한 기반인지 보여줄 신호는 셋이다. 계정과 클라이언트를 아우르는 일관된 제공, 충실성·접근성·과제 성공의 품질 근거, 자동 조합과 명시적 사용자 통제 사이의 경쟁사 선택이다. 모든 답변을 앱으로 만드는 것이 목표는 아니다. 필요한 만큼의 인터페이스, 보이는 근거, 이해 가능한 변화, 텍스트가 가장 좋을 때 텍스트를 선택하는 것이 목표다.
출처와 관련 자료
GPT-6 발표 · ChatGPT 업데이트 · 관련: 지식 통합 · WIRED 체험 보도 · Claude Artifacts · Gemini 시뮬레이션 · Copilot UI 위젯 · Intelligent UI 보도