
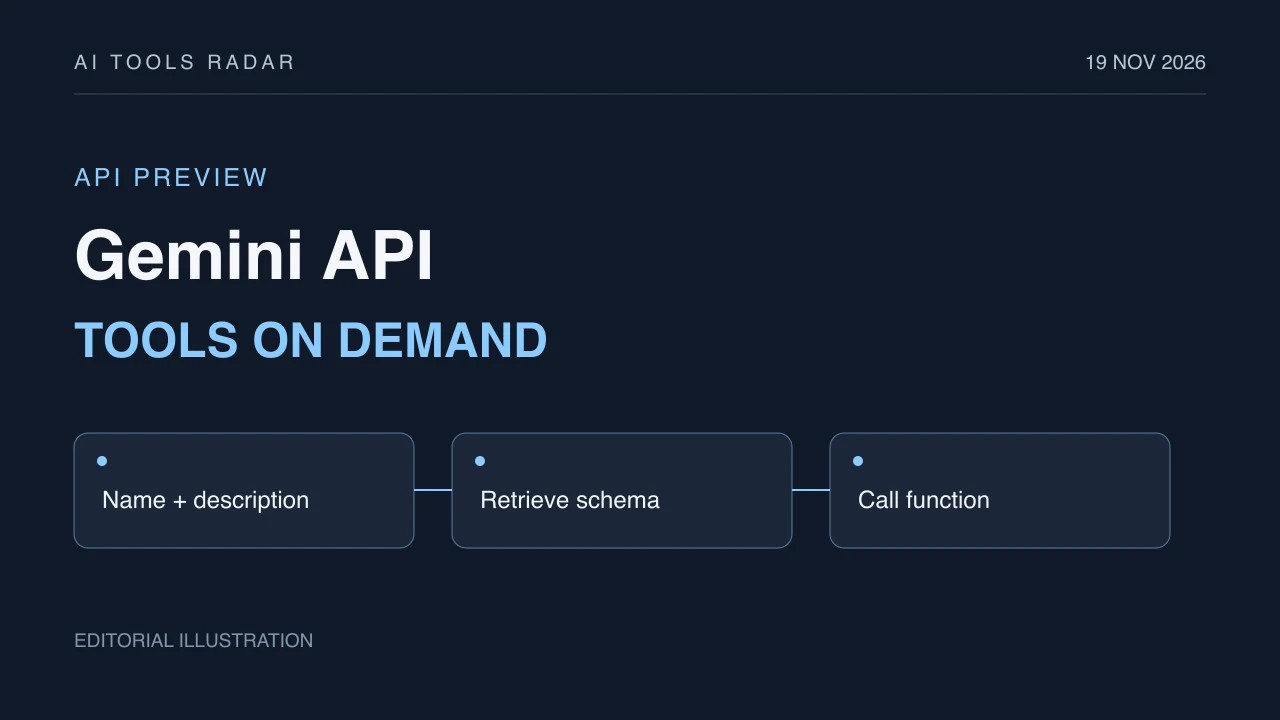
Google wprowadził 19 listopada próbną funkcję Tool Retrieval, zmieniając sposób udostępniania Gemini dużych bibliotek funkcji. Twórcy mogą odłożyć schematy parametrów do chwili, gdy model ich potrzebuje, zamiast wysyłać wszystkie przy każdym żądaniu.
Ogłoszenie umieszcza funkcję w Interactions API. Google chce zmniejszyć liczbę tokenów wejściowych i zachować trafność wyboru narzędzi mimo wzrostu biblioteki. Rzeczywiste oszczędności i niezawodność zależą jednak od aplikacji.
Nazwy pozostają widoczne, schematy czekają
Aby uruchomić wyszukiwanie serwera, dodaje się tool_search i oznacza funkcje przez defer_loading: true. Model nadal widzi nazwy oraz opisy, ale schematy parametrów pozostają poza kontekstem do chwili żądania.
Po wyborze funkcji model żąda jej po nazwie. API ładuje schemat, a model generuje wywołanie w tym samym żądaniu. Wyszukiwanie, wynik i końcowe wywołanie trafiają do interaction.steps, gdzie można je sprawdzić.
Przykład Google używa gemini-4-hydrogen do żądania zwrotu 40 dolarów za uszkodzone zamówienie A-1042. Model odnajduje issue_refund i przekazuje zamówienie oraz kwotę jako argumenty. Aplikacja nadal wykonuje zwrot i odsyła function_result: pobranie schematu nie przesyła pieniędzy ani nie autoryzuje transakcji.
To ważna granica dla wrażliwych narzędzi. Lepsze odnajdywanie nie zastępuje uprawnień, walidacji ani reguł biznesowych.
Wyszukiwanie serwera nie wymaga własnego indeksu
Wariant zarządzany na serwerze nie wymaga utrzymywania indeksu przez twórców. Częste narzędzia mogą być w pełni zadeklarowane od początku, a sporadyczne funkcje ładowane później. Nazwy i opisy pozostają ważne nawet po usunięciu dużych schematów z początkowego kontekstu.
Obsługiwane są też zdalne serwery MCP. defer_loading: true przy mcp_server pozwala ładować ich narzędzia na żądanie bez wymieniania każdego osobno.
Google wskazuje zgodność z pamięcią podręczną prefiksu: odroczone schematy nie pojawiają się na początku promptu, lecz później w rozmowie. Prefiks pozostaje więc stabilny między turami. Nie oznacza to darmowego użycia później załadowanych schematów.
Wyszukiwanie klienta zachowuje kontrolę nad rejestrem
Aplikacje z własnym rejestrem, indeksem wektorowym lub filtrem uprawnień użytkownika mogą wybrać wykonanie klienta. Deklarują tool_search z "execution": "client", funkcją wyszukiwania i jej parametrami.
Gdy model żąda wyszukiwania, aplikacja je wykonuje i zwraca pasujące schematy przez function_result. Przykład kontynuacji używa previous_interaction_id, łącząc dalsze żądanie z istniejącą interakcją.
Każde wyszukiwanie dodaje jedną wymianę żądania i odpowiedzi, ponieważ przeszukiwanie odbywa się w aplikacji. W zamian nie trzeba deklarować wszystkich narzędzi na początku. Integracja połączona podczas rozmowy może dodać nowe, a własny rejestr decyduje o zwracanych kandydatach.
To inny kompromis niż przy wyszukiwaniu serwera. Kontrola odkrywania oznacza dodatkowy etap aplikacji wraz z opóźnieniem i obsługą awarii.
Oszczędność zależy od niezaładowanych schematów
Tool Retrieval nie ma osobnej opłaty. Tokeny wejściowe i wyjściowe są rozliczane według standardowej taryfy wybranego modelu. tool_search dodaje niewielki stały blok wejścia, a każdy pobrany schemat jest rozliczany jako wejście do końca rozmowy.
Zysk pochodzi ze schematów, które nigdy nie trafiają do kontekstu. Duża biblioteka z małą używaną częścią daje większy potencjał niż rozmowa ładująca ostatecznie niemal wszystko. Google zaleca pomiary na własnym ruchu i nie podaje uniwersalnego procentu oszczędności.
Wersja próbna obsługuje Gemini 3.6 i nowsze, w tym wszystkie modele Gemini 4, w Interactions API. Nie oznacza to każdej powierzchni API. Następne użyteczne dane to zużycie tokenów, wybór narzędzi i opóźnienie wyszukiwania klienta we własnej aplikacji przy tych warunkach.