
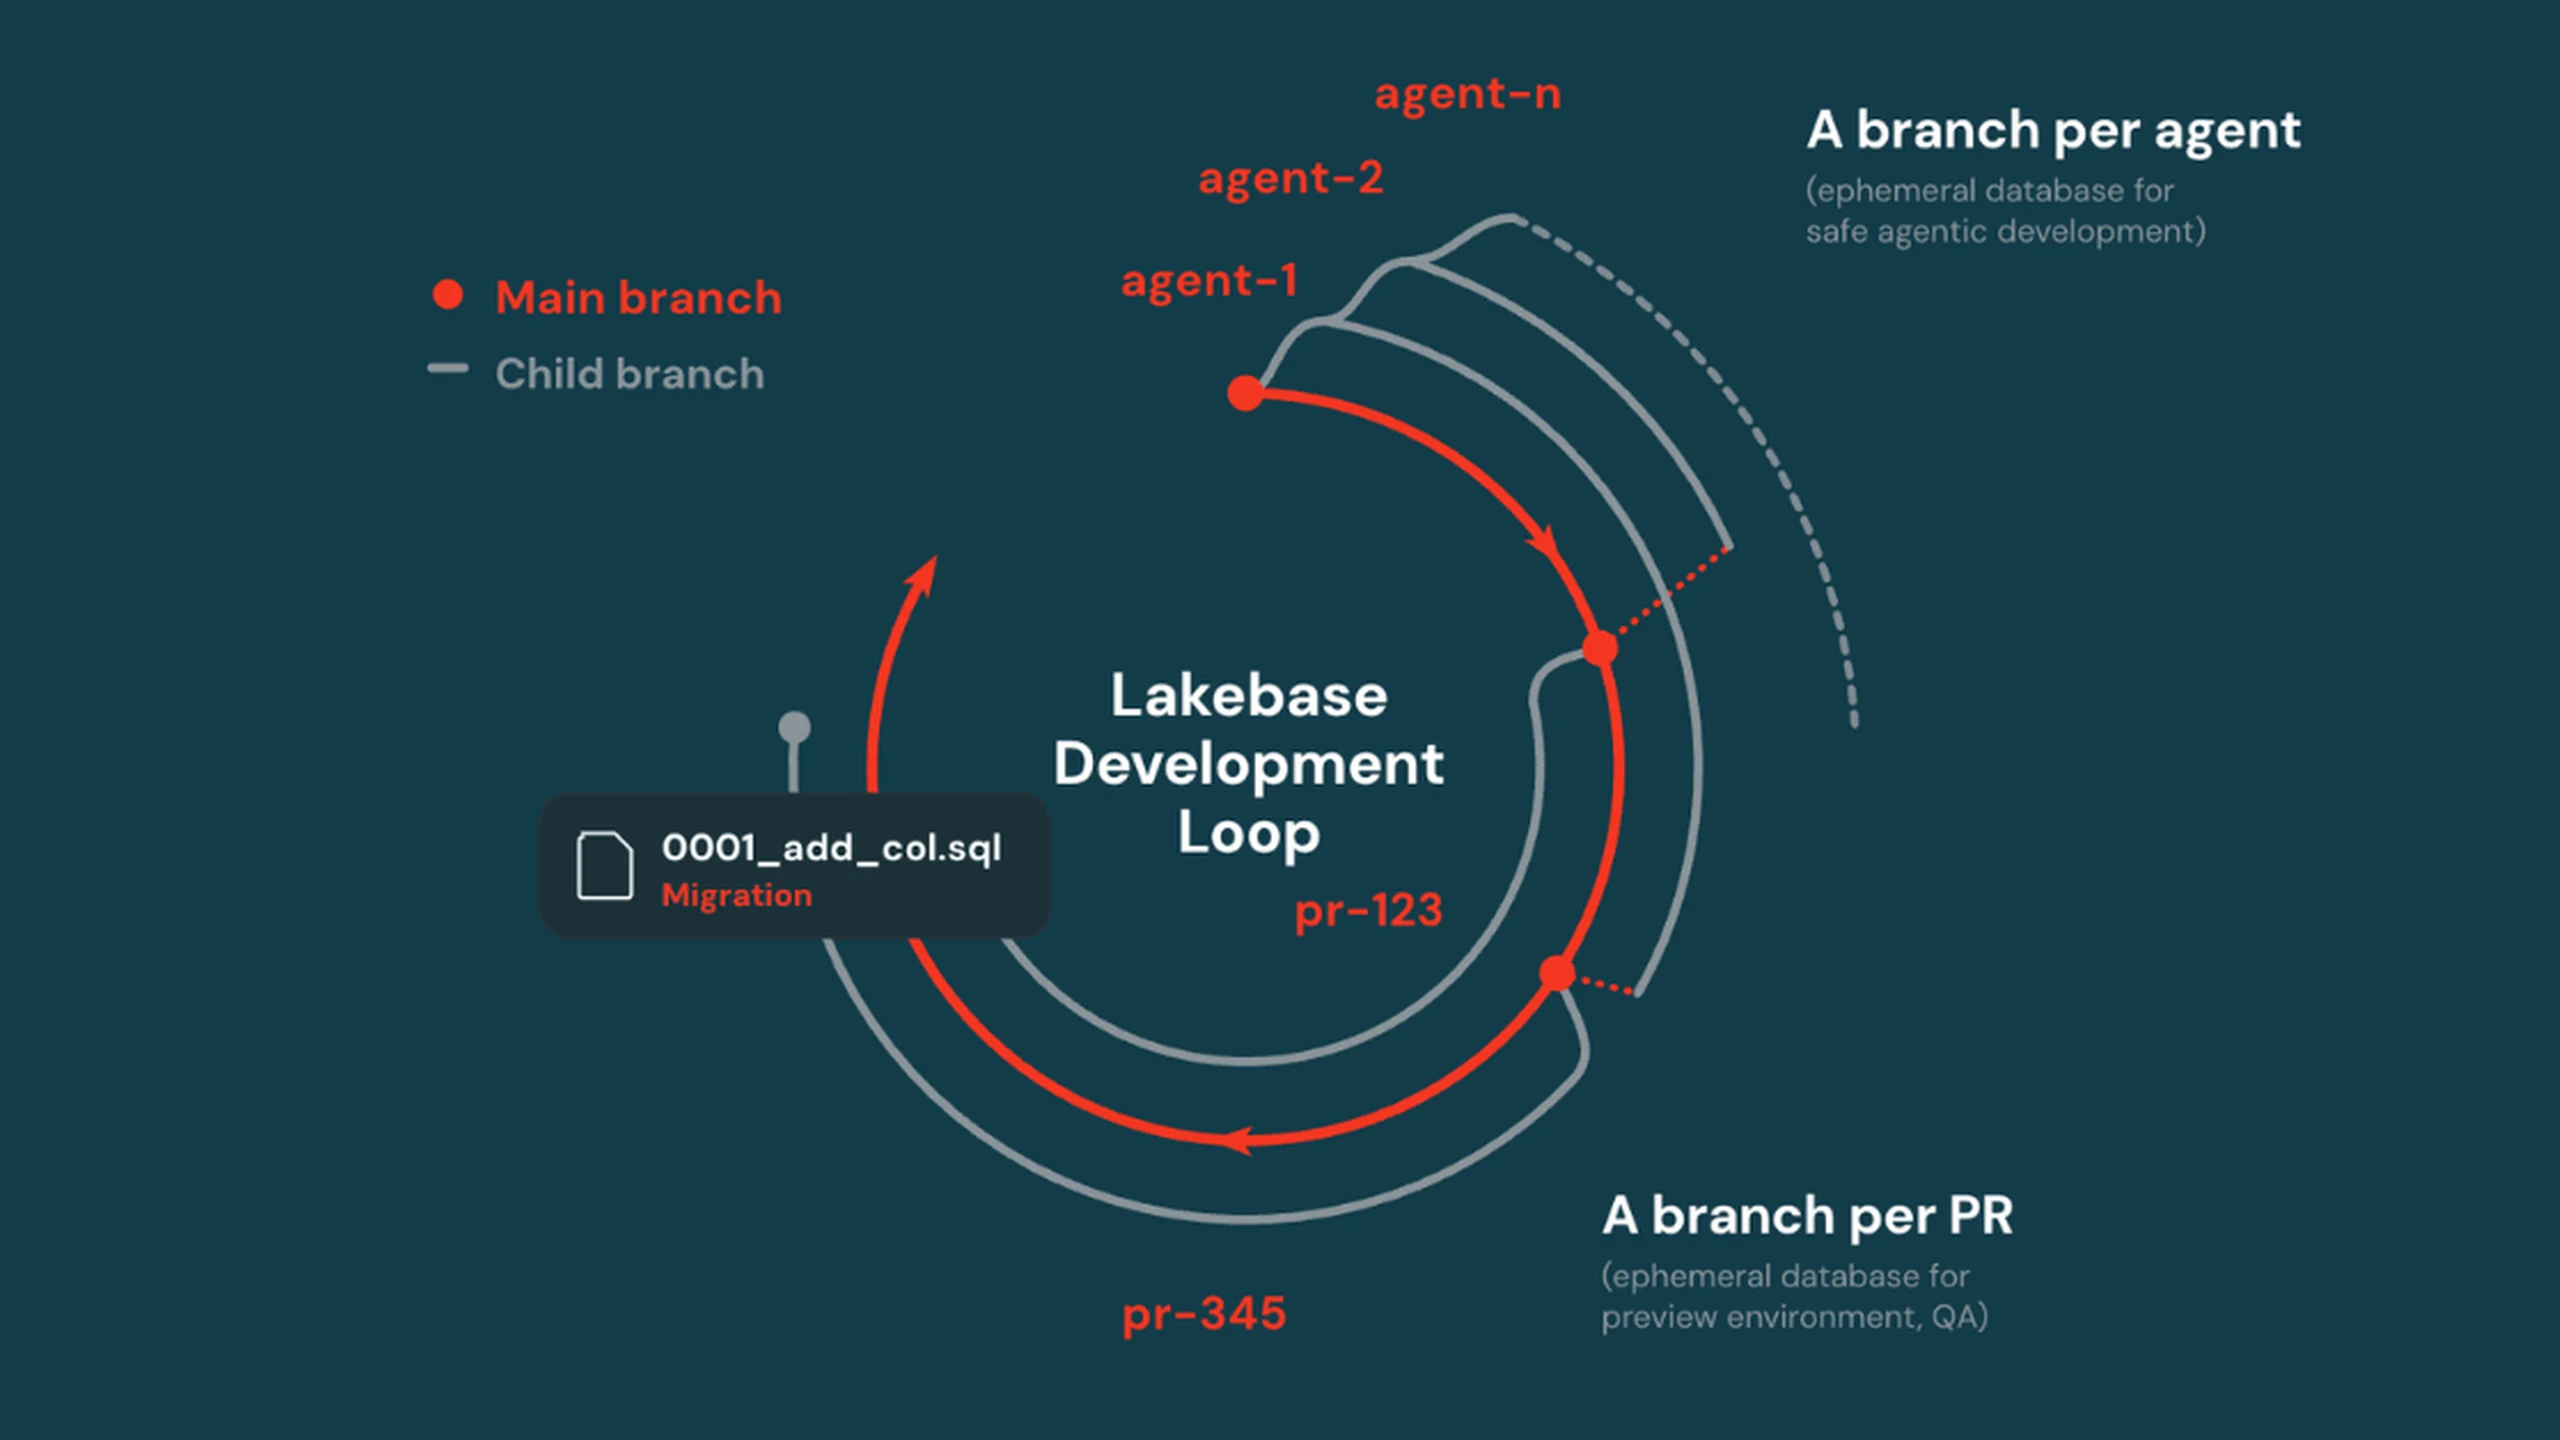
编程智能体即使在自己的 Git 分支中工作,仍可能通过一个共享开发数据库与所有其他任务发生冲突。一次迁移改变结构,一份测试数据被覆盖,失败测试突然便没有明确原因。实用的隔离边界不只是代码仓库检出目录,而是代码加上代码能够改变的状态。
这是一幅注明来源的 Databricks 工作流示意图,用于解释事件背景,不表示每种数据库产品都具有相同的分支行为。
Databricks 将 Lakebase 分支作为一种答案:为编程任务绑定一个可丢弃的数据库分支。Neon 等 Postgres 工作流已有类似模式,而 PlanetScale 则展示了另一项独立纪律:受审查的结构变更推广。实用原则与厂商无关:通过隔离状态使实验可复现,再用经过审查的迁移决定什么可以进入生产。
从任务身份开始
只创建能够追溯的环境。记录智能体运行、仓库提交、拉取请求或工单、父数据库状态、创建时间、负责人、允许使用的工具和到期时间。这样,临时分支才是证据,而不是匿名副本。只有知道两个智能体的初始状态,才能比较它们。
分支应从足够完成任务的最小数据集开始。仅结构、合成或脱敏数据通常比生产派生副本更安全。如果缺陷调查确实需要真实记录,应把访问控制与分支创建分别限制。获准申请环境,不应自动意味着获准读取其中每一行。
为每个任务授予最小权限
数据库分支能够约束写入,却不能约束所有副作用。智能体连接的应用仍可能发邮件、调用支付服务、触发 Webhook、写入对象存储,或使用权限过大的凭据。为任务提供独立、短期的连接身份,拒绝生产目标,并将产生副作用的集成重定向到测试接收端。网络控制和密钥范围是工作区的一部分,不是可选附件。
创建分支时就设置到期时间。写时复制创建成本低,不表示任务产生分歧后,存储、计算、日志和索引都是免费的。自动清理应为事故、审计和法定保留需求记录例外。分支寿命超过任务本身,既是成本问题,也是数据治理问题。
把分支当作评估环境
利用分支在明确的状态上运行迁移、测试和调查。将测试结果、命令和生成的迁移产物与任务记录一起保存。如果多个智能体探索替代方案,应给它们相同的父快照,使结果具有可比性。重置或删除失败环境应当安全,因为任何已接受的生产操作都不依赖它。
这正是数据库分支帮助智能体开发的地方:它防止一个实验悄悄改变另一个实验的条件。但它不能证明所选实现正确。公开分支 API 和文档说明了生命周期控制;团队仍应对自己的分支深度、变更数据量和并发计算做基准测试,而非假设产品演示能预测实际工作负载。
推广指令,而不是实验状态
数据不会像源代码一样合并。两个看似合理的智能体迁移,可能在顺序、兼容性或发布要求上冲突。因此,生产候选应是带有测试、回滚考虑和部署计划的受审查迁移文件,而不是请求将分支记录合并进生产。PlanetScale 的部署审查方法提醒我们:隔离和推广解决的是不同问题。
批准前,应检查与当前已部署应用的向后兼容性、破坏性操作、所需索引、数据回填和部署顺序。权限变更及不可逆结构操作应保留人工审查点。分支测试通过是有力证据,但不能取代运维判断。
衡量隔离边界,而不是分支数量
一个有用的试运行,从受限流程开始:每个拉取请求一个分支,使用脱敏数据,短期到期,且不能对外访问生产系统。衡量共享环境争用、测试可复现性、清理成功率、审查时间和漏到生产的迁移缺陷。不要把智能体创建的数据库数量当作成功指标。
Databricks 的 Lakebase 公告揭示了正确的问题:智能体既需要代码边界,也需要状态边界。可持续的运作模式很简单:识别任务、最小化数据和权限、让环境到期、记录证据,只推广受审查的指令。这样既方便快速实验,也不会让临时数据库状态成为未经治理的生产入口。