
20 de octubre de 2026 —
Las evaluaciones de Amazon AgentCore afrontan el fallo que la supervisión tradicional pasa por alto
El resumen de hoy analiza cómo los equipos pueden evaluar la calidad continuamente, limitar permisos y mantener control humano reversible cuando la IA pasa de responder a actuar. Las fuentes originales permanecen en la página de cada edición.
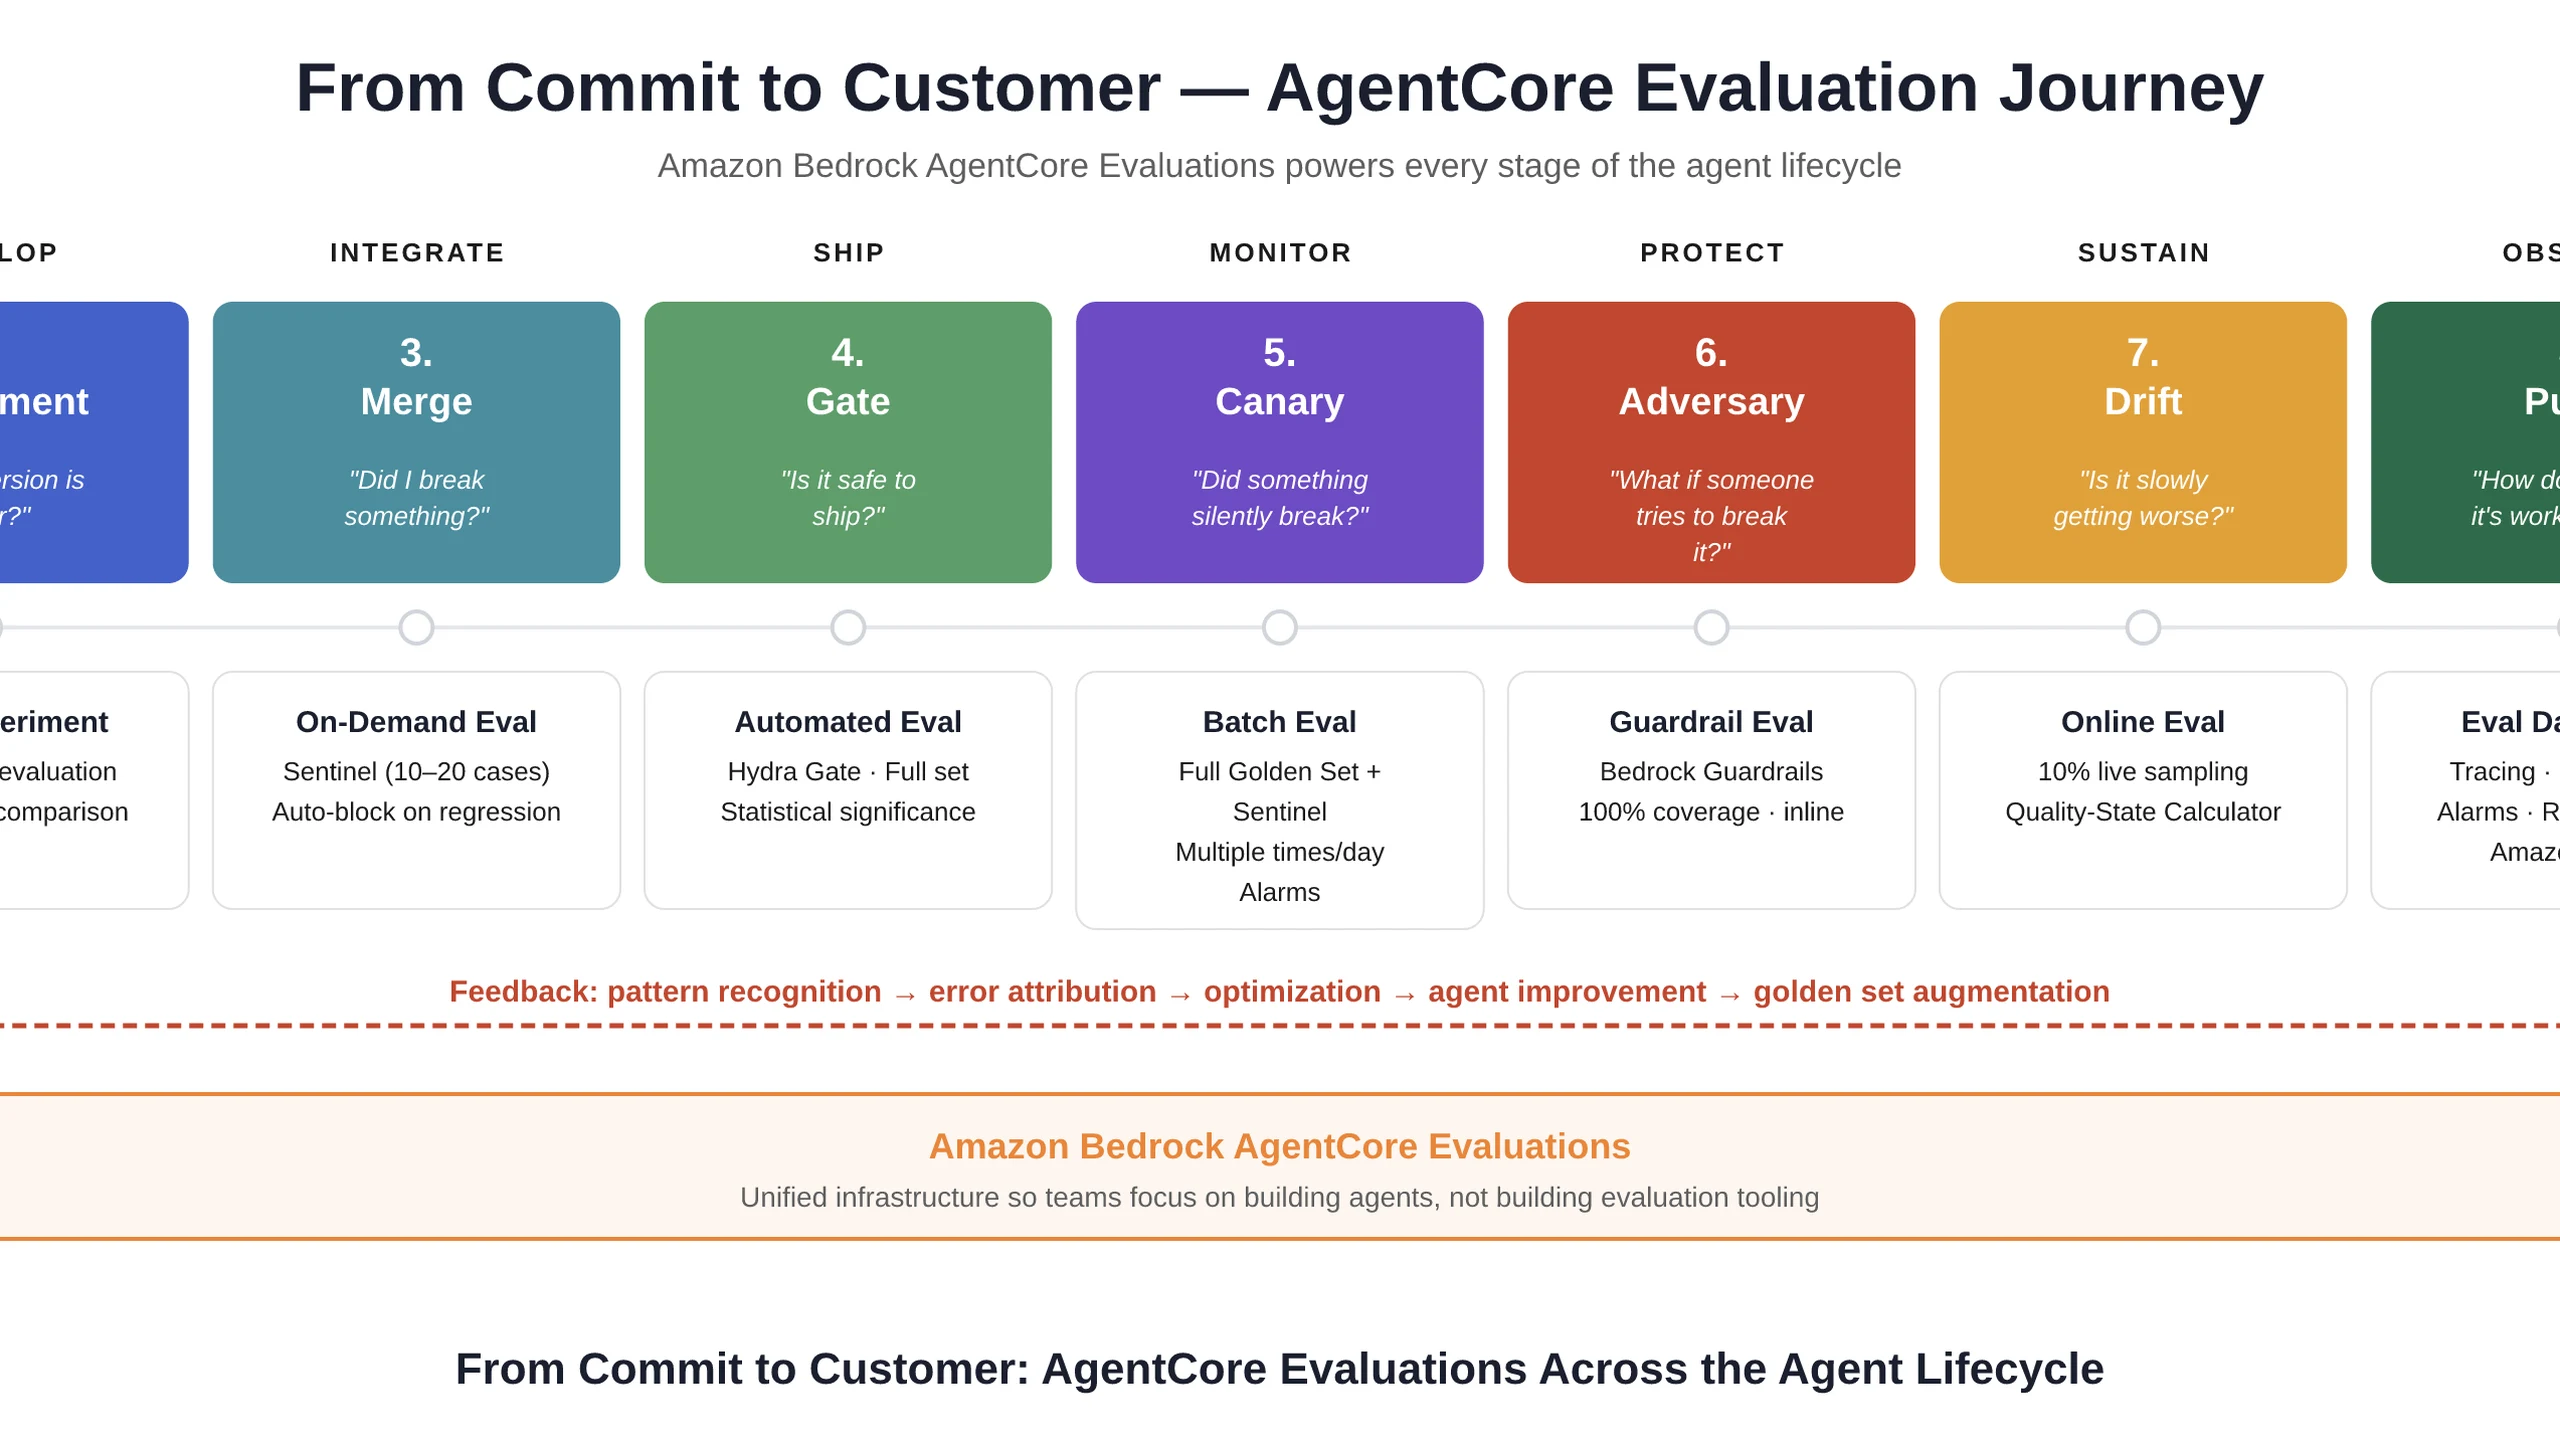
Las evaluaciones de Amazon AgentCore afrontan el fallo que la supervisión tradicional pasa por alto
Las evaluaciones de Amazon AgentCore conectan puertas de CI, canarios, puntuación en vivo y ciclos de retroalimentación para detectar fallos silenciosos de calidad de IA antes de que los usuarios pierdan la confianza
AWS Trust in Depth ofrece más autonomía a los agentes de IA sin ceder el control
AWS Trust in Depth vincula la autonomía de los agentes al acceso delimitado, la aplicación externa de políticas, la identidad, la observabilidad y las pruebas, preservando el criterio humano
NVIDIA Nemotron 3.5 lleva los agentes abiertos de los centros de datos a los escritorios
NVIDIA Nemotron 3.5 lleva agentes multimodales abiertos de los centros de datos a los PC locales, combinando la precisión de Super VL con el despliegue compacto en el edge de Bolt
OpenAI Codex 0.163.0 Convierte la CLI en una Superficie de Control en Vivo
OpenAI Codex 0.163.0 añade configuración en vivo, dirección instantánea, recuperación de daemon, búsquedas paralelas y controles más estrictos para el trabajo prolongado de agentes
Cómo Meta construyó Forum con ingeniería nativa de IA y por qué la verificación superó al volumen de código
Cómo Meta construyó Forum con ingeniería nativa de IA muestra por qué los ciclos de agentes verificados, el código legible y la aprobación humana importan más que una generación de código más rápida
El descubrimiento antimicrobiano de Google Antigravity comprime la búsqueda, pero el laboratorio sigue decidiendo
El descubrimiento antimicrobiano de Google Antigravity convierte búsquedas fragmentadas de proteínas en un flujo de trabajo dirigido por agentes, mientras los resultados de laboratorio siguen siendo la prueba decisiva
La computación de propósito general basada en pruebas con Magnetar cuestiona el equilibrio de los zkVM
La computación de propósito general basada en pruebas con Magnetar aporta ejecución rápida, verificable y resistente a la computación cuántica a Rust, Go y C sin exponer datos privados
El modelo mundial Visko Orbis alcanza el tiempo real en Google Cloud TPUs, pero el reloj nunca se detiene
El modelo mundial Visko Orbis ejecuta vídeo, mejora de resolución y audio en una sola partición TPU, lo que revela por qué la latencia importa más que el rendimiento para mundos de IA en directo
La respuesta a incidentes de superinteligencia de NIST traza una nueva línea entre la autonomía y el control de los agentes
La guía de NIST sobre respuesta a incidentes de superinteligencia establece diez prácticas para detectar, contener, investigar y notificar fallos en el control de agentes
Databricks AI Runtime afronta su verdadera prueba mientras los agentes multiplican los trabajos de entrenamiento
Databricks AI Runtime ahora admite investigación dirigida por agentes con un volumen de entrenamiento ocho veces mayor, poniendo a prueba si la automatización puede escalar sin desperdiciar GPUs