
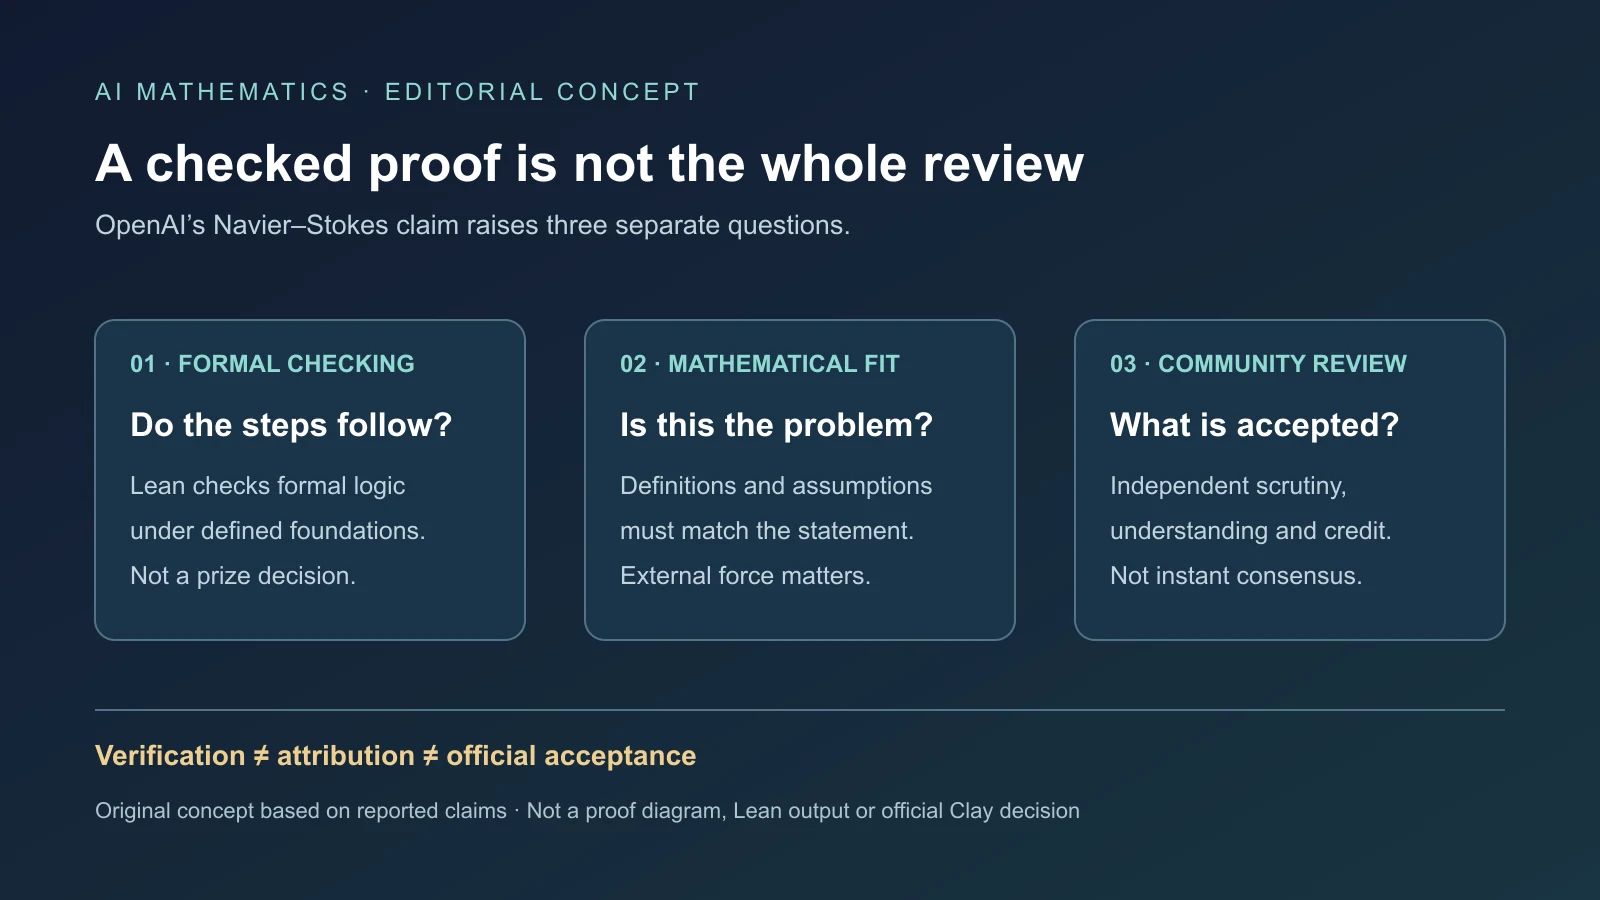
Deklarowany przełom OpenAI dotyczący Naviera–Stokesa łączy kilka ocen w jednym nagłówku. Firma twierdzi, że wewnętrzna AI skonstruowała osobliwość w skończonym czasie w 88 godzin, po czym powstała formalizacja Lean. Zgodność formalnego twierdzenia z oficjalnym problemem, akceptacja specjalistów i podział zasług są odrębnymi pytaniami. Opisywana praca nie ukończyła zwyczajowego przeglądu matematycznego.
Wrześniowe Heidelberg Laureate Forum ujawniło napięcie. Badacze nie bronili jedynie ludzkiego rozwiązywania problemów przed maszynami. Pytali, czy szybkie wytwarzanie sprawdzalnych odpowiedzi daje zrozumienie, uczciwe uznanie i wspólną zdolność naukową, czy pozwala firmom z zamkniętymi modelami określać, co liczy się jako postęp.
Chodzi o precyzyjny kontrprzykład, nie każdy przepływ
Równania Naviera–Stokesa traktują płyn jako ośrodek ciągły, nie śledząc każdej cząsteczki. Pozostają użyteczne w lotnictwie, pogodzie, wodzie i przepływie krwi. Trudne pytanie dotyczy gładkiego trójwymiarowego przepływu nieściśliwego: czy gładkie warunki początkowe zachowują gładkość, czy prędkość może stać się nieograniczona w skończonym czasie? Wygładzająca lepkość utrudnia skonstruowanie dopuszczalnej osobliwości.
OpenAI deklaruje wir spiralnie zwijający się do środka i coraz bardziej rozciągany, ze środkiem kurczącym się przy rosnącej prędkości i skończonej energii całkowitej. Kluczowa jest gładka siła zewnętrzna, która według firmy pozostaje gładka mimo rozbiegania prędkości. Firma wskazuje dwie dopuszczone oficjalnie postacie kontrprzykładu. Nie należy tego przedstawiać jako dowodu wszystkich wariantów bez wymuszenia ani twierdzenia, że równania płynów są po prostu „błędne”.
Według firmy projekt ruszył 1 września 2026 roku po pogłoskach o postępach w pokrewnych równaniach. Nieopublikowany model testowano na wszystkich otwartych Problemach Milenijnych i pytaniach powiązanych. Około 10 000 równoległych agentów badało dowód i obalenie, z narzędziami i ograniczoną wymianą. Wynik miał powstać 5 września, około 88 godzin po starcie; GPT-6 Astra potrzebował dalszych 17 godzin na formalizację i weryfikację Lean.
Dla Naviera–Stokesa OpenAI podało 2,7 mln wiadomości i około 130 mld tokenów wyjściowych, a dla wszystkich prób 4,9 mln i około 300 mld. Te nieaudytowane liczby firmy opisują dużą skoordynowaną eksplorację propozycji, porażek i sprawdzeń, nie pojedynczy prompt. Model generujący miał być silniejszy od publicznej Astry, więc publikacja artykułu i dowodu nie umożliwia zwykłym użytkownikom powtórzenia poszukiwań.
Co sprawdza Lean, a czego nie rozstrzyga
Lean opisuje matematykę jawnymi definicjami i regułami oraz sprawdza wynikanie kroków z przyjętych podstaw. Może zamknąć luki przeoczone w prozie. Eksperci nadal muszą potwierdzić, że zakodowane twierdzenie i założenia odpowiadają właściwemu problemowi. Wewnętrzna spójność formalna nie tworzy automatycznej zgody o zakresie i interpretacji.
Weryfikator nie przyznaje też pierwszeństwa, nie rekonstruuje pochodzenia strategii ani wystarczającego uznania autorów. Nie czyni argumentu pouczającym ani nie ocenia możliwości nauczania, ponownego użycia i rozwijania metod. Długi formalny dowód może być poprawny, choć niewiele osób rozumie jego konstrukcję. To problem zrozumienia, nie powód odrzucenia komputerów.
Zasady Clay wymagają kwalifikowanej publikacji, szerokiej akceptacji i co najmniej dwóch lat rygorystycznego badania przed szczegółową oceną nagrody. OpenAI nie zamierza się o nią ubiegać. Rezygnacja z pieniędzy nie skraca przeglądu ani nie tworzy natychmiastowego konsensusu. Specjaliści nadal muszą porównać formalne twierdzenie, czytelną konstrukcję i wcześniejsze prace.
Geordie Williamson ostrzegał przed oddzieleniem rozwiązania od zrozumienia, gdy kariery nadal nagradzają rozstrzygnięte pytania. Jacob Tsimerman podkreślał szybki rozwój zdolności i wagę rozwiązania Naviera–Stokesa. Peter Scholze kwestionował samoistną wartość szybszej produkcji, gdy brakuje już zrozumienia. To różnice dotyczące treści postępu, nie prosty podział optymizmu i lęku.
Zarzuty o pierwszeństwo nie obalają technicznie dowodu
OpenAI wiązało początkowe pogłoski z Tristanem Buckmasterem z NYU i pracownikiem Anthropic Leventem Alpöge. Pracowali nad pokrewnym wymuszonym problemem Eulera. Równania Eulera pomijają lepkość, więc projekt nie jest wymienny z deklaracją Naviera–Stokesa. OpenAI twierdzi, że agenty wcześniej niezależnie uzyskały wynik Eulera bez wymuszenia, innymi metodami, jednocześnie przyznając pokrewną strategię wymuszania w szerszym podejściu.
Firma zaprzecza, by ktokolwiek widział prywatną pracę pary przed ukończeniem. Mówi też, że dochodzenie wewnętrzne wykluczyło wpływ wcześniejszych promptów Codex Buckmastera przez trening lub inną drogę. Buckmaster kwestionował przebieg zdarzeń, presję, autorstwo i komunikację. Scientific American relacjonował jego przekonanie, że OpenAI dowiedziało się o postępach przed własnym wynikiem; matematyk firmy Sébastien Bubeck zaprzeczył użyciu ich promptów lub dowodów.
Wcześniejsze wkłady w metody wymuszania Diego Córdoby i Luisa Martíneza-Zoroi także należą do historii. Córdoba powiedział, że deklarowane ukończenie ich zaskoczyło. Zaawansowana matematyka rozwija się przez metody, częściowe wyniki, rozmowy i czasem nieopublikowane pomysły. Uznanie wskazuje nowość i wpływa na pracę, granty, zaproszenia i pozycję. Przypisanie wszystkiego jednemu modelowi ukrywa łańcuch.
Należy oddzielić dwie kwestie. Publiczne dowody nie rozstrzygnęły niewłaściwego dostępu do nieopublikowanych materiałów, któremu OpenAI zaprzecza. Krytyka komunikacji, przypisania zasług lub nierównej władzy nie wymaga udowodnienia takiego dostępu. Williamson ostro krytykował zachowanie, Michael Harris opisywał relacje przedstawiające firmę jako wywierającą presję i naruszającą normy; OpenAI nie skomentowało przed publikacją IEEE. Oceny te nie obalają twierdzenia, tak jak uprzejmość nie potwierdza błędnego dowodu.
Zamknięte zasoby zmieniają konkurencję badawczą
Matematyka daje firmom atrakcyjne próby, bo formalne odpowiedzi sprawdza się obiektywniej niż eseje czy prognozy, a słynne problemy dają rozgłos. Anthropic miał testować wewnętrzny Claude na hipotezie Riemanna, bez jej rozwiązania, ale z postępem nad pokrewnym oszacowaniem. Google i specjalistyczne projekty zajmują się dowodzeniem, formalizacją i odkrywaniem. Nie są to wszystko ukończone rozwiązania milenijne.
Scholze obawiał się, że benchmarki i reklama skierują uwagę na rozpoznawalne mety. Budowanie teorii, łączenie dziedzin i wyjaśnianie pojęć może dojrzewać dekady bez jednego słynnego końca. Jeśli granty i rekrutacja pójdą za widocznymi wynikami maszyn, ważne naukowo prace mogą stracić wsparcie.
IEEE opisywał obawy Mity Ramabulany po dwóch ogłoszonych postępach nakładających się na jego badania: ktoś może podać problem badacza modelowi i opublikować pierwszy. Doktorantka kryptografii Ailsa Robertson mówiła o dużych wydatkach kolegów na dostęp i poczuciu konieczności używania modeli przy walce o te same posady. Relacja podała też ofertę 100 000 licencji OpenAI na modele graniczne dla akademików.
Programy dostępu pomagają, ale pozostawiają asymetrię: uczelnia używa publicznych narzędzi firmy konkurującej silniejszymi systemami wewnętrznymi. Drogie instrumenty od dawna tworzą nierówność, jednak publiczne i międzynarodowe laboratoria mają inne zarządzanie niż zamknięte usługi mogące się zmieniać, odbierać dostęp lub zatrzymywać najlepsze możliwości. Niski dotąd próg sprzętowy matematyki się zmienia.
Sygnały autorstwa i rekrutacji wymagają więc ujawniania procesu. Zwykły format artykułu może ukrywać różną automatyzację eksploracji, formalizacji i odkrycia oraz nierówny dostęp. Czasopisma i uczelnie potrzebują pochodzenia rozróżniającego zwykłą pomoc od wkładu merytorycznego, nie zrównania wszystkich użyć modelu.
Weryfikacja potrzebuje czytelnego i odpowiedzialnego procesu
Matematyka już akceptuje obliczenia, od wyczerpującego sprawdzania twierdzenia o czterech barwach po duże projekty asystentów dowodów. Nowa presja dotyczy skali: formalne obiekty mogą przychodzić szybciej, niż eksperci je pojmują, tworząc zaległość audytu i wyjaśnień. Ludzie tłumaczą wtedy więcej pracy maszyn, a bodźce nadal nagradzają końcowe rozwiązania.
Perspektywa Tsimermana pozwala ludziom wybierać pytania i łączyć struktury, gdy systemy eksplorują. Williamson pyta, czy kariery nie będą optymalizować produkcji maszynowej. Torsten Hoefler przewidywał automatyzację wszystkiego sprawdzalnego. To prognoza, nie dowód wyboru wartościowych pytań, pouczających wyjaśnień lub kierunków interesu publicznego.
Dotyczy to też kodu, układów chipów i obliczeń: poprawny artefakt może być trudny w utrzymaniu lub pozbawiony jawnej historii rozwoju. Notatki, odrzucone hipotezy, źródła i decyzje ludzi nabierają znaczenia przy szybkim finale. Zarządzanie wiedzą zachowuje kontekst, ale nie ustala norm nauki czy autorstwa.
Warstwowa publikacja mogłaby dawać formalny dowód, czytelne wyjaśnienie, pochodzenie i niezależną replikację. Poufna ocena ekspertów przed wielkim ogłoszeniem zwiększałaby wiarygodność kosztem przewagi rozgłosu. Dostęp zewnętrzny do mocnych narzędzi i infrastruktury wspierałby reprodukcję większą niż sprawdzenie gotowego dowodu. To propozycje silniejszych instytucji, nie odrzucenia automatycznych odkryć.
Pozostają trzy testy: niezależne potwierdzenie zgodności twierdzenia i konstrukcji z Clay, zrozumiały łańcuch źródeł, decyzji i interwencji zamiast milionów surowych wiadomości oraz powtarzane zaakceptowane odkrycia z metodami do ponownego użycia. Dostęp, ujawnianie w czasopismach i rekrutacja pomogą określić, czy zamknięta zdolność stanie się wspólną matematyką. Do tego czasu wynik pozostaje przypisaną firmie deklaracją z materiałami, nie oficjalnie zakończonym rozwiązaniem.
Źródła
Twierdzenie OpenAI · Zasady Nagrody Milenijnej · Dyskusja w Heidelbergu · Niezależna relacja o sporze · Kontekst wiedzy · Analiza IEEE Spectrum