
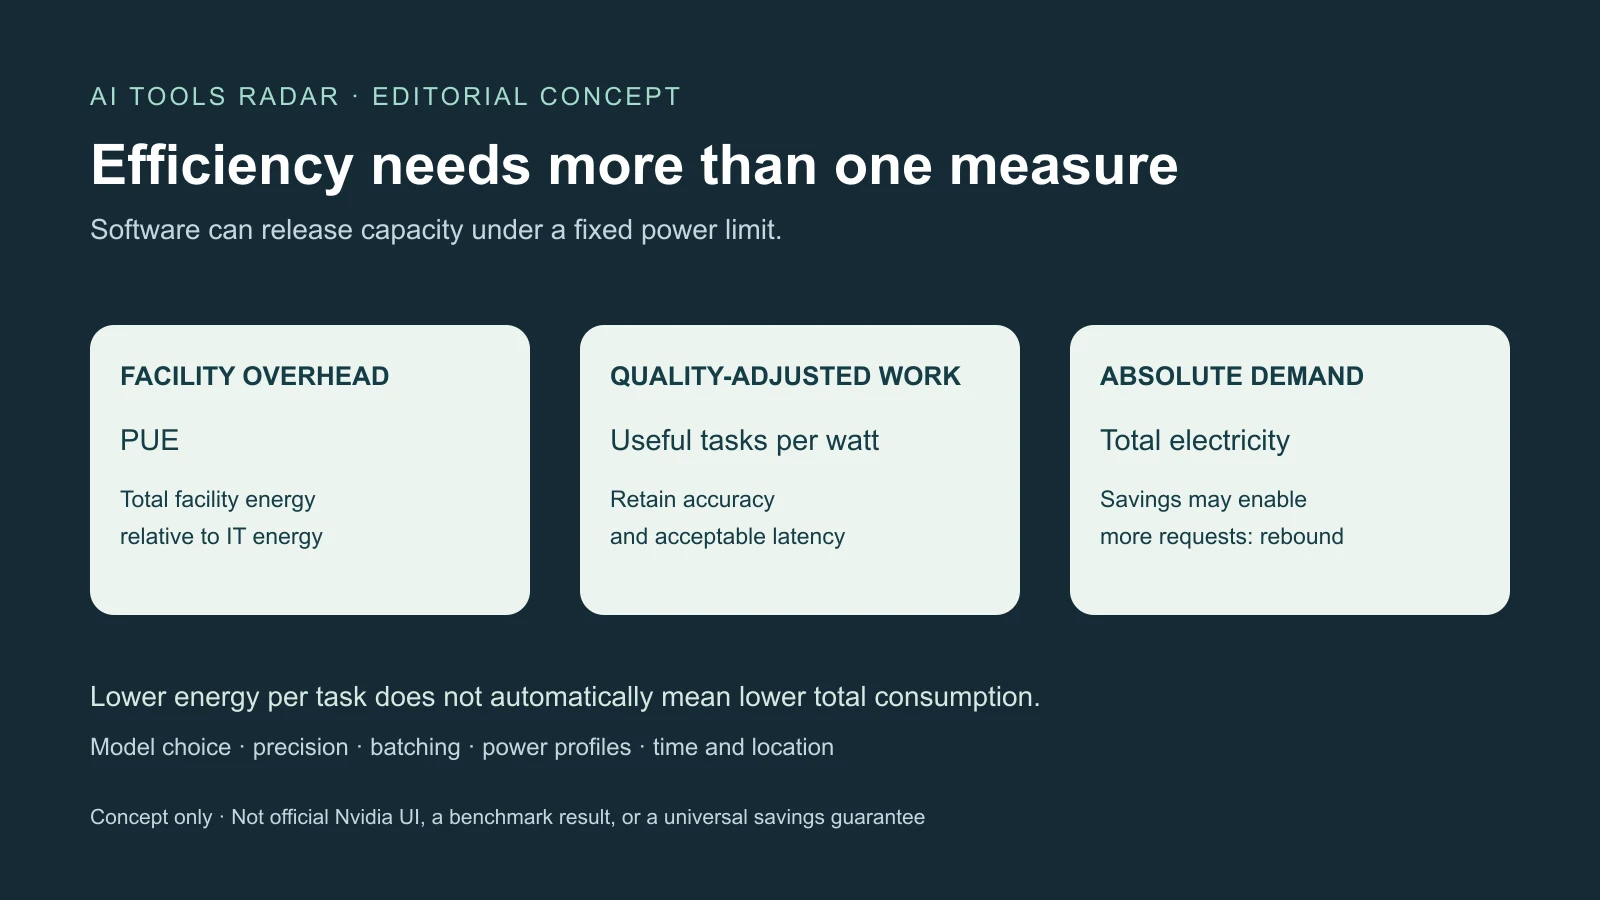
Un centro IA limitado por energía no crece solo comprando GPU. Software decide modelo, trabajo, esperas y momento del consumo. Investigadores sostienen que cambiar decisiones libera capacidad instalada antes que sustituir chips o conectar nueva potencia.
Hardware, refrigeración y red siguen necesarios. La pregunta pasa de rendimiento anunciado por vatio a trabajo útil completado en el límite real y a usar ahorros para reducir demanda o ampliar producción.
PUE mide el edificio, no el valor del cálculo
PUE divide energía total entre la entregada a TI. Cerca de 1,0 significa poco enfriamiento, iluminación y conversión, no que todo cálculo importe. Buen PUE convive con modelos excesivos, tokens innecesarios y servidores medio ociosos.
Uptime Institute informó media ponderada 1,54 en 2025 y poca mejora por sexto año, por instalaciones antiguas y límites regionales en parte. IEA estima servidores en 60% del consumo moderno, almacenamiento y red menores, refrigeración desde 7% en hyperscalers eficientes hasta más de 30% en empresas menos eficientes.
Son contextos y denominadores diferentes, no porcentajes universales que sumar. El edificio no soluciona desperdicio de aplicaciones. Modelo, precisión, lote, longitud, ajustes y calendario determinan productividad del rack.
Jae-Won Chung, Michigan y ML.Energy, une hardware, sistemas, algoritmos y aplicaciones. Código cambia antes de fabricación, compra, instalación y pruebas. Bajo techo fijo, más peticiones o menos espera equivalen a capacidad sin subir pico.
El pronóstico global encuentra límites locales
IEA estima 415 TWh en 2024, 1,5% mundial, tras media anual 12% en cinco años. Escenario base alcanza 945 TWh en 2030, poco menos de 3% y algo más que Japón actual.
EEUU y China añadirían 240 y 175 TWh respecto a 2024. Servidores acelerados crecen 30% anual y casi mitad del incremento; convencionales e infraestructura con refrigeración, un quinto cada uno aproximadamente.
Son escenarios, no resultados medidos. La media oculta concentración: un centro abre en dos–tres años y generación, líneas y subestaciones tardan más. El escenario eficiente presta en 2035 iguales servicios con más de 15% menos corriente gracias al conjunto de software, hardware e instalaciones.
Amazon, Google, Meta, Microsoft y proveedores buscan contratos, renovables, nuclear, generación propia, racks densos y chips propios. Exigen tiempo o dinero. Routing y calendario son otra palanca; compradores ven cuotas, latencia y acceso a modelos sin factura individual de electricidad.
Ahorros distintos usan mecanismos diferentes
Perfiles Blackwell Nvidia cambian frecuencias de cálculo y memoria, límites, caché y NVLink. El proveedor afirma hasta 15% menos energía conservando al menos 97% de rendimiento y hasta 13% más throughput limitado por potencia. Depende de carga, no garantiza toda instalación.
Máximo reloj puede costar demasiado por poco rendimiento. Reducir selectivamente conserva salida y libera electricidad a otras GPU. Ahorro y mayor throughput son comparaciones distintas bajo restricciones.
ML.Energy probó Qwen3-235B-A22B-Thinking en FP8 frente a bfloat16 con un tercio menos energía en problemas estudiados. Menor precisión puede cambiar exactitud; importan modelo, hardware e implementación. No prueba ahorro idéntico sin pérdida para toda cuantización.
Entrenamiento tiene holgura de sincronización: partes rápidas esperan lentas. Perseus ralentiza componentes menos cargados para acabar junto al cuello, no todo el trabajo. La investigación informa hasta 30% menos energía sin perder throughput en su configuración.
Arriba se pueden cachear repeticiones, enrutar rutina a modelos pequeños, comprimir entradas, limitar salidas y agrupar. Compiladores fusionan operaciones y reducen movimiento de datos energívoro. Instancias correctas y retirada de racks antiguos reducen base ociosa; Chetan Visrolia de SHI los considera objetivos prácticos.
No es producto único ni porcentajes sumables. Eliminan trabajos diferentes que no mejoran resultados, preservando calidad y servicio necesarios.
Tiempo y lugar ayudan sin cortar todo consumo
Interacción necesita rapidez; evaluación, procesamiento y parte de entrenamiento esperan. Desplazar tiempo evita picos, lugar usa regiones libres. Sophie Hall, ETH Zurich, combina planificación previa y tiempo real en Google con garantías de rendimiento.
Una MWh con exceso renovable difiere del pico nocturno. Prueba 2026 National Grid, Nvidia, Emerald AI y EPRI reportó un operador a 66% de demanda en menos de un minuto y otro ensayo al 10% durante diez horas.
Son demostraciones separadas, no tolerancia de toda carga comercial. Conexión interrumpible puede dar acceso antes a cambio de capacidad temporal reducida, pero requiere acuerdos de eléctrica, regulador y operador.
Una revisión Nature Reviews Clean Technology estima 10% menos emisiones de ciclo vital en redes muy renovables alineando operaciones. Energía, carbono y agua pueden chocar: ahorrar agua a veces aumenta emisiones. Cantidad, horario, carbono, estrés hídrico, latencia y lugar de datos son variables distintas.
Grandes flotas tienen opciones, pequeñas pueden diferir lotes, quitar ociosidad y elegir modelos. Desarrolladores deben declarar necesidades reales: marcar urgente algo flexible reserva capacidad innecesaria. Flujos acotados y contexto reutilizable quitan repetición antes del programador.
Calidad, privacidad y rebote limitan conclusiones
Energía por token no basta si hay más tokens inútiles. Por tarea aceptable completada refleja modelos y reintentos mejor. Utilización alta puede producir poco valor; mala precisión o ruta añade errores y escaladas.
Caché respeta confidencialidad y vigencia, geografía soberanía. Transferencias grandes cuestan tiempo, red, electricidad y riesgo. La interacción no espera horas por renovables; interrumpir entrenamiento necesita checkpoints y recuperación.
Rebote de Jevons puede absorber ahorro absoluto. 15% menos por inferencia permite más solicitudes con el centro a toda potencia. Es producción útil, no necesariamente menos electricidad o emisiones. Eficiencia sola no garantiza alivio local.
Quitar desperdicio o aumentar tokens por julio no justifica toda tarea. No sustituye generación, transmisión ni enfriamiento; IEA ya supone mejoras generales. Operadores necesitan trabajo por vatio ajustado a calidad y consumo absoluto.
Faltan datos comparables. Medias seleccionadas y cargas favorables ocultan mezcla. Pruebas independientes iguales deben medir calidad, latencia, utilización y energía. Omitir exactitud premia degradación; omitir latencia configuraciones imprácticas.
La prueba está en operar
Tres avances apoyarían software: datos reproducibles entre modelos, precisión y potencia; conexiones flexibles comerciales más allá de ensayos; claridad sobre el uso de capacidad liberada.
Aplazar obras o reducir picos ayuda la red. Convertir todo ahorro en más respuestas de IA soluciona sobre todo la escasez de cómputo. Ambos pueden ser éxitos, pero responden preguntas distintas y no merecen igual promesa ambiental incondicional.
Software cambia antes que subestaciones y mejora capas juntas. La prueba no es un porcentaje de laboratorio, sino más trabajo aceptable por vatio, menos despliegues bloqueados, flexibilidad útil y demanda absoluta transparente.
Fuentes y lecturas relacionadas
Encuesta Uptime Institute · Previsión energética IEA · Investigación Perseus · Revisión de sostenibilidad IA · Lectura: flujos de IA · Noticia de eficiencia software