
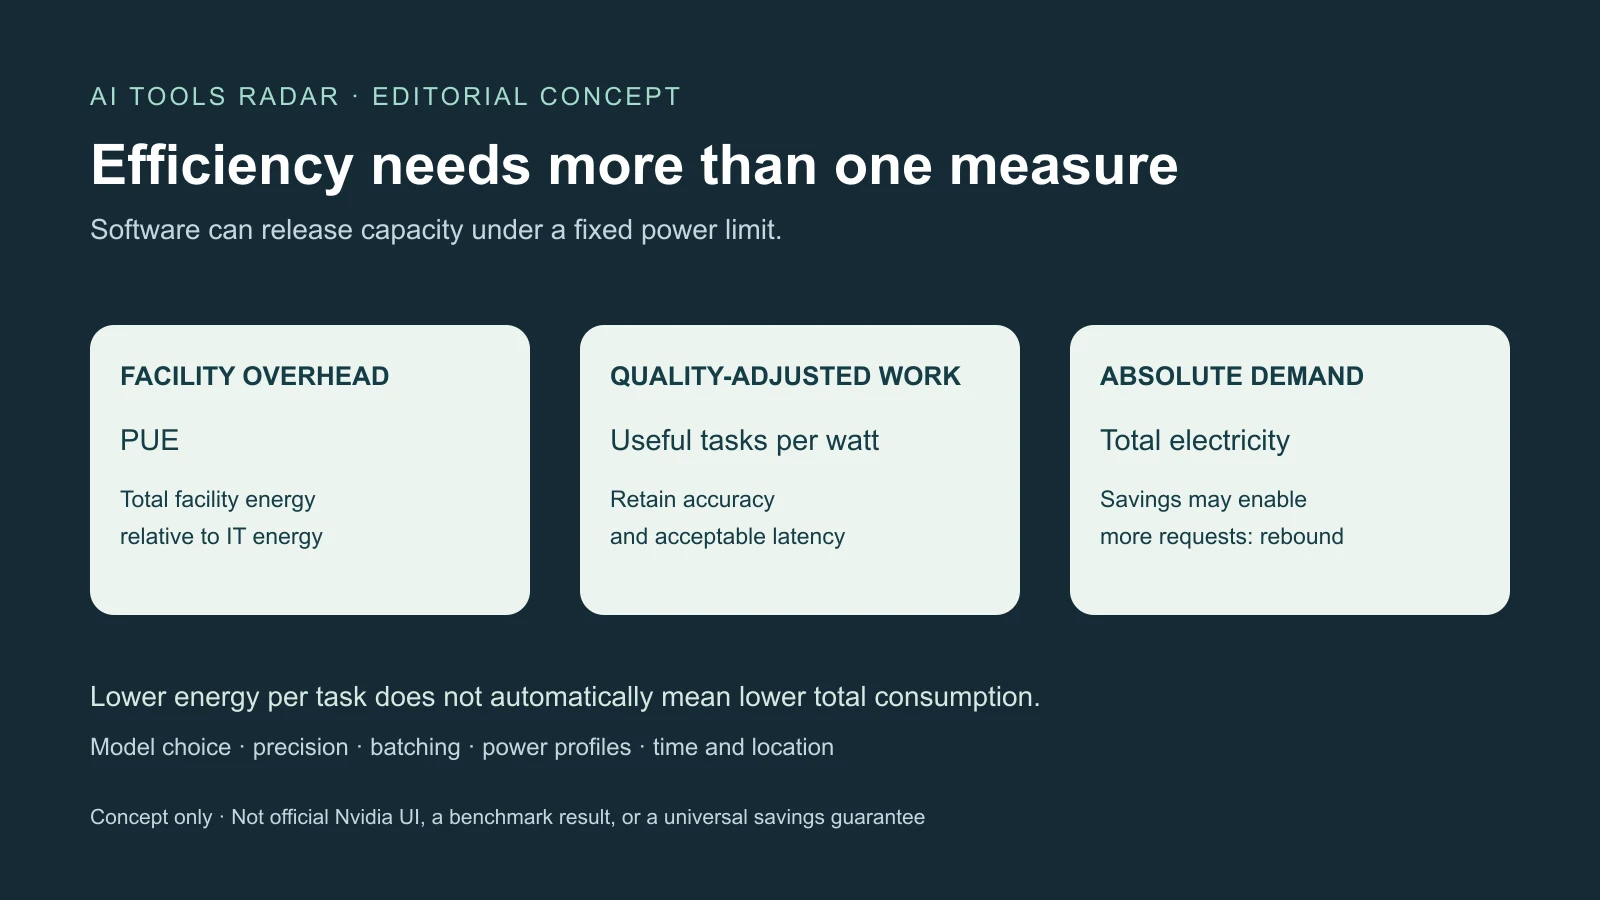
受限于电力的AI设施,不能只靠多订GPU扩张。软件决定运行哪个模型、做多少工作、加速器如何等待、任务何时用电。研究者认为,改变这些选择可从既有硬件释放容量,速度快于更换芯片或接入新电源。
这不让硬件、冷却或电网投入过时,而是把问题从处理器宣称的每瓦性能,转向实际电力上限内完成多少有效任务,以及运营者把节省用于减需求还是增产出。
PUE测量建筑边界,不衡量计算价值
电能使用效率PUE是设施总能耗与IT设备能耗的比值。接近1.0表示冷却、照明、转换开销小,不代表每次计算必要。优秀PUE仍可伴随过大模型、多余词元和部分闲置服务器。
Uptime Institute的2025年调查给出加权平均1.54,连续第六年改善很少,部分原因是旧设施和区域冷却限制。IEA估计现代中心服务器约占用电60%,存储、网络较少;冷却则从高效超大中心约7%,到较低效企业设施超过30%。
这些是不同分母和场景,不应相加成统一设施配比。它们说明仅改善设施开销不能解决应用浪费。模型、精度、批量、输出长度、处理器设置与调度,决定进入机架的电如何变有效工作。
密歇根大学、ML.Energy相关研究者Jae-Won Chung把硬件、系统、算法、应用视为相连层。代码与调度快于制造、采购、安装、测试。在固定电力上限内,额外请求或更少等待可以像增加容量,但峰值负载不必上升。
需求预测是全球的,电网瓶颈却是本地的
IEA估计2024年数据中心约415TWh,占全球用电1.5%,此前五年年均增12%。基本情景到2030年约945TWh,略低于全球3%,略超过日本目前用电。
美国、中国贡献大量增量,较2024年分别增加约240、175TWh。加速服务器用电预计年增30%,贡献净增近一半;传统服务器与包含冷却的基础设施各约五分之一。
这些是情景预测,不是已测得的2030年结果。全球占比还掩盖区域集中:中心可两三年建成,发电、输电、变电站却常更久。IEA高效率情景通过软件、硬件和设施共同改善,到2035年以少15%以上电力提供相同数字服务。
Amazon、Google、Meta、Microsoft和AI提供者追求长期电力、可再生、核能协议、现场发电、密集机架与定制芯片,均需时间或投入。软件路由、调度是另一杠杆;企业用户即使无每次推理电费,也通过配额、延迟、模型可用性感受限制。
不同节省数字有不同机制和条件
Nvidia Blackwell功耗配置可调计算与内存频率、限额、缓存和NVLink状态。厂商称最多省15%能耗、保留至少97%总体性能,受电力限制设施吞吐最多增13%。这取决于负载,不是每次安装保证。
最高频率可能只多一点性能却多耗很多电。选择性降速可保留大部分产出,为其他加速器腾出电,在机架层提升吞吐。节能与吞吐提升是不同受约束比较。
ML.Energy测试Qwen3-235B-A22B-Thinking,在所测解题任务上,用FP8代替bfloat16约少三分之一推理能耗。低精度可改变准确性,模型、硬件、实现均有影响,不能推成所有量化任务同省且无损。
训练存在同步余量:部分组件先完成,等待较慢组件。Chung的Perseus让工作较少者适当减速,与瓶颈同步结束,而非把全部作业变慢。论文在研究配置下最多省30%能耗,不降低吞吐。
更上层可缓存重复计算、把简单请求给小模型、压缩提示、限制输出和批处理。编译器融合运算、减少数据搬运,后者也耗电。适配实例大小、退役旧机架可减少闲置基线;SHI专家Chetan Visrolia把旧设备视为实用目标。
这些不是一款产品,也不能把百分比相加;各自针对不改善结果的计算。只有保住所需质量与服务,节省才有意义。
时间和位置有价值,但不必降低所有用电
交互助手需快答,评估、数据处理、部分训练可以延迟。时间迁移避开高峰,地理迁移转到有电与算力区域。ETH Zurich博士研究者Sophie Hall对Google机群的研究结合日前规划和实时调度,同时保性能要求。
可再生过剩时的一兆瓦时与晚高峰瓶颈时的影响不同。2026年National Grid、Nvidia、Emerald AI和EPRI试验展示快速响应:一运营者一分钟内把需求降至约66%,另一试验以10%容量运行十小时。
这是分别报告的演示,不证明所有商用负载都可接受这样的削减。可中断连接可能以临时算力受限换取更早接电,但需要电力公司、监管和运营方协议。
Nature Reviews Clean Technology综述估计,高可再生电网中随网调度可减约10%生命周期排放,也指出能源、碳、水目标可冲突,某些条件下少用水会多排放。电量、时点、碳强度、水资源紧张程度、延迟、数据地点是不同变量。
全球机群选择更多,小运营者仍可延后批作业、减少闲置、选适当模型。开发者注明真实服务需求也有帮助,把可等任务标急会无谓占即时容量。范围明确的工作流、可复用上下文,在基础设施调度前就可减少重复。
质量、隐私与反弹限制结论
每词元能耗不足以衡量系统,因为它可能生成更多无用词元。每个合格完成任务的能耗,更能反映模型差异和重试。高利用率可能只是处理低价值请求;错误路由或精度损失也会触发重试、后续升级。
缓存须顾及机密与时效,跨地域受数据主权限制。大数据迁移消耗时间、网络、电力,也有运行风险。交互任务不能为清洁电等数小时,训练中断则需可靠检查点与恢复。
杰文斯式反弹可能吸收绝对节省。每次推理省15%,可能让设施在同样满额电力下多接请求。这是有效增产,不必等于总用电或排放下降,因此仅有效率标准未必缓解本地电网。
消除浪费、提高每焦耳词元,也不能证明每项任务值得耗电。优化不替代发电、输电、冷却,IEA情景也假设广泛改善。运营者需同时看质量调整后的每瓦有效工作和设施绝对用电。
可比数据仍稀少。选择性机群平均或有利内部负载会隐藏结构变化。独立同任务试验应同时报告质量、延迟、硬件利用和能耗;忽略准确率奖励降质,忽略延迟则奖励不实用配置。
要看的证据是实际运营
三种发展能支持软件路线:跨模型、精度、功耗的可复现实负载报告;超越演示的商业柔性接电;以及运营者如何使用释放容量的证据。
降低任务能耗若延缓建设、减少峰值,有助电网;若全部立即变成更多生成,主要解决算力稀缺。两者都可能是工程成功,却不能共用无条件可持续性宣传。
软件快于变电站、电厂,可同时改进多层。检验不是某实验室百分比,而是每瓦完成更多合格任务、更少因缺电受阻的部署、有用电网弹性,以及透明绝对需求数据。
来源与延伸阅读
Uptime Institute调查 · IEA能源预测 · Perseus研究 · AI可持续性综述 · 延伸:范围明确的AI工作流 · 软件效率报道