
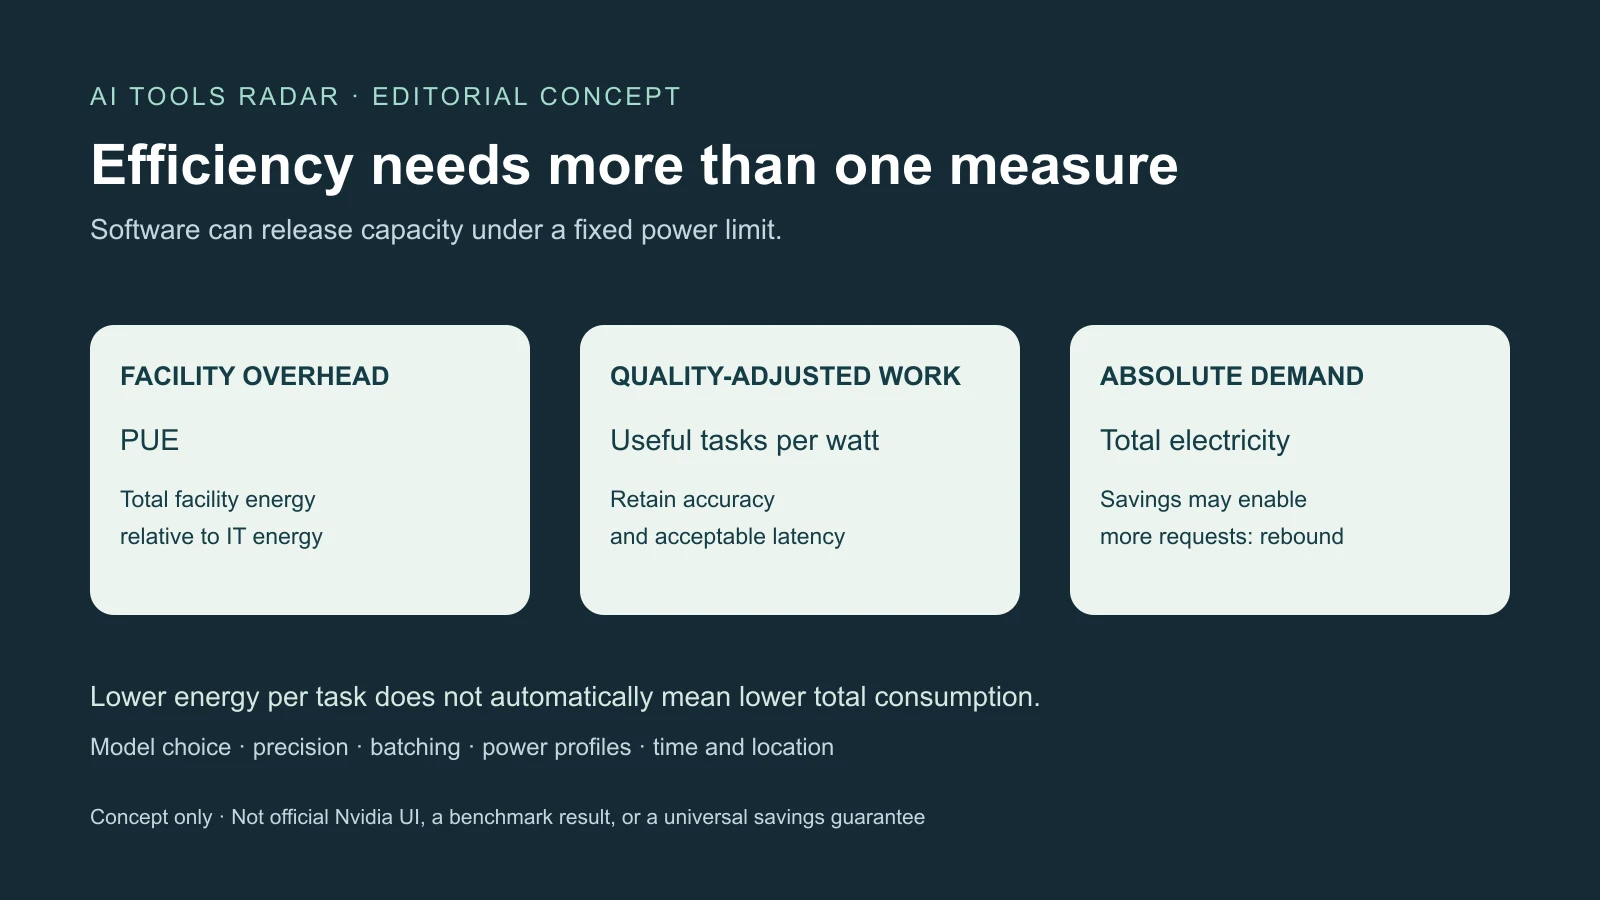
Un centro AI limitato dall’energia non cresce semplicemente ordinando GPU. Il software sceglie modello, lavoro, attese e orario. I ricercatori sostengono che cambiare queste scelte può liberare capacità installata prima di sostituire chip o ottenere corrente nuova.
Hardware, raffreddamento e rete restano necessari. La domanda passa dalla prestazione pubblicizzata per watt al lavoro utile completato entro il limite reale e all’uso del risparmio per ridurre domanda o aumentare output.
PUE misura l’edificio, non il valore del calcolo
PUE divide energia totale per quella IT. Vicino a 1,0 indica poco overhead di raffreddamento, luce e conversione, non necessità di ogni calcolo. PUE ottimo può convivere con modelli eccessivi, token inutili e server inattivi.
Uptime Institute nel 2025 indica media ponderata 1,54 e poca variazione per il sesto anno, anche per strutture vecchie e vincoli regionali. IEA stima server al 60% dell’elettricità moderna, storage e reti meno, raffreddamento dal 7% degli hyperscaler efficienti a oltre 30% delle aziende meno efficienti.
Sono contesti e denominatori diversi, non quote universali da sommare. La sola struttura non risolve sprechi applicativi. Modello, precisione, batch, lunghezza, processore e calendario decidono produttività del rack.
Jae-Won Chung, Michigan e ML.Energy, unisce hardware, sistemi, algoritmi e applicazioni. Codice e calendario cambiano prima di fabbricazione, acquisto, installazione e test. A tetto fisso, più richieste e minore attesa equivalgono a capacità senza aumento del picco.
La previsione globale incontra limiti locali
IEA stima 415 TWh nel 2024, circa 1,5% mondiale, dopo crescita media annua 12% per cinque anni. Il caso base arriva a 945 TWh nel 2030, poco sotto 3% e leggermente sopra l’attuale Giappone.
USA e Cina aggiungerebbero 240 e 175 TWh dal 2024. Server accelerati crescono 30% annuo e quasi metà dell’incremento; server tradizionali e infrastruttura con raffreddamento circa un quinto ciascuno.
Sono scenari, non misurazioni future. La media nasconde concentrazioni: un centro apre in due–tre anni, generazione, linee e sottostazioni spesso più tardi. Il caso efficiente offre nel 2035 gli stessi servizi con oltre 15% meno corrente, grazie a software, hardware e infrastruttura insieme.
Amazon, Google, Meta, Microsoft e fornitori AI cercano contratti, rinnovabili, nucleare, generazione locale, rack densi e chip propri. Richiedono tempo e capitale. Routing e pianificazione sono un’altra leva; clienti vedono quote, latenza e disponibilità anche senza bolletta per richiesta.
I risparmi dichiarati hanno condizioni differenti
Profili Blackwell Nvidia cambiano frequenze di calcolo e memoria, limiti, cache e NVLink. Il fornitore dichiara fino a 15% meno energia conservando almeno 97% delle prestazioni e fino a 13% più throughput in centri limitati. Dipende dal carico, non è garanzia generale.
Il clock massimo può costare molto per poco guadagno. Rallentare selettivamente preserva output e libera corrente ad altre GPU. Risparmio e throughput sono confronti vincolati differenti.
ML.Energy ha testato Qwen3-235B-A22B-Thinking in FP8 contro bfloat16, trovando circa un terzo meno energia nelle prove di risoluzione. Precisione ridotta può cambiare accuratezza: contano modello, hardware e implementazione. Non ogni quantizzazione risparmia uguale senza perdita.
Il training ha margine di sincronizzazione: componenti veloci attendono lenti. Perseus rallenta quelli meno occupati per finire col collo di bottiglia, non tutto il lavoro. La ricerca riporta fino a 30% meno energia senza ridurre throughput nella configurazione studiata.
Altri livelli usano cache, piccoli modelli per routine, prompt compressi, output limitati e batching. Compilatori fondono operazioni e riducono movimento dati energivoro. Istanze corrette e dismissione di vecchi rack tagliano base inattiva; Chetan Visrolia di SHI li indica come bersaglio pratico.
Non sono un prodotto o percentuali sommabili. Eliminano lavori diversi che non migliorano il risultato, mantenendo la qualità e il servizio richiesti.
Tempo e luogo aiutano anche senza ridurre tutto
L’interazione richiede risposte rapide, valutazioni, elaborazioni e alcuni training possono attendere. Spostamento temporale evita picchi; geografico usa regioni disponibili. Sophie Hall di ETH Zurich combina piano del giorno prima e tempo reale nella flotta Google, preservando prestazioni.
Una MWh con eccesso rinnovabile differisce dal picco serale. Prove 2026 National Grid, Nvidia, Emerald AI ed EPRI mostrano un operatore al 66% di domanda in meno di un minuto e un altro test al 10% per dieci ore.
Sono dimostrazioni distinte, non prova per tutti i carichi commerciali. Connessioni interrompibili possono accelerare accesso in cambio di capacità ridotta temporanea, con accordi di utility, regolatore e operatore.
Una rassegna Nature Reviews Clean Technology stima circa 10% meno emissioni di ciclo vita in reti ricche di rinnovabili con operazioni allineate. Energia, carbonio e acqua possono confliggere; meno acqua talvolta aumenta emissioni. Quantità, tempo, carbonio, stress idrico, latenza e luogo dati sono variabili distinte.
Grandi flotte hanno più opzioni, piccoli possono rinviare batch, ridurre inattività e scegliere modelli. Requisiti reali aiutano: lavoro flessibile marcato urgente prenota capacità inutile. Workflow mirati e contesto riusabile riducono ripetizione prima del pianificatore.
Qualità, privacy e rimbalzo limitano il risultato
Energia per token non basta se aumentano token inutili. Per compito accettabile completato riflette modelli e tentativi. Utilizzo alto può elaborare basso valore; precisione o routing errati generano errori e successiva escalation.
Cache deve rispettare riservatezza e aggiornamento; geografia la sovranità dei dati. Trasferire grandi dataset costa tempo, rete ed energia e aggiunge rischio. Interazione non attende ore per corrente pulita; interruzione del training richiede checkpoint e recupero.
Il rimbalzo di Jevons può assorbire risparmio assoluto. Il 15% in meno per inferenza consente più richieste con il centro sempre a piena allocazione. È output utile, non necessariamente meno consumo o emissioni. L’efficienza da sola non garantisce sollievo alla rete.
Togliere spreco o aumentare token per joule non giustifica ogni compito. Non sostituisce generazione, trasmissione e raffreddamento; IEA assume già miglioramenti generali. Servono lavoro per watt corretto per qualità e consumo assoluto.
Dati comparabili sono scarsi. Medie scelte e carichi favorevoli nascondono cambi di mix. Test indipendenti dello stesso lavoro devono includere qualità, latenza, utilizzo ed energia. Ignorare accuratezza premia peggioramento; ignorare latenza configurazioni inutilizzabili.
La prova è nel comportamento operativo
Tre segnali sostengono il software: risultati riproducibili fra modelli, precisione e potenza; connessioni flessibili commerciali oltre le prove; chiarezza sull’uso della capacità liberata.
Rinviare costruzioni e ridurre picchi aiuta la rete. Usare tutti i risparmi per generare altre risposte AI affronta soprattutto la scarsità di capacità di calcolo. Entrambi possono riuscire, ma rispondono diversamente e non meritano la stessa promessa ecologica senza condizioni.
Software cambia prima delle sottostazioni e migliora più strati. La prova non è una percentuale in laboratorio, ma più lavoro accettabile per watt, meno progetti bloccati, flessibilità utile e domanda assoluta trasparente.
Fonti e approfondimenti
Indagine Uptime Institute · Prospettive IEA · Ricerca Perseus · Rassegna sostenibilità AI · Approfondimento: workflow AI · Notizia efficienza software