
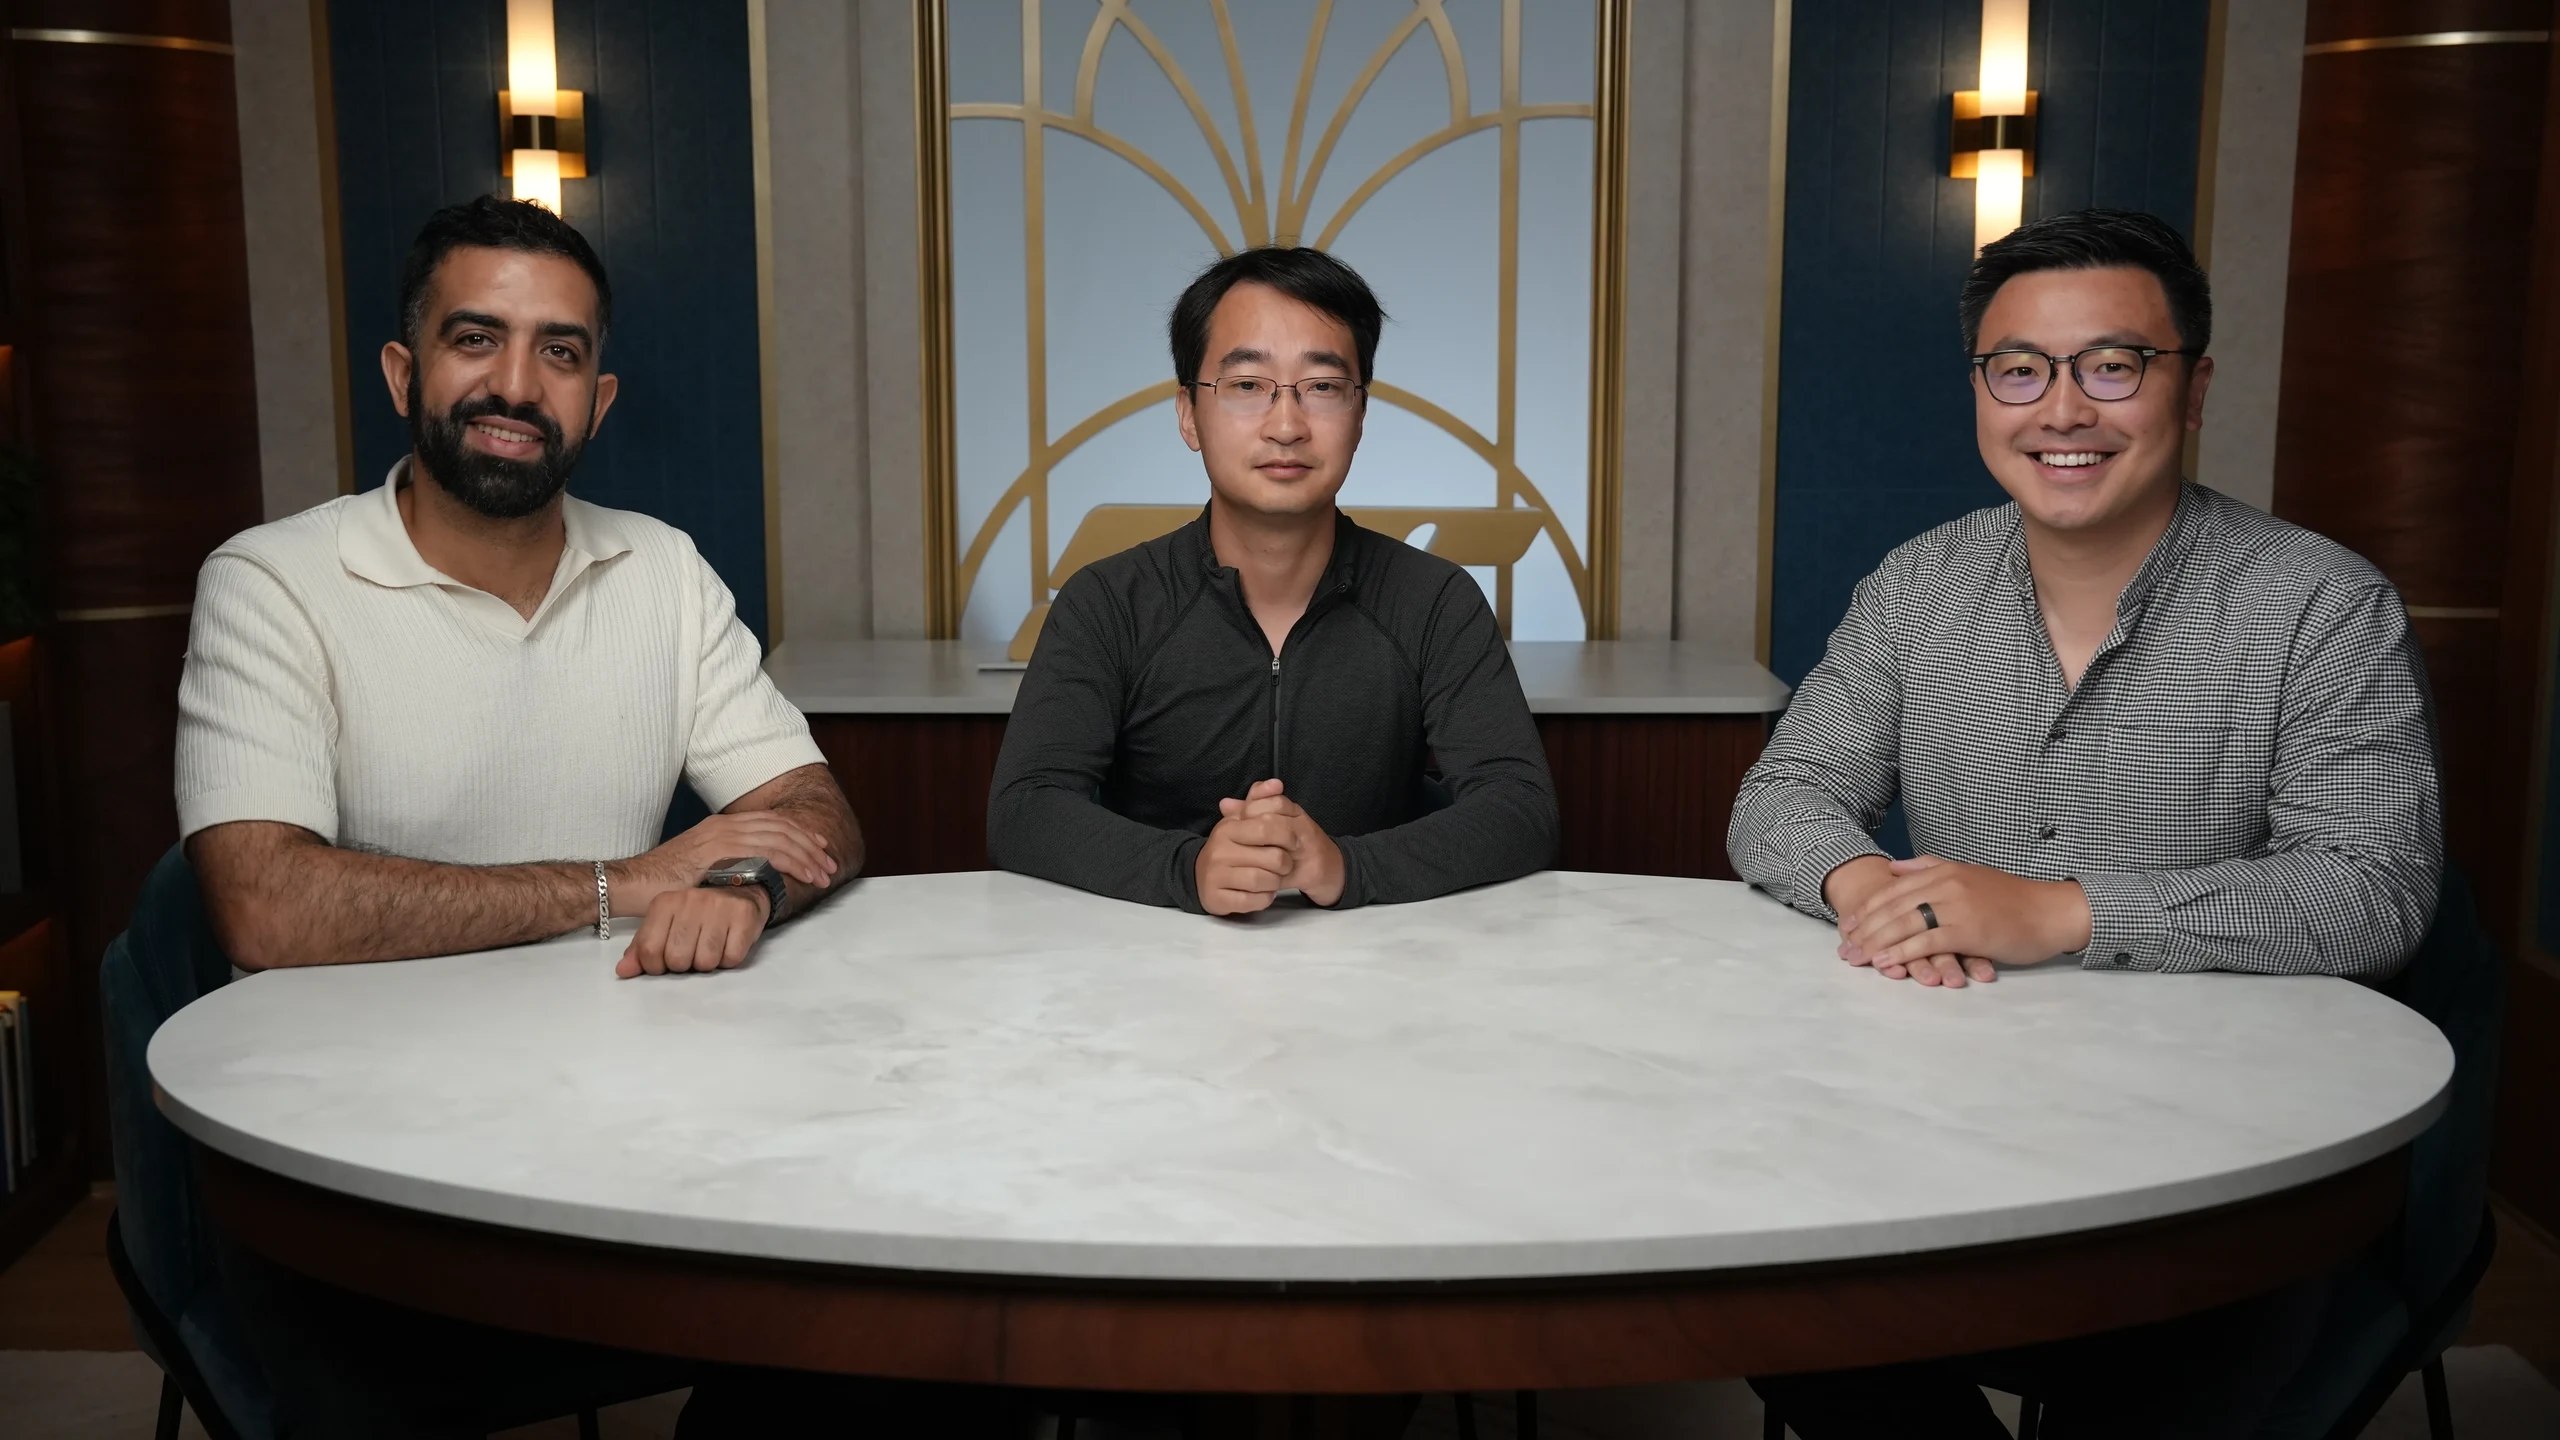
Safeworld salió de su fase reservada con más de 12 millones de dólares de financiación semilla para evaluar una cuestión que una demostración convincente no resuelve: cómo se comporta una máquina controlada por IA probabilística cerca de personas que no fue preparada específicamente para encontrar. Shine Capital y a16z Speedrun lideraron la ronda, con Box Group, el fondo patrimonial de Carnegie Mellon University, Innovation Endeavors y SV Angel. La empresa propone una capa independiente de evaluación entre desarrolladores y compradores que deciden introducir robots cerca de trabajadores, clientes y residentes.
Los fundadores son Ding Zhao, director del Safe AI Lab de Carnegie Mellon, el ejecutivo de startups Kyle Wong y el ingeniero de aprendizaje automático Simo Rachidi. Su experiencia en investigación de seguridad, software empresarial, ciberseguridad y creación de empresas es pertinente, pero no constituye certificación. Safeworld no presenta otro cuerpo robótico ni un modelo general de control. Apuesta por que las pruebas independientes y repetibles ganen valor cuando las capacidades superen demostraciones estrechamente programadas.
Por qué una actualización cambia un riesgo físico
Un brazo industrial convencional puede seguir trayectorias programadas dentro de una celda protegida. Un modelo de visión-lenguaje-acción conecta entradas visuales y lingüísticas con movimiento, ampliando las tareas sin programar cada acción por separado. La flexibilidad también amplía los comportamientos que necesitan evaluación. Una persona desconocida, una instrucción ambigua o una escena inusual pueden provocar respuestas que una demostración exitosa no cubrió.
No hace falta cambiar el metal para que una evaluación quede obsoleta. Otro checkpoint, prompt, componente perceptivo o política de planificación puede alterar la respuesta. Un resultado en almacén tampoco se traslada automáticamente a una obra solar, un pasillo hospitalario o una vivienda. La afirmación defendible se refiere a una configuración especificada, condiciones documentadas y peligros definidos, no a un robot universalmente seguro.
Las normas existentes de maquinaria, seguridad funcional e integración industrial siguen siendo esenciales. La guía de la Association for Advancing Automation afirma que ninguna norma única cubre todos los robots generalistas: los requisitos dependen de tarea, entorno, movilidad, acceso humano, comportamiento de IA y mercado. Vincular pruebas de escenarios con requisitos puede ayudar, pero no sustituye controles físicos de fuerza, velocidad, alcance y movimiento.
Los mecanismos inferiores con clasificación de seguridad deben permanecer separados del razonamiento de IA e imponer límites que el modelo no pueda anular. DeepMind también describe protecciones por capas y evaluaciones adversariales, advirtiendo que detectar personas no es un sistema garantizado con clasificación de seguridad. Comportarse con seguridad durante una evaluación no equivale a una función protectora certificada.
Reconstruir un encuentro y variar lo importante
El proceso propuesto empieza con un entorno observado o un incidente. Un equipo lo reconstruye en simuladores como Genesis o MuJoCo, incorpora un robot virtual que ejecuta su software real de control y cambia el encuentro. Posición, movimiento, apariencia y visibilidad humana, ubicación de objetos y tiempos se convierten en variables. La plataforma pretende generar rutas posibles, predecir riesgos de interacción, conservar pruebas y relacionar los hallazgos con prácticas de seguridad.
Cuando un robot móvil se acerca a una esquina ciega de fábrica, importan alcance de detección, velocidad, distancia de frenado e instante en que aparece un peatón oculto. Cargar cajas, agacharse, correr, caer o elegir otra ruta cambia el encuentro. Pedir repetidamente a alguien que caiga junto a maquinaria en movimiento sería impracticable y potencialmente peligroso. La simulación explora variantes sin recrear la exposición física.
La idea recuerda la evaluación acelerada de conducción autónoma: concentrar pruebas en interacciones raras y relevantes en lugar de esperar que ocurran naturalmente. El perfil oficial de Zhao describe aprendizaje por refuerzo, robótica centrada en personas, razonamiento de IA e interacción física segura humano-robot, además de colaboración con transporte, informática e industria. Esa trayectoria explica el enfoque, pero no demuestra el rendimiento comercial.
Gritt Robotics aporta un contexto operativo inicial. Desarrolla IA para robots que ayudan a instalar paneles fotovoltaicos en parques solares industriales y colabora con Safeworld en simulaciones de seguridad. Los trabajadores pueden estar de pie, arrodillarse, agacharse, correr, transportar cargas o caer, con ropa y características corporales distintas. Es una colaboración temprana con un cliente, no evidencia publicada de menos lesiones ni un resultado de despliegue validado.
Las pruebas deben sostenerse fuera del simulador
La utilidad depende de cómo se representan dinámica, sensores, software, personas y entorno. Si una cámara simulada ve mejor que el sensor real, se puede subestimar el riesgo. Si el modelo humano omite un movimiento importante, miles de ejecuciones pueden pasar por alto el mismo peligro. El número de escenarios no sustituye la cobertura de modos de fallo significativos.
Un registro útil identificaría configuración, parámetros del escenario, versión del modelo, peligro, respuesta y métrica de seguridad. Repetir la misma familia tras una actualización puede mostrar cambios. Un accidente o casi accidente podría convertirse en una prueba permanente de regresión, no una demostración aislada, dando trazabilidad entre versiones y una base para determinar si una modificación aumentó el riesgo.
Persisten cinco límites: fidelidad de simulación; escenarios fuera de los supuestos del generador; métricas que ignoran objetos caídos, movimiento inestable, salidas bloqueadas o señales confusas aunque se eviten choques; integración con frenos, actuadores, sensores, redes, baterías, accesorios y procedimientos; y personas que cambian de comportamiento o toman atajos tras operaciones repetidamente seguras. El riesgo puede aumentar sin cambiar el software.
Ruido, fricción, variaciones de carga, desgaste, iluminación y retrasos de red complican el sistema físico. La simulación puede descubrir fallos y comparar configuraciones, no demostrar que un robot probabilístico jamás lesionará a nadie. La prueba formal exige sistemas y límites suficientemente especificados; los modelos estadísticos encuentran entradas que no pueden enumerarse exhaustivamente. Los ensayos deben apoyar un argumento más amplio, con protección física, límites operativos, formación, informes de incidentes y supervisión en campo.
La independencia debe ganarse también comercialmente
Los fabricantes ya utilizan simulación, pruebas de hardware, red teams internos y pilotos controlados. Safeworld podría diferenciarse mediante un evaluador con otros incentivos, especialización y conocimientos compartidos de peligros. Un comprador puede conocer su proceso sin acceder a datos de entrenamiento, arquitectura o historial completo de fallos. Una evaluación aparte puede ayudar a aprobar, restringir o aplazar el despliegue sin depender únicamente de las promesas del proveedor.
Sin embargo, un evaluador pagado por el cliente no es neutral automáticamente. Los encargos recurrentes de empresas robóticas en crecimiento generan presión, sobre todo cuando resultados negativos retrasan lanzamientos o exigen protecciones. Método, límites de informes y trato de hallazgos desfavorables importan tanto como la etiqueta independiente. Un informe debe separar observaciones de supuestos, condiciones probadas de no probadas, lagunas conocidas y riesgos residuales aceptados por el operador.
Si el cliente aporta modelo del robot, modelo humano y todos los escenarios, la evaluación puede limitarse a formalizar sus puntos ciegos. Bibliotecas propias de peligros, incertidumbre documentada y comparaciones con incidentes reales podrían contrarrestarlo. Métodos transparentes, conclusiones reproducibles y revisión técnica externa reforzarían la confianza; un panel atractivo o muchos escenarios no bastan por sí solos.
La empresa no ha presentado una certificación universal, un benchmark público ni rendimiento validado independientemente. La correlación entre simulación y campo tampoco la ha establecido como autoridad sectorial. Mostrar que riesgos simulados predicen casi accidentes o intervenciones en pilotos sería valioso, pero sigue siendo una tarea pendiente, no un resultado alcanzado.
¿Plataforma, servicio especializado o ambos?
Safeworld aún decide cuánto software manejarán los clientes y cuánto trabajo realizarán sus expertos. El software puede permitir regresiones continuas y escalar con facilidad, pero requiere configuración e interpretación correctas. Los servicios profundizan en el análisis de peligros, aunque crecen más despacio, cuestan más y dependen de especialistas escasos.
Una combinación de pruebas rutinarias del cliente y casos difíciles dirigidos por expertos es plausible, no un compromiso anunciado. Tesla, Wayve y grandes laboratorios consideran la simulación una capacidad central. Los desarrolladores de modelos construyen evaluaciones adversariales; especialistas, consultores de normas y certificadores cubren necesidades superpuestas. Utilizar simulación no es una ventaja defendible por sí sola. Descubrir riesgos relevantes y producir pruebas reconocidas por quienes deciden despliegues sí podría serlo.
La expectativa de Zhao de que las empresas tendrán que pagar por la seguridad es una previsión de mercado, no una regla establecida de compras. Algunos fabricantes construirán internamente, algunos compradores recurrirán a consultores y otros esperarán normas y responsabilidades más claras. El reportaje original anticipaba que los siguientes uno a tres meses podrían aclarar el equilibrio entre software y servicio experto: una expectativa, no un calendario garantizado.
Cuándo una prueba cambia una decisión
La relación con Gritt ofrece una siguiente comprobación concreta: documentar cómo los hallazgos cambiaron comportamiento, controles del sitio o límites operativos y qué riesgos quedaron. Un caso trazable antes-después diría más que un respaldo. Si las alianzas siguen siendo exploratorias, muestran interés operativo, no encaje producto-mercado ni protección demostrada.
La segunda comprobación es si los profesionales pueden cuestionar selección de escenarios, modelos humanos e incertidumbre, distinguir posibilidades generadas de peligros validados y reconocer fidelidad insuficiente. Revisión externa, benchmarks publicados y correlación documentada con pruebas físicas podrían ayudar sin revelar cada técnica propia. Son posibles caminos hacia la credibilidad, no hitos alcanzados.
Por último, los informes ganarían peso si los operadores los usaran para aprobar versiones, aseguradoras para evaluar riesgos o procesos normativos reconocieran métodos compatibles. Son posibilidades, no certificaciones u obligaciones actuales. Tras simular importa si alguien cambia el sistema, restringe el despliegue y conserva hallazgos entre versiones. Producir pruebas que modifican decisiones exige más que generar escenarios adicionales.
Fuentes
Reportaje del lanzamiento · Plataforma Safeworld · Guía de normas A3 · Protecciones robóticas de DeepMind · Perfil oficial de Ding Zhao · Reportaje (dirección alternativa)