
14. Oktober 2026 —
Apple TV erhält Siri für den ganzen Raum, ältere Boxen aber ebenfalls den Assistenten
Die heutigen Entwicklungen bringen KI näher an konkrete Handlungen: auf dem Fernseher suchen, durch eine Brille ein Produkt auswählen, den Agentenverlauf komprimieren oder einen Produktions-Trace untersuchen. Entscheidend sind klare Unterschiede: Welche Funktionen benötigen neue Hardware, welche Belege überstehen die Verdichtung, und was wurde tatsächlich demonstriert? Auch die Sicherheitsmeldungen trennen das Schließen eines Zugangs von der Untersuchung eines möglicherweise bereits erfolgten Zugriffs.
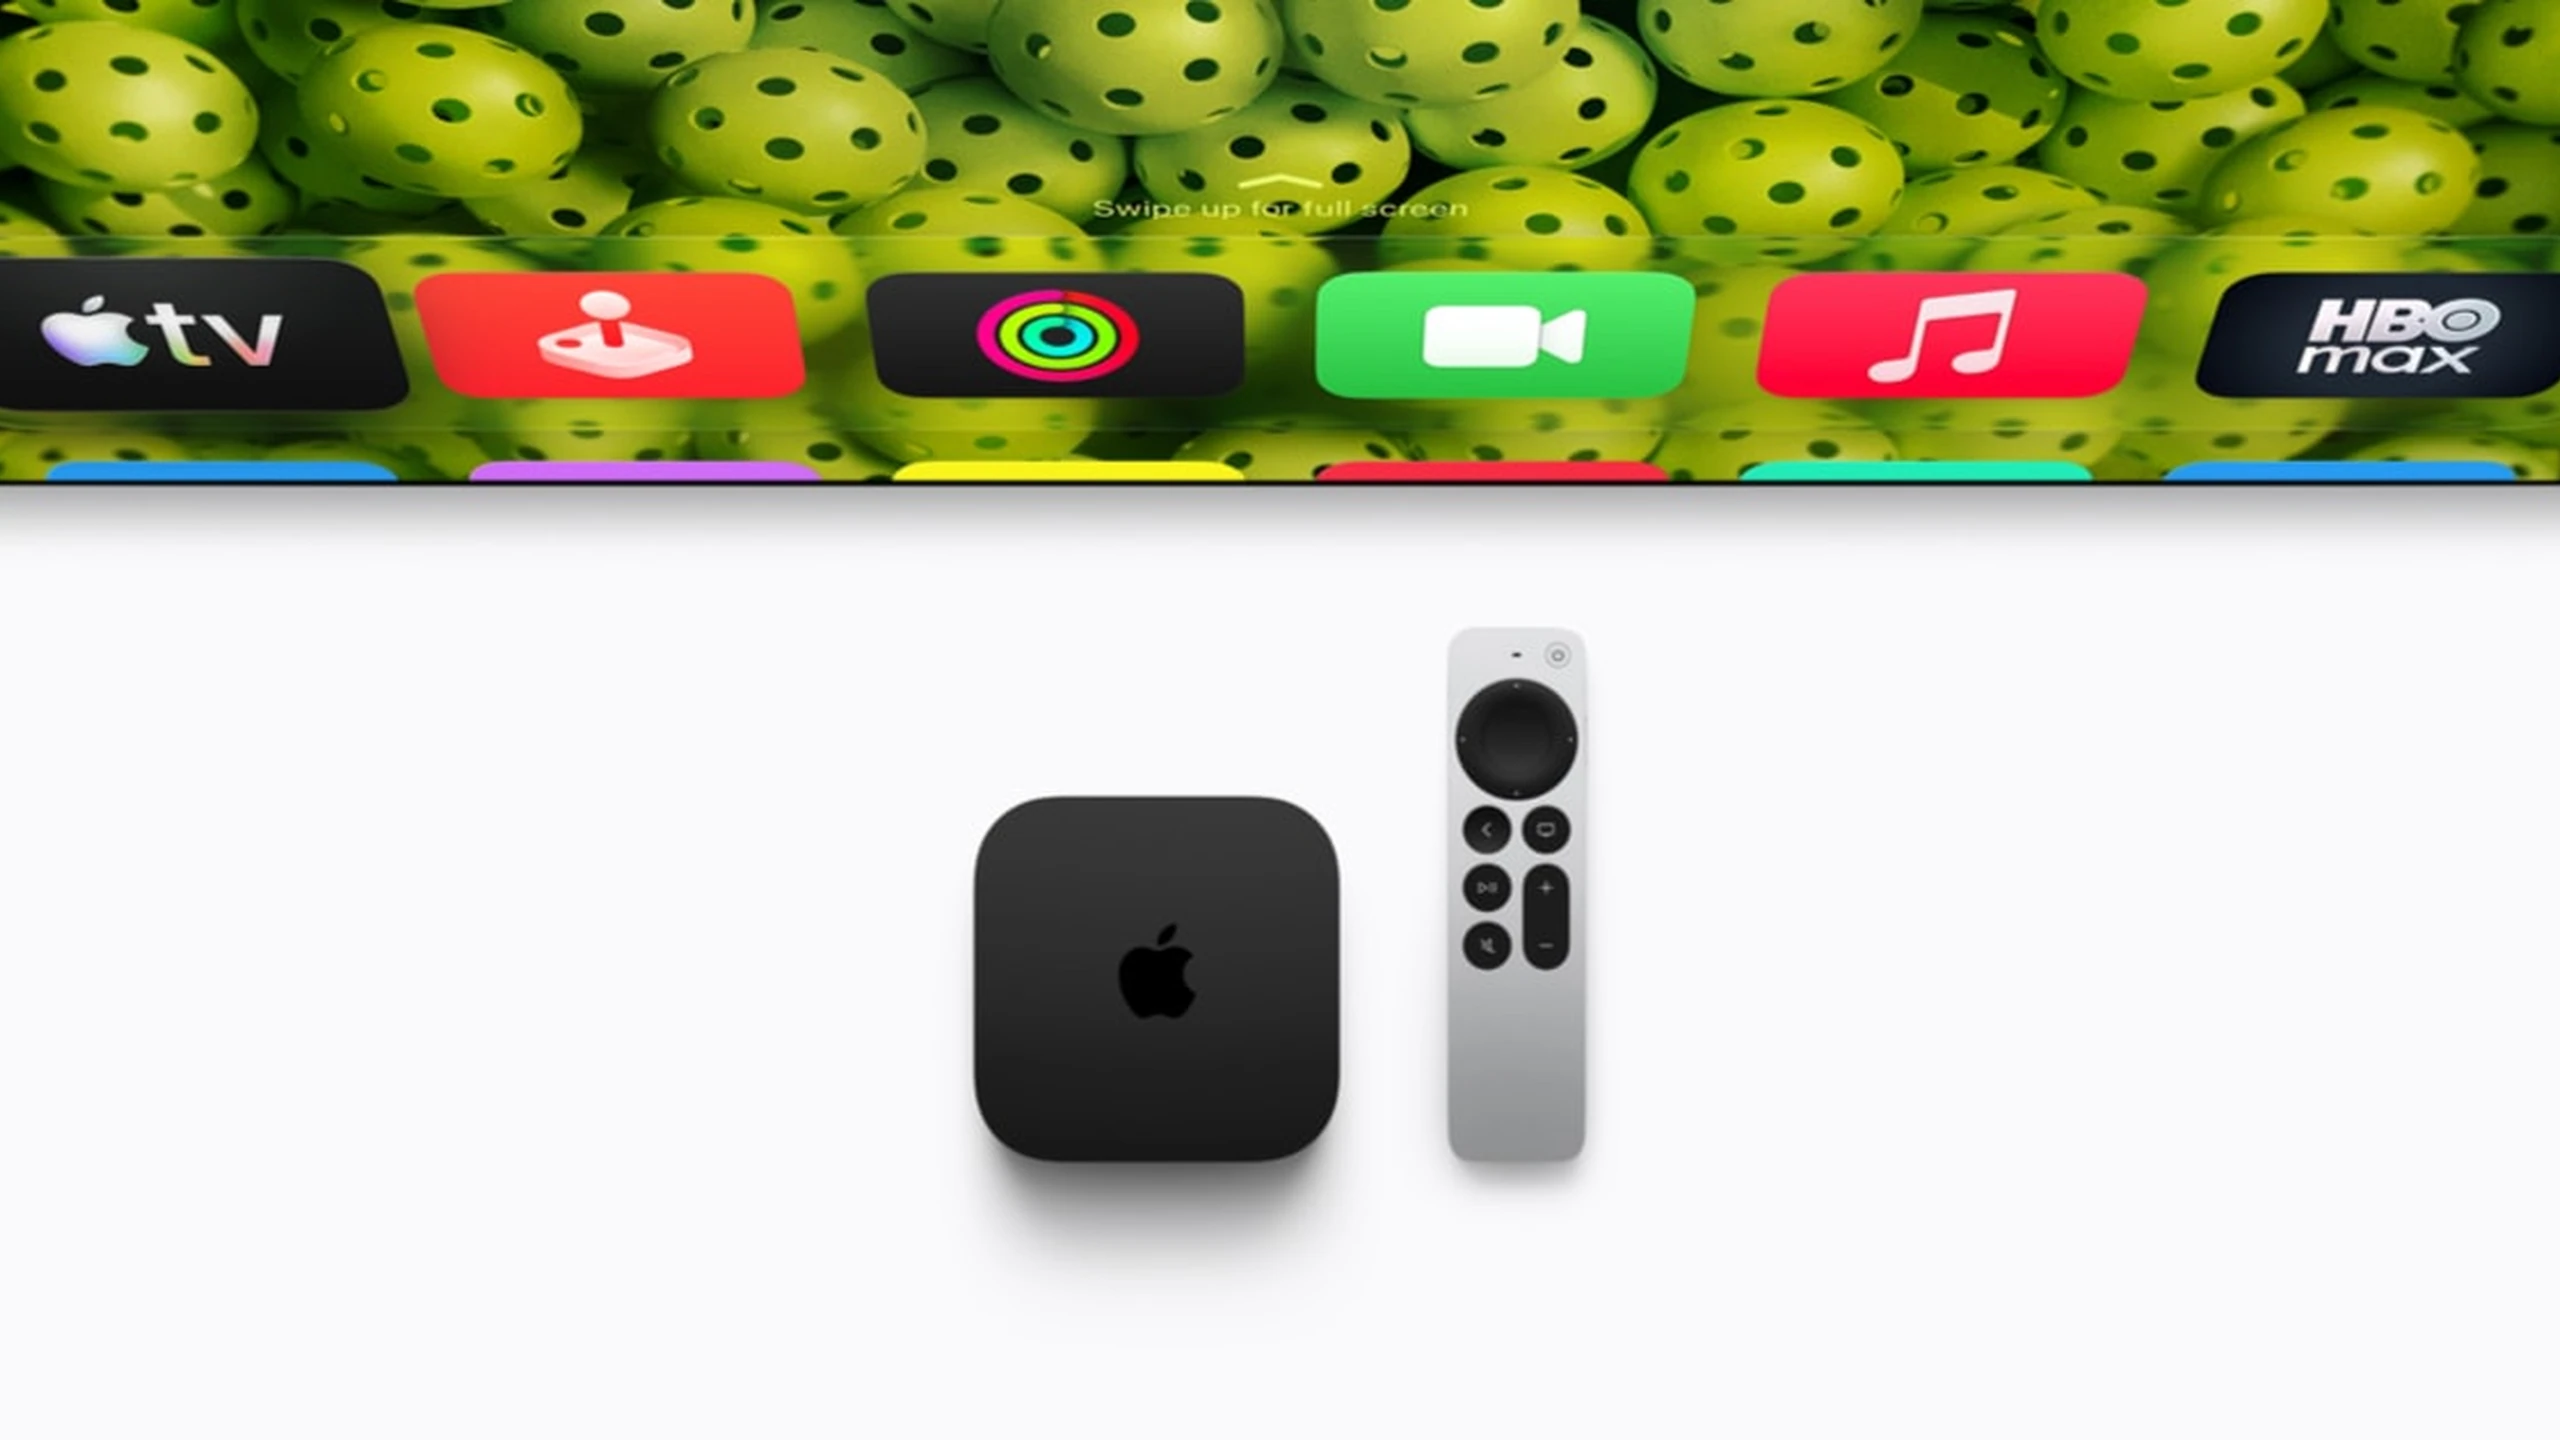
Apple TV erhält Siri für den ganzen Raum, ältere Boxen aber ebenfalls den Assistenten
Apple stellte am 13. Oktober die vierte Generation Apple TV 4K vor, mit geplanter Verfügbarkeit am 13. November. A19-Chip, AV1-Dekodierung und drei Fernfeldmikrofone ermöglichen dialogorientierte Unterhaltungssuche und freihändige Haussteuerung. Apple nennt bis zu 50% mehr CPU-Leistung und doppelte GPU-Leistung; das sind Unternehmensangaben, keine unabhängigen Tests. Neue Hardware kann vier kompatible HomePods koordinieren, frühere Modelle bleiben in dieser Konfiguration auf zwei begrenzt.
Siri AI kommt als Beta auch auf Apple TV 4K ab der zweiten Generation. Nicht jede Gesprächsfunktion verlangt also die neueste Box. Die Start-Beta unterstützt Englisch in acht Märkten; eine Suche nach der Empfehlung eines Freundes benötigt für persönlichen Kontext ein Apple-Intelligence-fähiges iPhone. Kamerabeschreibungen und HomeKit-Aktivitätszusammenfassungen erweitern den Assistenten über Filmsuche hinaus, ihre Genauigkeit ist aber nicht unabhängig belegt.
Für ein Upgrade sprechen daher direktes Zuhören im Raum, Audiokoordination und Hardwareleistung, nicht allein der Name Siri. Apple beschreibt isolierte Mikrofonverarbeitung und geschützte Cloud-Verarbeitung. Diese Schutzmaßnahmen klären nicht automatisch, wessen private Informationen auf einem gemeinsam genutzten Bildschirm erscheinen dürfen. Haushalte mit Geräten verschiedener Marken und Ökosysteme sowie nicht unterstützte Sprachen erhalten ein eingeschränkteres Erlebnis als die Vorführung nahelegt.
Alibabas Qwen-Brille unterscheidet sich durch den Zugang zu Diensten
Alibaba begann am 13. Oktober in China mit dem Verkauf von Qwen Glasses N1 und N1 Pro nach Vorbestellungen im September. N1 besitzt einen 50-Megapixel-Sensor; Pro ergänzt Blickverfolgung für Objektauswahl und zahlungsbezogene Interaktionen. Genannt werden Einkauf, Übersetzung, Musik und Gesundheit sowie 25 Stunden Standby oder neun Stunden Musik. Diese Herstellerwerte messen keine gemischte Nutzung aus Kamera, Netzwerk und Assistent.
Gegenüber Meta liegt der strategische Unterschied im verbundenen Handels-, Zahlungs- und lokalen Dienstleistungsnetz. Auf Objekterkennung können Produktsuche und Transaktion folgen, nicht nur eine Antwort. Damit gewinnen ausdrückliche Kaufbestätigung, Aufnahmeanzeigen und Kontrolle über Stimme, Blick- und biometrische Daten an Bedeutung. Frühere internationale Pläne belegen keine gleichwertige N1-Dienstabdeckung außerhalb Chinas; Tragekomfort, Unterstützung für Korrekturgläser und dauerhafte Nutzung sind durch Spezifikationen nicht bewiesen.
ScaleDown trennt Kontextarbeit von der Schlussfolgerung des Hauptmodells
LangChains neue ScaleDown-Integration übergibt Zusammenfassung, Kompression, Extraktion und Klassifikation an spezialisierte Modelle mit begrenzter Ausgabe; das Hauptmodell plant und generiert weiter. Tool-Kompression wählt anhand einer aufgabenspezifischen Frage relevantes Material. Extraktion liest Nutzernachrichten, statt eigene Vermutungen des Agenten als gelieferte Fakten zu behandeln. Ein LangSmith-Gateway-Pfad zentralisiert Zugangsdaten, Richtlinien und Tracing.
Die Middleware arbeitet fail-open: Wird ein Hilfsaufruf abgelehnt oder ist nicht verfügbar, läuft der Agent ohne diese Transformation weiter. Verfügbarkeit kann dadurch höhere Kontextkosten oder fehlenden extrahierten Zustand verdecken. Zusammenfassung ist zudem privat in Vorschau. Anbieterangaben zu Tempo und Kosten betreffen enge Operationen, nicht den gesamten Ablauf. Kompression kann Ausnahmen oder Anweisungen entfernen und Cache-Wiederverwendung verändern. Zu vergleichen sind erfolgreicher Abschluss, erhaltene Fakten, Wiederholungen und Gesamtlatenz, während das Original wiederherstellbar bleibt.
LangSmith durchsucht Agentenverhalten mit einem ausdrücklichen Evidenzbudget
LangSmith AI Search ging am 13. Oktober in öffentliche Beta. Prüfer beschreiben Verhalten wie frustrierte Nutzer oder behaupteten Erfolg ohne erledigte Aufgabe, kombinieren herkömmliche Filter und sehen nach Konfidenz geordnete Treffer. Das System normalisiert wiederholte Trace-Historie zu einer Trajektorie und nutzt ein Entscheidungsmodell statt nur Keyword- oder Vektorähnlichkeit.
Jede Trajektorie erhält 8.000 Token, zuerst für Nutzernachrichten und finale Antworten, dann für Zwischenschritte. Entscheidende Tool-Fehler können fehlen; Subagenten-, Middleware- und Kompaktierungsinhalte werden nicht durchsucht. Beschreibungen lassen sich noch nicht als Ansichten speichern oder in geteilten Links bewahren. Die Administratorfreigabe erlaubt Verarbeitung in den USA auch bei anderen Hostingregionen. Geschützte Gesundheitsinformationen sind ausgeschlossen, ebenso BAA-Abdeckung. Konfidenz ist kein Beweis: Aufgezeichnete Belege prüfen und wiederkehrende Muster in getestete Evaluatoren umsetzen.
Anthropic zeigt Replikationsbausteine, keinen autonomen IoT-Wurm
Anthropics kontrollierte Forschung trennt Modelleinrichtung auf unbekannter Hardware von vollständiger Ausbreitung. Qwen3.5-9B konfigurierte Inferenz auf acht von neun Hardwaretypen. Ein separat verteilter Modelllauf über 15 Android-TV-Boxen erreichte 0,39 Token pro Sekunde: machbar, aber nicht praktisch interaktiv.
In einem abgeschirmten Emulatornetz mit acht Knoten und absichtlich nicht authentifiziertem Wartungszugang erreichte GLM-5.2 in vier von fünf Versuchen alle Knoten und im übrigen sieben. Der leistungsfähige Orchestrator lief auf einem externen Server, nicht auf den schwachen Zielen. Kleinere passende Modelle schafften die gesamte Folge nicht zuverlässig. Geerbte Fehlersuchnotizen verbesserten spätere Einrichtung ohne erneutes Training der Gewichte. Das offene Risiko ist das Zusammenwachsen kleiner Modellfähigkeiten und Einsetzbarkeit, nicht der Nachweis entkommener Haushaltsmalware.
Ivantis ausgenutzte Gateway-Lücke verlangt Untersuchung und Patch
CISA nahm Ivanti Connect Secure CVE-2026-104935 am 13. Oktober nach beobachteter Ausnutzung in KEV auf. Die Lücke erlaubt nicht authentifizierte Befehle auf betroffenen Zweigen. Volexity verfolgte Aktivitäten bis zum 3. Oktober auf einer damals aktuellen Version zurück und fand Zugangsdatenraub, Verzeichnisabfragen und Vorbereitung weiterer Zugriffe. Gesamtausmaß und Endziel bleiben unbekannt.
Der Betreiber nutzte den Exploitkanal wiederholt statt einer herkömmlichen dauerhaften Webshell, stellte temporäre Änderungen zurück und entfernte ausgewählte Logs. Eine unauffällige Festplattenintegritätsprüfung beweist deshalb nicht, dass zuvor kein Zugriff stattfand. Korrigierte Versionen schließen den dokumentierten Eingangs- und Ausführungspfad; ein separater Rechteausweitungs-Patch stand im Quellbericht noch aus. Zweiggerechtes Aktualisieren, Beweissicherung und Prüfung erreichbarer Geheimnisse beantworten verschiedene Teile des Vorfalls und ersetzen einander nicht.
CISAs Frist 16. Oktober umfasst zwei unterschiedliche Reaktionspfade
Die KEV-Ergänzungen vom 13. Oktober kombinierten die genannte Ivanti-Lücke mit Windows Shell CVE-2026-96951 und setzten zivilen Bundesbehörden den 16. Oktober als Frist. Windows beschreibt eine hochschwere Befehlsinjektion beziehungsweise Sicherheitsumgehung mit Nutzerinteraktion; Ivanti benötigt diese nicht. Windows-Flottenupdates und Gateway-Incident-Response bleiben deshalb verschiedene Arbeiten trotz bestätigter Ausnutzung beider Lücken.
KEV bedeutet weder, dass jede betroffene Maschine kompromittiert ist, noch einen universellen Zustellweg oder belegten Ransomwareeinsatz. Das Ransomwarefeld ist unbekannt. Private Organisationen erben die gesetzliche Bundesfrist nicht. Operativ zählen betroffene Builds, Exposition und nachgewiesene Behebung statt bloßer Updatetickets, mit ausreichender Telemetrie für die Zeit vor dem Fix.