
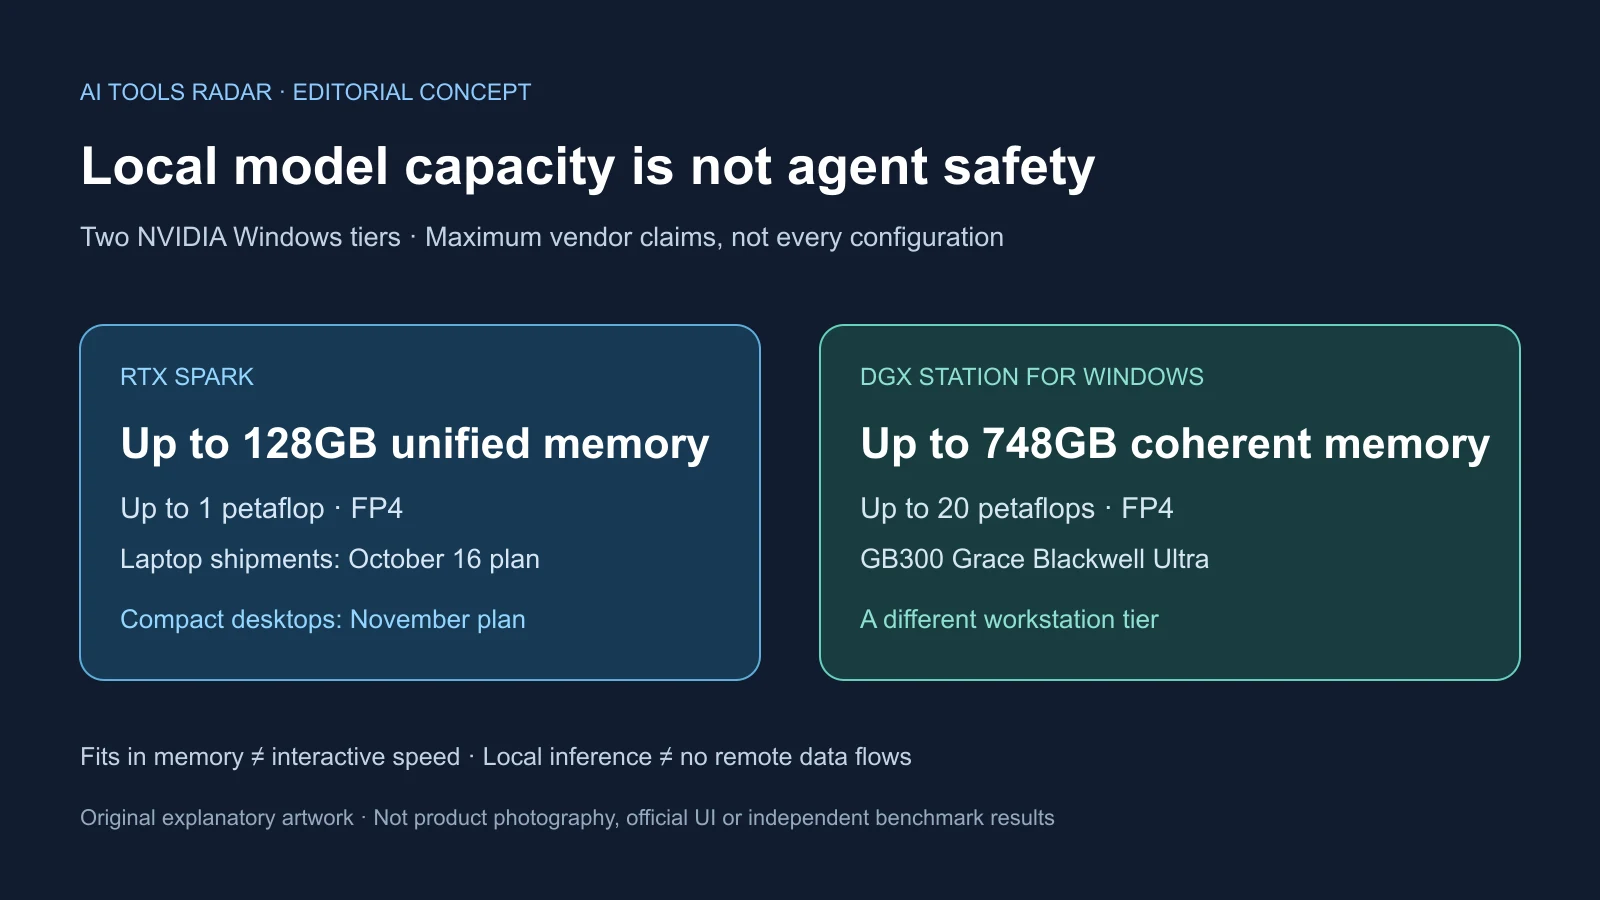
RTX Spark de Nvidia pasó de la promesa de junio a un lanzamiento Windows con fechas el 7 de octubre de 2026. Jensen Huang y Satya Nadella lo presentaron en San Francisco para ejecutar modelos y agentes junto a archivos y aplicaciones. Los portátiles podían reservarse, con envíos previstos desde el 16 de octubre; sobremesas compactos para noviembre. No demuestra que los clientes ya tengan todo dispositivo e integración.
La propuesta es gran memoria local con CUDA, no otra función del PC servida remotamente. Los equipos finales deben convertir capacidad en trabajo interactivo, sostenido y gestionable. Tamaño de modelo, rapidez de lanzamiento, seguridad y menor uso de nube necesitan pruebas diferentes.
Qué contiene la categoría
Asus, Dell, HP, Lenovo, MSI y Microsoft ofrecían reservas; Acer y Gigabyte estaban previstos. Microsoft presentó Surface Laptop Ultra para desarrolladores móviles y creadores, y el compacto Surface RTX Spark Dev Box para experimentos y trabajo continuo. Varios fabricantes significan una categoría, no una máquina idéntica.
RTX Spark une GPU Blackwell RTX de hasta 6.144 núcleos y CPU Grace de hasta 20. Nvidia anuncia 600GB/s, hasta 128GB unificados y un petaflop FP4. Es un formato numérico de cuatro bits; el máximo no mide toda aplicación.
CPU y GPU comparten recursos, reduciendo copias entre memorias. Microsoft dice que Surface Laptop Ultra ejecuta modelos de más de 120.000 millones de parámetros localmente. Caber donde las GPU comunes no pueden no significa responder rápido. Arquitectura, cuantización, contexto, runtime, almacenamiento y ancho de banda importan.
CUDA mantiene continuidad con sistemas Nvidia mayores y WSL conserva Linux. También se anuncian AV1, codificación y decodificación 4:2:2, ray tracing, DLSS y juego a alta frecuencia. Creación y juegos amplían público ante una demanda incierta de agentes persistentes.
Un pequeño sobremesa sigue disponible cuando el portátil duerme o viaja. Indexación autorizada, desarrollo programado y medios pueden beneficiarse. El uso no prueba que cada agente esté listo. Refrigeración, memoria, potencia y software cambian según diseño.
La estación pertenece a otro nivel
DGX Station Windows se sitúa por encima. Nvidia describe GB300 Grace Blackwell Ultra Desktop Superchip, hasta 748GB coherentes, 20 petaflops FP4 y modelos de hasta un billón de parámetros.
Son afirmaciones de otro sistema, no de portátiles. Windows conecta investigación grande con aplicaciones y administración, preservando Linux por WSL. La escala no establece velocidad de toda arquitectura de billón ni sustituye la nube para entrenamiento, colaboración, despliegue y máxima inferencia.
Microsoft separa Copilot+ cotidianos, categoría de constructores y estaciones. Foundry Local elige CUDA, DirectML, NPU o CPU según hardware. No toda aplicación Windows tiene que usar Spark o una misma arquitectura.
Los números MacBook tienen condiciones
Microsoft comparó sistemas seleccionados con MacBook Pro de 16 pulgadas, M5 Pro y 64GB. Afirmó primer token 2,1 veces más rápido, imágenes 4,3 veces y vídeo 6,2 veces.
La prueba lingüística fue encargada por Microsoft con Spark de preproducción, Qwen3.5 27B e instrucción fija de 8.192 tokens. Nvidia probó imagen y vídeo con cargas NVFP4. Las condiciones acompañan los cocientes: no son prueba independiente para todos los modelos, aplicaciones, baterías y diseños finales.
Tras el 16 de octubre importan inferencia sostenida, ventiladores, calor, batería y presión de memoria junto a aplicaciones normales. Un pico breve no muestra horas de indexación y uso. Los portátiles finos refrigeran menos que sobremesas.
Apple con memoria unificada es comparación evidente, pero Intel, AMD y Qualcomm también compiten. Los NPU enfatizan eficiencia y movilidad; Spark, modelos, CUDA, creación y juegos. La ventaja Nvidia es una ruta conocida a sistemas mayores, no una fórmula ideal universal.
Local es una elección de ejecución, no privacidad automática
Un modelo local procesa archivos sin subirlos, funciona sin conexión en tareas compatibles, evita cobros remotos y el viaje de ida y vuelta de red. La nube ofrece grandes capacidades mantenidas centralmente sin hardware especial. La solución práctica puede ser híbrida.
El modelo local clasifica, recupera contexto autorizado o retira detalles sensibles enviando una petición reducida. El plan Microsoft considera capacidad, privacidad, hardware y reglas. Una base personal organiza información aprobada sin autorizar acceso ilimitado.
Los creadores conservan material, desarrolladores prueban cuantizados con código privado y trabajadores eligen carpetas. Búsqueda, analítica, sincronización, cuentas y razonamiento especializado aún pueden transmitir. Inferencia local no significa ausencia de flujos remotos.
Los costes permanecen: dispositivo, energía, actualizaciones y gestión. Comparar debe incluir permisos, correcciones y mantenimiento, no solo API ahorrada.
El aislamiento Windows no demuestra corrección
Microsoft declaró Execution Containers, MXC, disponible de forma general en Windows 11. Las políticas limitan archivos, red y recursos con procesos, sesiones, máquinas virtuales y contenedores WSL. Es frontera de ejecución, no cómputo.
Identidades propias, pocos privilegios iniciales, permisos explícitos, revocación y bloqueo de agentes firmados no fiables limitan consecuencias. Un agente de código necesita proyecto y servicio, no documentos personales y todas las aplicaciones autenticadas. Agent 365 añade descubrimiento, identidad y gobierno organizativos sin reemplazar el límite local.
Según Nvidia, OpenShell conecta runtime y seguridad, aplica políticas y oculta información identificable antes de determinadas peticiones cloud. Facilita híbrido, no garantiza todo local. Instrucciones ocultas en páginas, documentos e interfaces aún manipulan agentes. La contención reduce recursos accesibles, no vuelve infalible al modelo.
Microsoft citaba Codex, GitHub Copilot, OpenClaw, Replit, LM Studio, OpenShell y Unsloth AI como actuales; Claude Code, Hermes Agent, Manus, Perplexity, Raycast y Simular como previstos. Hoja de ruta no es disponibilidad y soporte puede ser experimental o estable.
Cómo el lanzamiento se convierte en plataforma
Primero, análisis independientes finales deben comparar trabajo sostenido con Apple, portátiles de GPU Nvidia dedicada, PC NPU y nube. Si calor y batería limitan sesiones, el sobremesa puede servir mejor al agente continuo.
Segundo, hacen falta instalación fiable, catálogos, actualizaciones, registros, permisos y recuperación. Las pruebas deben explorar inyección, escalada, herramientas maliciosas, filtraciones e interacciones de contenedores. Éxito no es cero defectos sino ataques limitados, arreglo rápido, visibilidad y control claro.
Demasiadas aprobaciones anulan utilidad; permisos amplios debilitan aislamiento. Los registros deben explicar intentos, herramientas, datos y aprobación humana sin copias privadas incontroladas. Herramientas de junio y anuncios de octubre son base, no equilibrio resuelto.
Tercero, despliegues alrededor de Ignite en noviembre y después deben mostrar tareas acotadas: código privado, documentos regulados, medios confidenciales o aplicaciones antiguas autorizadas. Ahorro cloud debe contrastarse con equipos y gestión, no listas de socios.
Spark puede triunfar como estación especializada aunque los agentes persistentes no sean criterio general de compra. La visión depende de software útil con acceso suficiente, corregible y detenible. La memoria hace posible el experimento, no lo decide.
Fuentes
Lanzamiento RTX Spark · Seguridad de agentes Windows · Plan de inteligencia híbrida · Referencia de bases de conocimiento · Cobertura independiente · Herramientas de junio