
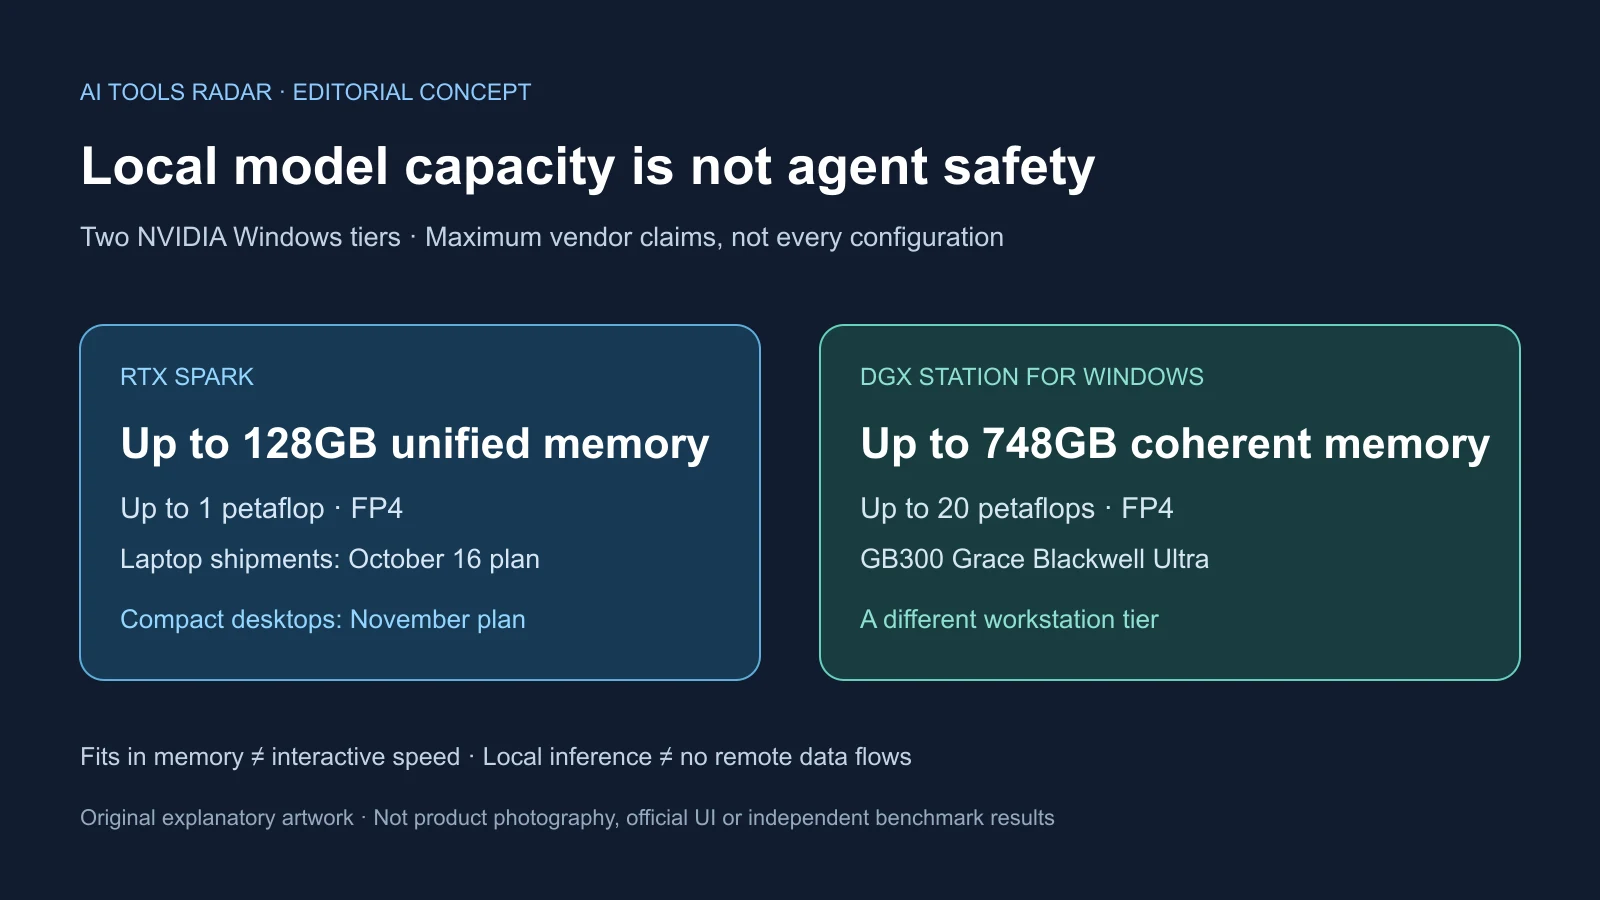
O RTX Spark passou da promessa de junho para um lançamento Windows com datas em 7 de outubro de 2026. Jensen Huang e Satya Nadella o apresentaram em São Francisco como hardware para modelos e agentes junto de arquivos e aplicativos do usuário. Notebooks entraram em pré-venda, com envio previsto desde 16 de outubro; desktops compactos ficaram para novembro. Isso não prova que todos os dispositivos e integrações já chegaram.
A proposta é memória local ampla com CUDA, não apenas outra função do PC servida remotamente. Máquinas finais precisam converter capacidade em trabalho interativo, sustentado e administrável. Tamanho de modelo, rapidez de lançamento, segurança e menor consumo de nuvem exigem evidências diferentes.
O conteúdo da nova categoria
Asus, Dell, HP, Lenovo, MSI e Microsoft ofereceram pré-vendas; Acer e Gigabyte também tinham planos. A Microsoft mostrou Surface Laptop Ultra para desenvolvedores móveis, criadores e construtores de IA, e o compacto Surface RTX Spark Dev Box para experimentos e trabalho contínuo. Vários fabricantes significam uma categoria, não uma máquina idêntica.
RTX Spark combina GPU Blackwell RTX de até 6.144 núcleos e CPU Grace de até 20. A Nvidia informa interface de 600GB/s, até 128GB de memória unificada e um petaflop de IA FP4. É um formato numérico de quatro bits; o pico não mede a velocidade de toda aplicação.
CPU e GPU compartilham uma reserva, reduzindo cópias entre memórias. A Microsoft diz que Surface Laptop Ultra executa modelos com mais de 120 bilhões de parâmetros localmente. Caber onde GPUs comuns não comportam não implica respostas rápidas. Arquitetura, quantização, contexto, runtime, armazenamento e banda continuam importantes.
CUDA mantém continuidade com sistemas Nvidia maiores; WSL preserva Linux. A empresa também anuncia AV1, codificação e decodificação 4:2:2, ray tracing, DLSS e jogos com altas taxas. Criação e jogos ampliam público enquanto a procura por agentes persistentes é incerta.
Um desktop pequeno fica disponível quando o notebook dorme ou viaja. Indexação autorizada, desenvolvimento agendado e mídia podem se beneficiar. O uso não demonstra que todo agente esteja pronto. Refrigeração, memória, energia e software diferem entre projetos.
A estação é outro patamar
DGX Station para Windows está acima. A Nvidia descreve GB300 Grace Blackwell Ultra Desktop Superchip, até 748GB de memória coerente, 20 petaflops FP4 e modelos de até um trilhão de parâmetros.
São afirmações de outro sistema, não dos notebooks. O Windows liga pesquisa local maior a aplicativos e gestão empresarial, mantendo Linux no WSL. Escala não estabelece velocidade para qualquer arquitetura de trilhão nem substitui nuvem em treino, colaboração, implantação e inferência máxima.
A Microsoft distingue Copilot+ cotidiano, categoria de construtores e estações maiores. Foundry Local escolhe CUDA, DirectML, NPU ou CPU conforme o hardware. Nem toda aplicação Windows precisa, portanto, de Spark ou da mesma arquitetura.
Os números do MacBook têm condições
A Microsoft comparou sistemas selecionados com MacBook Pro de 16 polegadas, M5 Pro e 64GB. Alegou entrega do primeiro token 2,1 vezes mais rápida, imagens 4,3 vezes e vídeo 6,2 vezes mais rápidos.
O teste de linguagem foi encomendado pela Microsoft com Spark de pré-produção, Qwen3.5 27B e prompt fixo de 8.192 tokens. A Nvidia fez imagens e vídeos em cargas configuradas para NVFP4. As condições acompanham as razões; não são prova independente para todo modelo, aplicativo, bateria e projeto final.
Depois de 16 de outubro importam inferência sustentada, ventiladores, temperatura, bateria e pressão de memória junto de aplicações comuns. Um pico curto não demonstra horas de indexação e uso normal. Notebooks finos têm menos refrigeração que desktops.
Apple com memória unificada é o contraste evidente; Intel, AMD e Qualcomm também disputam. PCs NPU enfatizam eficiência e mobilidade; Spark, modelos, CUDA, criação e jogos. A vantagem Nvidia é o caminho familiar a sistemas maiores, não uma fórmula ideal para todos.
Local é escolha de execução, não privacidade automática
Modelos locais podem processar arquivos sem envio, operar offline em tarefas suportadas, evitar tarifas remotas e a ida e volta pela rede. Nuvem oferece modelos grandes mantidos centralmente sem equipamento especial. Na prática, o arranjo pode ser híbrido.
Um modelo local classifica, recupera contexto permitido ou retira detalhes sensíveis, enviando uma solicitação restrita. O plano Microsoft considera capacidade, privacidade, hardware e política. Uma base pessoal organiza informação aprovada sem conceder acesso ilimitado.
Criadores preservam material inicial, desenvolvedores testam quantizados em código privado, trabalhadores usam pastas selecionadas. Busca, análise, sincronização, contas e raciocínio especializado ainda podem transmitir. Inferência local não significa ausência de fluxos remotos.
Custos também permanecem: dispositivo, energia, atualização e gestão. A comparação deve contar revisão de permissões, correções e manutenção, não apenas API evitada.
Isolamento Windows não prova correção
No evento, a Microsoft declarou Execution Containers, MXC, disponível de forma geral no Windows 11. Políticas limitam arquivos, rede e recursos com processos, sessões, máquinas virtuais e contêineres WSL. É fronteira de execução, não capacidade computacional.
Identidades próprias, poucos privilégios iniciais, concessões explícitas, revogação e bloqueio de agentes assinados não confiáveis limitam consequências. Um agente de código precisa de projeto e serviço, não de documentos pessoais e todos os aplicativos autenticados. Agent 365 acrescenta descoberta, identidade e governança da organização, sem substituir o limite local.
Segundo a Nvidia, OpenShell conecta runtime à segurança Windows, aplica políticas e oculta informações identificáveis antes de certas requisições à nuvem. Permite hibridismo, não garantia de tudo local. Instruções ocultas em páginas, documentos e interfaces ainda manipulam agentes. A contenção reduz recursos alcançáveis, não torna o modelo infalível.
O suporte atual listado incluía Codex, GitHub Copilot, OpenClaw, Replit, LM Studio, OpenShell e Unsloth AI. Claude Code, Hermes Agent, Manus, Perplexity, Raycast e Simular eram planejados. Roteiro não é disponibilidade, e suporte pode variar de conector experimental a produto estável gerenciado.
O que transforma lançamento em plataforma
Primeiro, análises independentes de dispositivos finais devem medir duração contra Apple, notebooks com GPU Nvidia dedicada, NPU e nuvem. Se calor ou bateria prejudicarem sessões, desktops podem ser melhores para agentes contínuos.
Segundo, aplicações precisam de instalação confiável, catálogo, atualizações, logs, permissões e recuperação. Testes devem explorar injeção, elevação, ferramentas maliciosas, vazamentos e fronteiras de apps. Sucesso não é zero falhas, mas ataques limitados, correção rápida, incidentes visíveis e controles claros.
Aprovações demais destroem utilidade; permissões amplas enfraquecem isolamento. Logs devem explicar tentativas, ferramentas, dados e aprovação humana sem copiar conteúdo privado sem controle. Ferramentas de junho e anúncios de outubro são base, não equilíbrio resolvido.
Terceiro, implantações perto do Ignite de novembro e depois precisam mostrar tarefas delimitadas úteis: código privado, documentos regulados, mídia confidencial ou aplicativos antigos autorizados. Economia de nuvem deve ser comparada a equipamento e gestão, não apenas repetir parceiros.
Spark pode funcionar como estação especializada de criadores e desenvolvedores mesmo sem agentes persistentes virarem critério geral de compra. A visão maior depende de software útil com acesso suficiente, corrigível e interrompível. A memória permite o experimento, não decide o resultado.
Fontes
Lançamento RTX Spark · Segurança de agentes Windows · Plano de inteligência híbrida · Referência sobre bases de conhecimento · Reportagem independente · Ferramentas de junho