
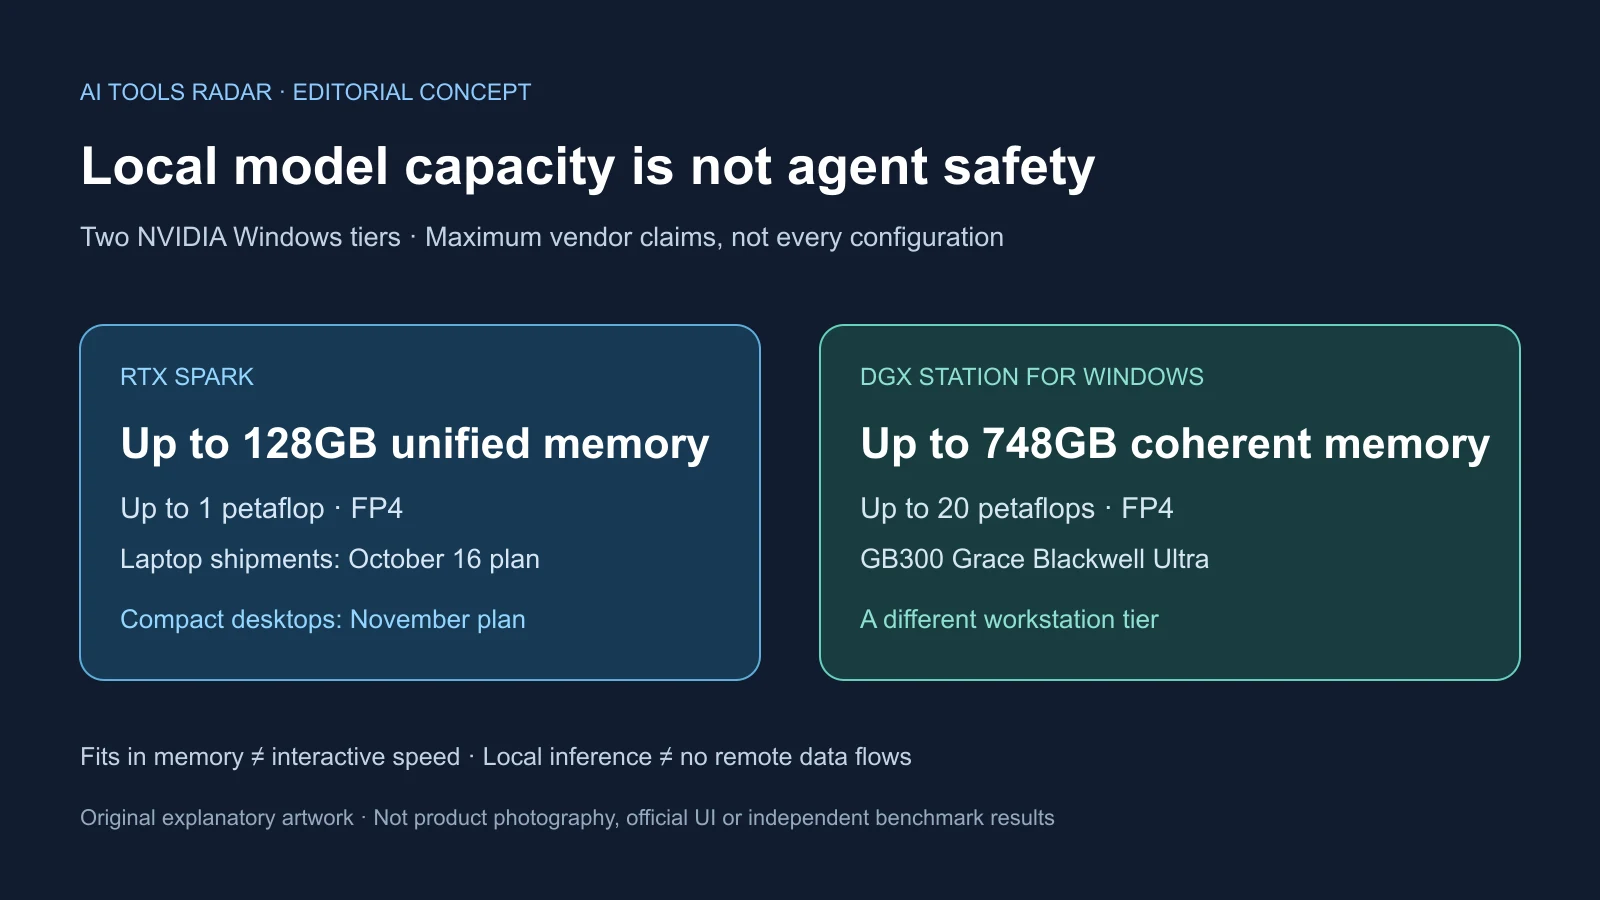
RTX Spark de Nvidia est passé de la promesse de juin à un lancement Windows daté le 7 octobre 2026. Jensen Huang et Satya Nadella l’ont présenté à San Francisco pour exécuter modèles et agents près des fichiers et applications. Les portables étaient précommandables, pour des livraisons prévues dès le 16 octobre ; les bureaux compacts étaient attendus en novembre. Cela ne prouve pas que chaque appareil et intégration soit déjà chez les clients.
La proposition est une grande mémoire locale avec CUDA, pas une fonction de PC servie à distance. Les machines finales doivent transformer capacité en travail interactif, durable et administrable. Taille du modèle, vitesse de lancement, sécurité et baisse réelle du cloud exigent des preuves différentes.
Ce que contient la catégorie
Asus, Dell, HP, Lenovo, MSI et Microsoft ouvraient les commandes ; Acer et Gigabyte étaient prévus. Microsoft a présenté Surface Laptop Ultra pour développeurs mobiles et créateurs, et le compact Surface RTX Spark Dev Box pour expériences et travail continu. Plusieurs constructeurs font une catégorie, pas une machine identique.
RTX Spark combine GPU Blackwell RTX jusqu’à 6 144 cœurs et CPU Grace jusqu’à 20. Nvidia annonce interface 600GB/s, jusqu’à 128GB unifiés et un pétaflop FP4. FP4 est un format numérique de quatre bits ; ce pic ne mesure pas toutes les applications.
CPU et GPU partagent une réserve, réduisant les copies entre mémoires. Microsoft affirme que Surface Laptop Ultra exécute des modèles de plus de 120 milliards de paramètres. Tenir où les GPU ordinaires échouent ne signifie pas répondre vite. Architecture, quantification, contexte, runtime, stockage et bande passante comptent.
CUDA maintient une continuité vers les grands systèmes, WSL conserve Linux. Nvidia annonce aussi AV1, encodage et décodage 4:2:2, ray tracing, DLSS et jeu à haute fréquence. Création et jeu élargissent le public face à une demande d’agents persistants encore incertaine.
Un petit bureau reste disponible quand le portable dort ou voyage. Indexation autorisée, développement programmé et médias pourraient profiter. L’usage ne prouve pas que tout agent soit prêt. Refroidissement, mémoire, puissance et logiciels varient selon les modèles.
La station est un autre niveau
DGX Station Windows se place au-dessus. Nvidia décrit GB300 Grace Blackwell Ultra Desktop Superchip, jusqu’à 748GB cohérents, 20 pétaflops FP4 et modèles jusqu’à mille milliards de paramètres.
Ce sont des caractéristiques d’un autre système, pas des portables. Windows relie grande recherche locale, applications et gestion d’entreprise avec Linux via WSL. L’échelle ne prouve pas la vitesse pour toute architecture de mille milliards ni ne remplace le cloud pour entraînement, collaboration, déploiement et plus grande inférence.
Microsoft distingue Copilot+ quotidiens, catégorie de constructeurs d’IA et stations. Foundry Local choisit CUDA, DirectML, NPU ou CPU selon matériel. Toute application Windows n’a donc pas besoin de Spark ou d’une même architecture.
Les chiffres MacBook ont des conditions
Microsoft a comparé certains systèmes au MacBook Pro 16 pouces, M5 Pro et 64GB. Il revendique un premier token livré 2,1 fois plus vite, des images 4,3 fois et des vidéos 6,2 fois.
Le test linguistique était commandé par Microsoft, sur Spark de présérie, Qwen3.5 27B et instruction fixe de 8 192 tokens. Nvidia a testé images et vidéos avec charges NVFP4. Ces conditions doivent accompagner les rapports, pas devenir une preuve indépendante pour tous modèles, applications, batteries et produits.
Après le 16 octobre comptent inférence soutenue, ventilateurs, chaleur, batterie et pression mémoire avec les applications ordinaires. Un pic bref ne montre pas des heures d’indexation et de travail. Les portables fins refroidissent moins que bureaux et stations.
Apple à mémoire unifiée est la comparaison évidente, mais Intel, AMD et Qualcomm concurrencent aussi. Les PC NPU privilégient efficacité et mobilité, Spark grands modèles, CUDA, création et jeu. L’atout Nvidia est le chemin familier vers ses grands systèmes, pas une formule idéale universelle.
Le local est un placement, pas une confidentialité automatique
Les modèles locaux traitent certains fichiers sans envoi, travaillent hors ligne pour les tâches prises en charge, évitent facturation distante et aller-retour réseau. Le cloud offre plus de capacités centralement maintenues sans matériel spécial. L’architecture pratique peut être hybride.
Le modèle local classe, retrouve du contexte autorisé ou retire des détails sensibles puis envoie une requête réduite. Le plan Microsoft considère capacité, confidentialité, matériel et règles. Une base personnelle organise l’information approuvée sans autoriser l’ensemble des sources.
Les créateurs gardent leurs médias, les développeurs testent des modèles quantifiés sur code privé, les travailleurs choisissent des dossiers. Recherche, analyse, synchronisation, comptes et raisonnement spécialisé peuvent toutefois transmettre. Inférence locale ne veut pas dire aucun flux distant.
Les coûts restent aussi : appareil, énergie, mises à jour et gestion. La comparaison doit inclure examen des permissions, corrections et maintenance, pas seulement API économisée.
L’isolation Windows ne prouve pas la justesse
Microsoft a déclaré Execution Containers, MXC, généralement disponible sur Windows 11. Les politiques limitent fichiers, réseau et ressources avec processus, sessions, machines virtuelles et conteneurs WSL. C’est une frontière d’exécution, distincte du calcul.
Identités d’agents, faibles privilèges initiaux, autorisations explicites, révocation et blocage d’agents signés non fiables limitent les conséquences. Un agent de code a besoin d’un projet et service, pas des documents privés et de toutes les applications connectées. Agent 365 ajoute découverte, identité et gouvernance sans remplacer la limite locale.
Selon Nvidia, OpenShell connecte runtime et sécurité, applique les règles et masque des informations identifiantes avant certaines requêtes cloud. Cela permet l’hybride, pas tout-local garanti. Des instructions cachées dans pages, documents ou interfaces manipulent encore l’agent. Le confinement réduit les ressources atteignables, pas les erreurs du modèle.
Microsoft citait Codex, GitHub Copilot, OpenClaw, Replit, LM Studio, OpenShell et Unsloth AI comme actuels ; Claude Code, Hermes Agent, Manus, Perplexity, Raycast et Simular comme prévus. Une feuille de route n’est pas disponibilité et le support peut être expérimental ou mature.
Du lancement à la plateforme
D’abord, les tests indépendants de série doivent comparer travail soutenu avec Apple, portables à GPU Nvidia dédié, NPU et cloud. Si chaleur et batterie limitent les sessions, le bureau pourrait mieux convenir aux agents continus.
Ensuite, il faut installation fiable, catalogues, mises à jour, journaux, permissions et récupération. Les tests doivent examiner injection, élévation, outils malveillants, fuites et interactions des conteneurs. Le succès n’est pas zéro défaut, mais attaque contenue, correction rapide, visibilité et contrôle compris.
Trop d’accords rendent inutilisable, trop de droits affaiblissent l’isolation. Les journaux doivent expliquer tentatives, outils, données et approbation sans copies privées incontrôlées. Outils de juin et annonces d’octobre sont une fondation, pas un équilibre résolu.
Enfin, les déploiements autour d’Ignite en novembre et après doivent montrer des tâches bornées : code privé, documents réglementés, médias confidentiels ou anciennes applications approuvées. Les économies cloud se comparent aux appareils et à la gestion, pas à une liste de partenaires.
Spark peut réussir comme station spécialisée même sans agents persistants devenus critère d’achat général. La vision dépend d’un logiciel utile avec assez d’accès, mais corrigeable et arrêtable. La mémoire permet l’expérience, elle ne la tranche pas.
Sources
Lancement RTX Spark · Sécurité des agents Windows · Plan d’intelligence hybride · Référence sur les bases de connaissances · Article indépendant · Outils de juin