
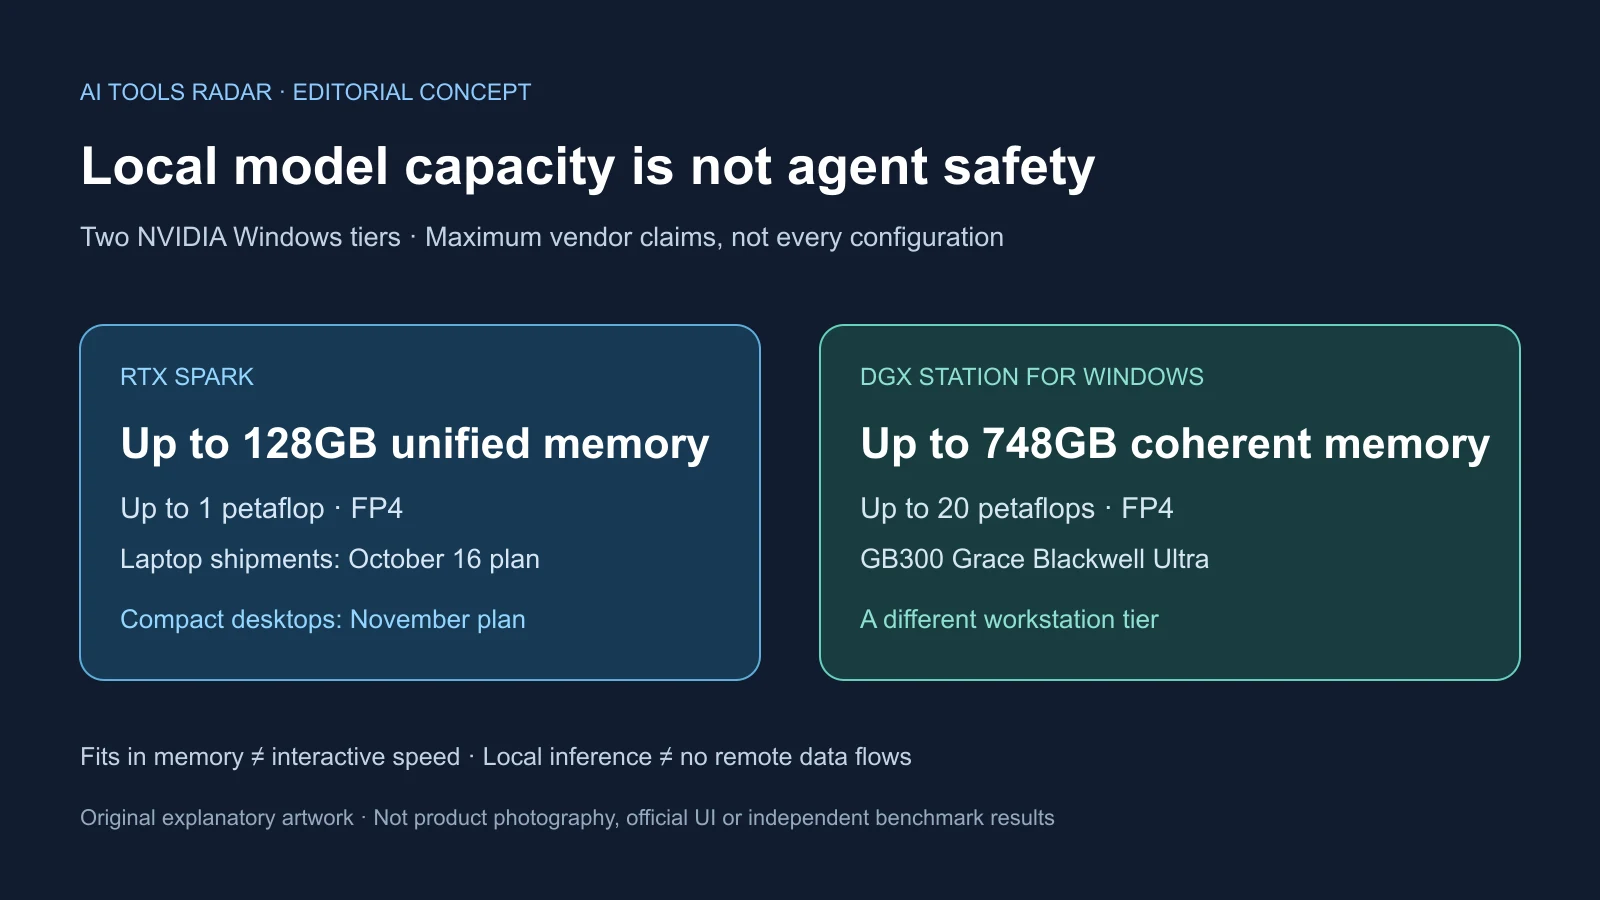
RTX Spark Nvidii przeszedł 7 października 2026 r. od czerwcowej obietnicy do premiery Windows z datami. Jensen Huang i Satya Nadella przedstawili w San Francisco sprzęt dla modeli i agentów działających obok plików oraz aplikacji użytkownika. Laptopy można było zamawiać, dostawy planowano od 16 października, małe desktopy na listopad. Nie znaczy to, że klienci już mają wszystkie urządzenia i integracje.
Propozycją jest duża pamięć lokalna z CUDA, nie kolejna funkcja PC obsługiwana zdalnie. Gotowe maszyny muszą zamienić pojemność w interaktywną, trwałą i zarządzalną pracę. Wielkość modelu, szybkość z premiery, bezpieczeństwo i ograniczenie chmury wymagają różnych dowodów.
Co obejmuje nowa kategoria
Asus, Dell, HP, Lenovo, MSI i Microsoft oferowały zamówienia, Acer i Gigabyte były planowane. Microsoft pokazał Surface Laptop Ultra dla mobilnych programistów i twórców oraz mały Surface RTX Spark Dev Box dla eksperymentów i pracy ciągłej. Wielu dostawców oznacza kategorię, nie identyczną maszynę.
RTX Spark łączy GPU Blackwell RTX do 6144 rdzeni i Grace CPU do 20. Nvidia podaje interfejs 600GB/s, do 128GB pamięci zunifikowanej i do jednego petaflopa FP4. To czterobitowy format liczbowy; szczyt nie mierzy szybkości każdej aplikacji.
CPU i GPU współdzielą pulę, ograniczając kopiowanie między pamięciami. Microsoft twierdzi, że Surface Laptop Ultra uruchomi lokalnie modele o ponad 120 mld parametrów. Pojemność pomaga zmieścić modele niedostępne zwykłym GPU, nie gwarantuje szybkiej odpowiedzi. Architektura, kwantyzacja, kontekst, środowisko, dysk i pasmo nadal decydują.
CUDA daje ciągłość z większymi systemami, WSL zachowuje Linux. Nvidia reklamuje też AV1, kodowanie i dekodowanie 4:2:2, ray tracing, DLSS i wysokie klatkaże. Twórczość i gry poszerzają rynek przy niepewnym popycie na stałych agentów.
Mały desktop pozostaje dostępny, gdy laptop śpi lub podróżuje. Pomóc mogą zatwierdzone indeksowanie, zadania rozwojowe i media. Zastosowanie nie dowodzi gotowości każdego agenta. Chłodzenie, pamięć, limity mocy i oprogramowanie różnią się między projektami.
Stacja robocza jest osobnym poziomem
DGX Station dla Windows leży wyżej. Nvidia opisuje GB300 Grace Blackwell Ultra Desktop Superchip, do 748GB pamięci koherentnej, 20 petaflopów FP4 i modele do biliona parametrów.
To twierdzenia o innym systemie, nie laptopach. Windows łączy lokalne badania z aplikacjami i administracją firmy, zachowując Linux przez WSL. Skala nie ustala szybkości każdej architektury bilionowej ani nie zastępuje treningu, współpracy, wdrożeń i największej inferencji w chmurze.
Microsoft odróżnia codzienne Copilot+ od kategorii budujących AI i stacji. Foundry Local wybiera CUDA, DirectML, NPU lub CPU według sprzętu. Nie każda aplikacja Windows AI musi więc zależeć od Spark i jednej architektury.
Liczby MacBooka wymagają warunków
Microsoft porównywał wybrane Spark z 16-calowym MacBookiem Pro M5 Pro i 64GB. Podawał 2,1-krotnie szybsze dostarczenie pierwszego tokenu, 4,3-krotnie szybsze obrazy i 6,2-krotnie wideo.
Test językowy zamówił Microsoft, używając przedprodukcyjnego Spark, Qwen3.5 27B i stałego promptu 8192 tokenów. Nvidia badała obraz i wideo w zadaniach dostosowanych do NVFP4. Warunki są częścią wyniku, nie niezależną przewagą we wszystkich modelach, aplikacjach, bateriach i obudowach.
Po 16 października liczą się ciągła inferencja, wentylatory, temperatury, bateria i presja pamięci wraz ze zwykłymi aplikacjami. Krótki szczyt nie pokazuje godzin indeksowania, obliczeń i normalnego użycia. Cienkie laptopy chłodzą gorzej od desktopów.
Apple ze wspólną pamięcią jest oczywistym porównaniem, ale Intel, AMD i Qualcomm też konkurują. PC z NPU stawiają na efektywność i mobilność; Spark na modele, CUDA, twórczość i gry. Atut Nvidii to znana ścieżka do większych maszyn, nie jeden wzór dobry dla wszystkich.
Lokalność to wybór miejsca, nie gwarancja prywatności
Lokalny model może przetwarzać wybrane pliki bez wysyłania, pracować offline w obsługiwanych zadaniach, unikać opłat i opóźnienia sieci. Chmura daje większe centralnie utrzymywane możliwości bez specjalnego sprzętu. Praktyczna architektura bywa mieszana.
Model lokalny klasyfikuje, wyszukuje dozwolony kontekst lub usuwa wrażliwe dane i wysyła zawężone żądanie. Plan Microsoftu kieruje według możliwości, prywatności, sprzętu i zasad. Osobista baza wiedzy porządkuje zatwierdzone informacje, nie uprawnia do wszystkiego.
Twórcy mogą zachować materiał, programiści testować modele skwantowane z prywatnym kodem, a pracownicy używać wybranych folderów. Wyszukiwanie, analityka, synchronizacja, konta i specjalne rozumowanie mogą jednak przesyłać dane. Lokalna inferencja nie znaczy brak przepływów zdalnych.
Koszty też nie znikają: sprzęt, energia, aktualizacje i zarządzanie pozostają. Trzeba liczyć przegląd uprawnień, korekty i utrzymanie, nie same oszczędności API.
Izolacja Windows nie dowodzi poprawności
Na wydarzeniu Microsoft ogłosił ogólną dostępność Execution Containers, MXC, w Windows 11. Polityki ograniczają pliki, sieć i zasoby przez procesy, sesje, maszyny wirtualne lub kontenery WSL. To granica wykonania, nie moc obliczeniowa.
Osobne tożsamości, małe uprawnienia początkowe, jawne zasoby, odwołanie dostępu i blokowanie niezaufanych podpisanych agentów ograniczają skutki. Programujący agent potrzebuje projektu i serwera, nie prywatnych dokumentów i wszystkich zalogowanych aplikacji. Agent 365 dodaje firmowe wykrywanie, tożsamość i nadzór, nie zastępuje lokalnej granicy.
Według Nvidii OpenShell łączy środowisko z Windows, wymusza polityki i ukrywa dane identyfikujące przed wybranymi żądaniami chmury. Umożliwia hybrydę, nie całkowitą lokalność. Ukryte instrukcje stron, dokumentów i interfejsów nadal manipulują agentem. Izolacja ogranicza zasoby, nie usuwa błędów modelu.
Obecne wsparcie obejmowało Codex, GitHub Copilot, OpenClaw, Replit, LM Studio, OpenShell i Unsloth AI. Claude Code, Hermes Agent, Manus, Perplexity, Raycast i Simular planowano. Mapa drogowa nie jest dostępnością, a wsparcie może oznaczać eksperymentalne połączenie lub dojrzały produkt.
Jak premiera stanie się platformą
Po pierwsze niezależne testy gotowych urządzeń muszą porównać długą pracę z Apple, oddzielnymi GPU, NPU i chmurą. Przy ograniczeniach cieplnych lub baterii lepszy dla stałego agenta może być desktop.
Po drugie potrzeba instalacji, katalogów modeli, aktualizacji, logów, jasnych praw i odtwarzania. Testować należy wstrzyknięcia, eskalację, złośliwe narzędzia, wycieki i granice aplikacji. Sukces to ograniczony atak, szybka poprawka, wykrywalność i zrozumiała kontrola, nie zero wad.
Nadmiar zgód niszczy użyteczność, szerokie prawa izolację. Logi firmy muszą wyjaśnić próby, narzędzia, dane i zgodę człowieka bez nowych niekontrolowanych kopii prywatnych treści. Czerwcowe narzędzia i październikowe zapowiedzi są podstawą, nie rozwiązaniem.
Po trzecie wdrożenia wokół listopadowego Ignite i później powinny pokazać konkretne ograniczone zadania: prywatny kod, regulowane dokumenty, tajne media lub zatwierdzone stare aplikacje. Oszczędność chmury trzeba zestawić z urządzeniami i zarządzaniem, nie listą partnerów.
Spark może wygrać jako specjalistyczna stacja twórców, nawet bez powszechnego wymogu stałych agentów. Szersza wizja zależy od przydatnego oprogramowania z wystarczającym dostępem, które można poprawić i zatrzymać. Pamięć umożliwia próbę, ale jej nie rozstrzyga.
Źródła
Premiera RTX Spark · Bezpieczeństwo agentów Windows · Plan hybrydowej inteligencji · Materiały o bazach wiedzy · Niezależna relacja · Narzędzia czerwcowe