
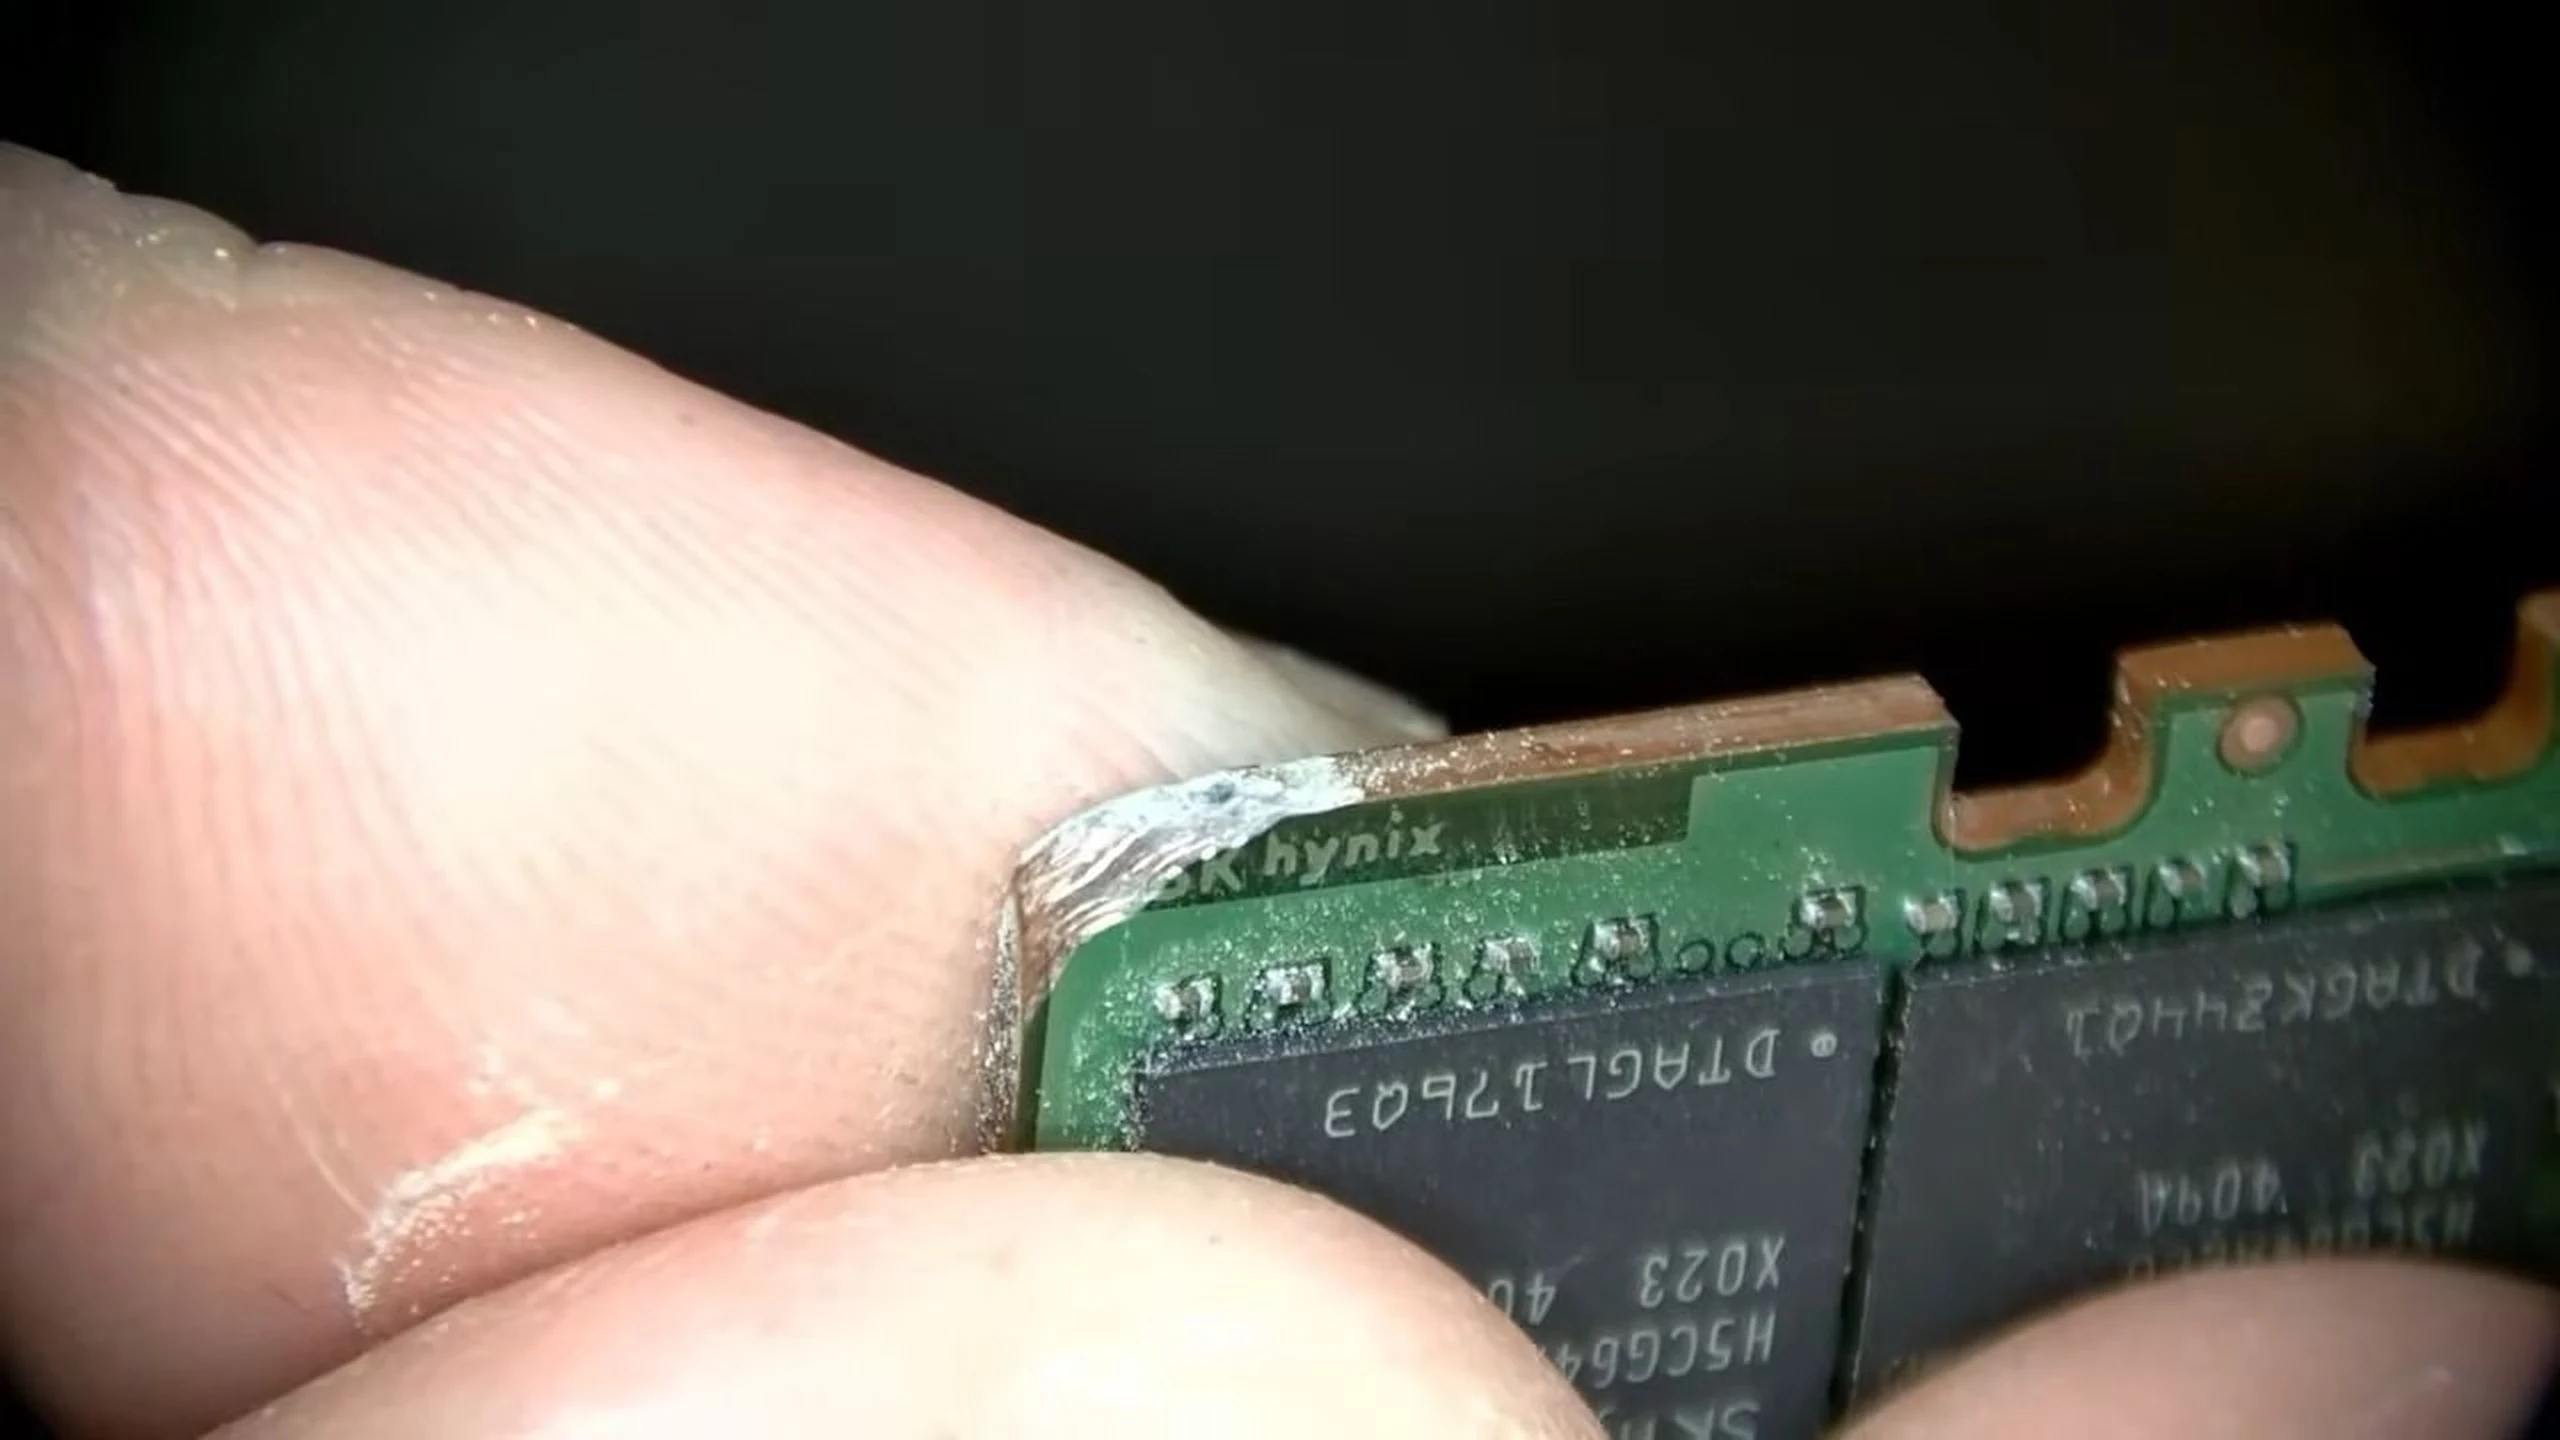
Ein Serverspeichermodul kann Hunderte Gigabyte brauchbaren DRAM enthalten und für seinen Host trotzdem unbrauchbar sein, weil ein kleines Stromversorgungsbauteil oder eine Verbindung ausfällt. NorthWestRepairs erste dokumentierte DDR5-Reparatur prüfte diesen Unterschied an einem 128-GB-SK-hynix-DDR5-RDIMM und einem 256-GB-Samsung-Modul, zusammen 384 GB.
Techniker Tony, eher für Grafikkartenreparaturen bekannt, stellte beide über unterschiedliche Diagnosewege wieder her. Der angeblich fünfstellige Ersatzwert erklärt den Aufwand, doch die Berichte enthalten weder Rechnung noch genaue Teilenummernpreise. Der Fall zeigt Reparierbarkeit, nicht dass jedes teure DIMM repariert werden sollte oder beide Module für kritische Produktion qualifiziert wurden.
Eine Reparatur folgte dem Lot, die andere der Stromversorgung
Beide Module kamen mit vermuteten physischen Schäden; Sichtprüfung isolierte zunächst keinen eindeutigen Fehler. Ähnliche Symptome entstehen durch Leiterbahnen, Lötstellen, Hilfsschaltungen, DRAM-Gehäuse oder Konfigurationsdaten. Optische Unversehrtheit bedeutet keine elektrische Unversehrtheit.
Beim 128-GB-Modul fand ein Datenleitungstester kein klares Problem. Tony nutzte Flussmittel und kontrollierte Heißluft zum Reflow, danach funktionierte es. Reflow erhitzt vorhandenes Lot; Reballing entfernt den Chip, reinigt Kontakte, setzt neue Lötkugeln und montiert ihn erneut. Letzteres ist invasiver und verlangt präzise Ausrichtung und Temperaturkontrolle. Die erste Wiederherstellung deutet auf eine Verbindung hin, bestätigt aber keine einzelne Lötstelle oder Komponente als alleinige Ursache.
Das 256-GB-Modul zeigte eingebaut kein Lebenszeichen; im Wärmebild fehlte ein aussagekräftiges Muster. Die kalte Platine lenkte den Blick zur Versorgung statt nur zum Datenkanal. Tony untersuchte den SPD-EEPROM für Initialisierungskonfiguration und den PMIC zur Regelung und Verteilung der DDR5-Spannungen.
Reflow mehrerer Bauteile und Reballing verdächtiger Komponenten lösten das Problem nicht. Spannungseinspeisung und Wärmebeobachtung halfen, einen Kurzschluss zu entdecken. Schäden am Platinenrand und ein defekter Kondensator wurden behandelt, doch erst ein Ersatz-PMIC ermöglichte Einschalten und Memory Training.
Training kalibriert Timings und Signalverhalten, damit die Plattform installierten Speicher initialisieren kann. Bei einer toten Platine ist das ein relevanter Meilenstein, keine Messung dauerhafter Stabilität. Der zweite Fall war somit kein spektakulärer Einzeltausch: Inspektion, Messung, Thermikdiagnose, Platinenarbeit, Ersatz und erneute Tests gehörten zusammen.
DDR5 konzentriert Ersatzwert und neue Fehlerbereiche
RDIMM bedeutet Registered Dual Inline Memory Module. Zusätzliche Logik puffert Befehle zwischen Controller und DRAM, reduziert elektrische Last und unterstützt höhere Kapazitäten sowie mehr bestückte Steckplätze. Die Module sind nicht mit günstigen ungepufferten Desktop-UDIMMs austauschbar. ECC erkennt und korrigiert bestimmte Fehler als weitere Schutzfunktion, garantiert aber nicht die Korrektur jedes Hardwaredefekts.
Datenbanken, Virtualisierung, Wissenschaft und KI benötigen dauerhafte Integrität. Stille Fehler können lange Jobs beschädigen, während ein Hilfsbauteil das ganze dichte Modul deaktiviert, obwohl die meisten Speicherchips intakt sind. Entsorgung vernichtet dann deutlich mehr potenziellen Wert als das ausgefallene Teil.
Bei DDR5 ist lokales Energiemanagement zentral. Microns Material beschreibt PMICs auf jedem Modul und damit Spannungsregelung auf dem DIMM. Das verbessert lokale Kontrolle, erweitert aber die Diagnose. Initialisierungsfehler können PMIC, Kondensatoren, Leiterbahnen, EEPROM, Register oder Lot betreffen, nicht unbedingt DRAM-Zellen. Der zweite Fall zeigt den Unterschied, ohne seine Häufigkeit zu bestimmen.
Werkzeuge aus der GPU-Reparatur helfen: Widerstandsmessung, Spannungseinspeisung, Wärmebild, Oszilloskop, Platinenansicht und Spenderteile grenzen Fehler ein. Tony nutzte ein Unified DDR Flasher Main Board mit RDIMM-Erweiterung; spezielle Adapter und Konfigurationszugriff sind wichtig. Werkstätten benötigen auch bekannte funktionierende Plattformen, Leser, Thermikausrüstung und passende Teile. Löten allein genügt nicht.
Kompatibilität reicht über die Bauform hinaus. Ein Ersatz-PMIC braucht möglicherweise korrekte Herstellerprogrammierung, Firmware, Grenzwerte und Plattformkonfiguration. Spender liefern knappe Teile, aber mit unsicherer Vorgeschichte; Fälschungen oder Fehlprogrammierung erschweren Validierung. Überhitzung kann Mehrlagenplatinen verziehen, Nachbarchips oder intakte Verbindungen an schnellen Signalbahnen schädigen. Reflow kann außerdem nur vorübergehend helfen, ohne die ursprüngliche Ursache zu erklären.
KI-Nachfrage verändert die Rechnung, nicht den Preisnachweis
KI-Infrastruktur nutzt HBM nahe Beschleunigern und gewöhnlichen DRAM bei Host-Prozessoren. Es sind verschiedene Produkte, deren Wirtschaftlichkeit durch Nachfrage und Lieferantenverteilung verbunden ist. Fertigung hängt von Prozesskompatibilität, Kundenverpflichtungen, Margen und Bedarf ab. Server- und HBM-Priorität kann anderswo verknappen, ohne alle Speicherarten direkt austauschbar zu machen.
TrendForce führte im Januar die Serverpriorität auf KI-Nachfrage, geringe Bestände und Cloud-Anbieter zurück, die mehr verfügbares Bitwachstum sichern. Es prognostizierte für Q1 2026 gegenüber dem Vorquartal 55–60 % höhere konventionelle DRAM-Vertragspreise und über 60 % bei Server-DRAM. Das waren Marktprognosen, keine belegten Kaufpreise der beiden Module.
Die Juli-Diskussion über Q3-Verträge beschrieb weiteren Druck durch KI- und Serverpriorität. Der Septemberausblick sah weiterhin Unterstützung für Q4-Anstiege trotz begrenzter Kaufkraft der Verbraucher. Die Berichte liefern Kontext, bestätigen aber weder den angeblichen Paarwert unabhängig noch künftige Knappheit.
Unternehmensverträge, Händlerlisten und Spotangebote können stark abweichen. Nicht nur Kapazität bestimmt den Preis: Geschwindigkeit, Rank-Aufbau, Dichte, Stapelung, Qualifikation und Verfügbarkeit zählen. 256 GB sind nicht zwangsläufig ein 128-GB-Produkt zum doppelten Preis. Ohne genaue Teile und Kaufbedingungen bleibt der dramatische Wert eine berichtete Behauptung.
Lieferzeit kann ebenso wichtig sein. Ein Server wartet auf ein qualifiziertes Teil, arbeitet mit weniger Kapazität oder benötigt Workload-Verlagerung; das bindet Personal und knappe Infrastruktur. Erwarteter Reparaturwert berücksichtigt Diagnosekosten, Erfolgschance, Durchlaufzeit, Ersatzverfügbarkeit und Betriebsunterbrechung, nicht nur Kondensator gegen DIMM.
Dies ähnelt GPU- und Industriesteuerungsreparatur, beweist aber keinen reifen Markt. Unklar bleiben reparierbare Fehlermengen und Besitzer ohne Garantie oder Support. Sinkende Preise oder verfügbare qualifizierte Lagerware können ein neues Modul mit planbarer Unterstützung wieder überlegen machen. Ein segmentierter Markt aus Diagnose teurer und Ersatz billiger Module ist plausibler als universelle Reparatur.
Das schwierige Produkt ist ein vertrauenswürdiges repariertes Modul
Einmalige Initialisierung beginnt die Qualifikation. Serverspeicher arbeitet lange unter Dauerverkehr und Temperaturwechseln. Eine grenzwertige Verbindung kann Boot überstehen und im Temperaturzyklus versagen; nachbearbeitetes Material verhält sich unter Last anders. Interne DRAM-Defekte, Mehrlagenschäden oder fehlende proprietäre Teile können praktisch unreparierbar sein, auch wenn Kondensator oder PMIC zugänglich wären.
Langzeittests müssten Adressen, Datenmuster, Temperaturen und Betriebszustände sowie korrigierte und unkorrigierbare Fehler erfassen. Controller, Firmware, Kanalbestückung und Geschwindigkeiten unterscheiden sich: Training auf einem Server garantiert nichts auf einem anderen. Der Test sollte der Kundenkonfiguration entsprechen. Microns RDIMM-Leitfaden betont Unternehmenszuverlässigkeit und konstante Leistung, mehr als einige Desktop-Testdurchläufe.
Nachverfolgbarkeit verbindet Eingriff und Evidenz. Modulkennung, Symptome, Messungen, ersetzte Teile, Temperaturprofil, Testplattform, Firmware und Ergebnisse gehören dokumentiert. Unautorisierte Nacharbeit kann Garantie beenden, Support erschweren oder Beschaffungsvorschriften verletzen. Manche Betreiber wählen daher vernünftigerweise genehmigten Ersatz trotz attraktivem Reparaturangebot.
Ein Geschäft könnte lokale Platinen- oder Versorgungsfehler von breiten Chip- oder internen DRAM-Defekten trennen und vor wachsendem Aufwand Angebote machen. Diagnosegebühren, erfolgsabhängige Kosten und klare Qualifikationsgrenzen sind glaubwürdiger als bedingungslose Rettung. Wiederholte dokumentierte Fälle, Erfolgsquoten und Testdauer rechtfertigen Adapter, Serverplattformen, Programmiergeräte und Teilevorräte, nicht ein dramatisches Video.
Gemeinsame Validierung, Fehlerlogs, Stress- und Temperaturzyklen sowie bedingte Garantien erleichtern Vergleich. Hersteller könnten unabhängige Arbeit nur langsam unterstützen, weil ihre Qualifikation kontrollierte Fertigung und Rückverfolgbarkeit verlangt. Transparente Aufbereiter könnten dennoch Abstufungen etablieren: geprüfter Servereinsatz, Labor/Entwicklung, temporärer Ersatz oder Teilespender. Gleichwertigkeit darf erst nach Evidenz gelten.
Die dauerhafte Frage ist nicht, ob Tony zwei Platinen startete. Laut Bericht tat er es. Können Spezialisten lokale Reparatur wiederholt in einen Dienst verwandeln, dessen Kosten und Risiko günstiger sind als Ersatz? KI-Infrastrukturdruck kann Wegwerfkomponenten zu wiederherstellbaren Assets machen. Das Vertrauen für den Wiedereinsatz neben Kundendatenbanken oder KI-Checkpoints muss jedoch getrennt verdient werden.
Quellen und weiterführende Lektüre
Reparaturbericht von Tom’s Hardware; TrendForce-Ausblick vom Januar; Micron zur DDR5-Spannungsregelung; Micron-RDIMM-Leitfaden; TrendForce zu Q3-Verträgen; Septemberausblick auf Q4.