
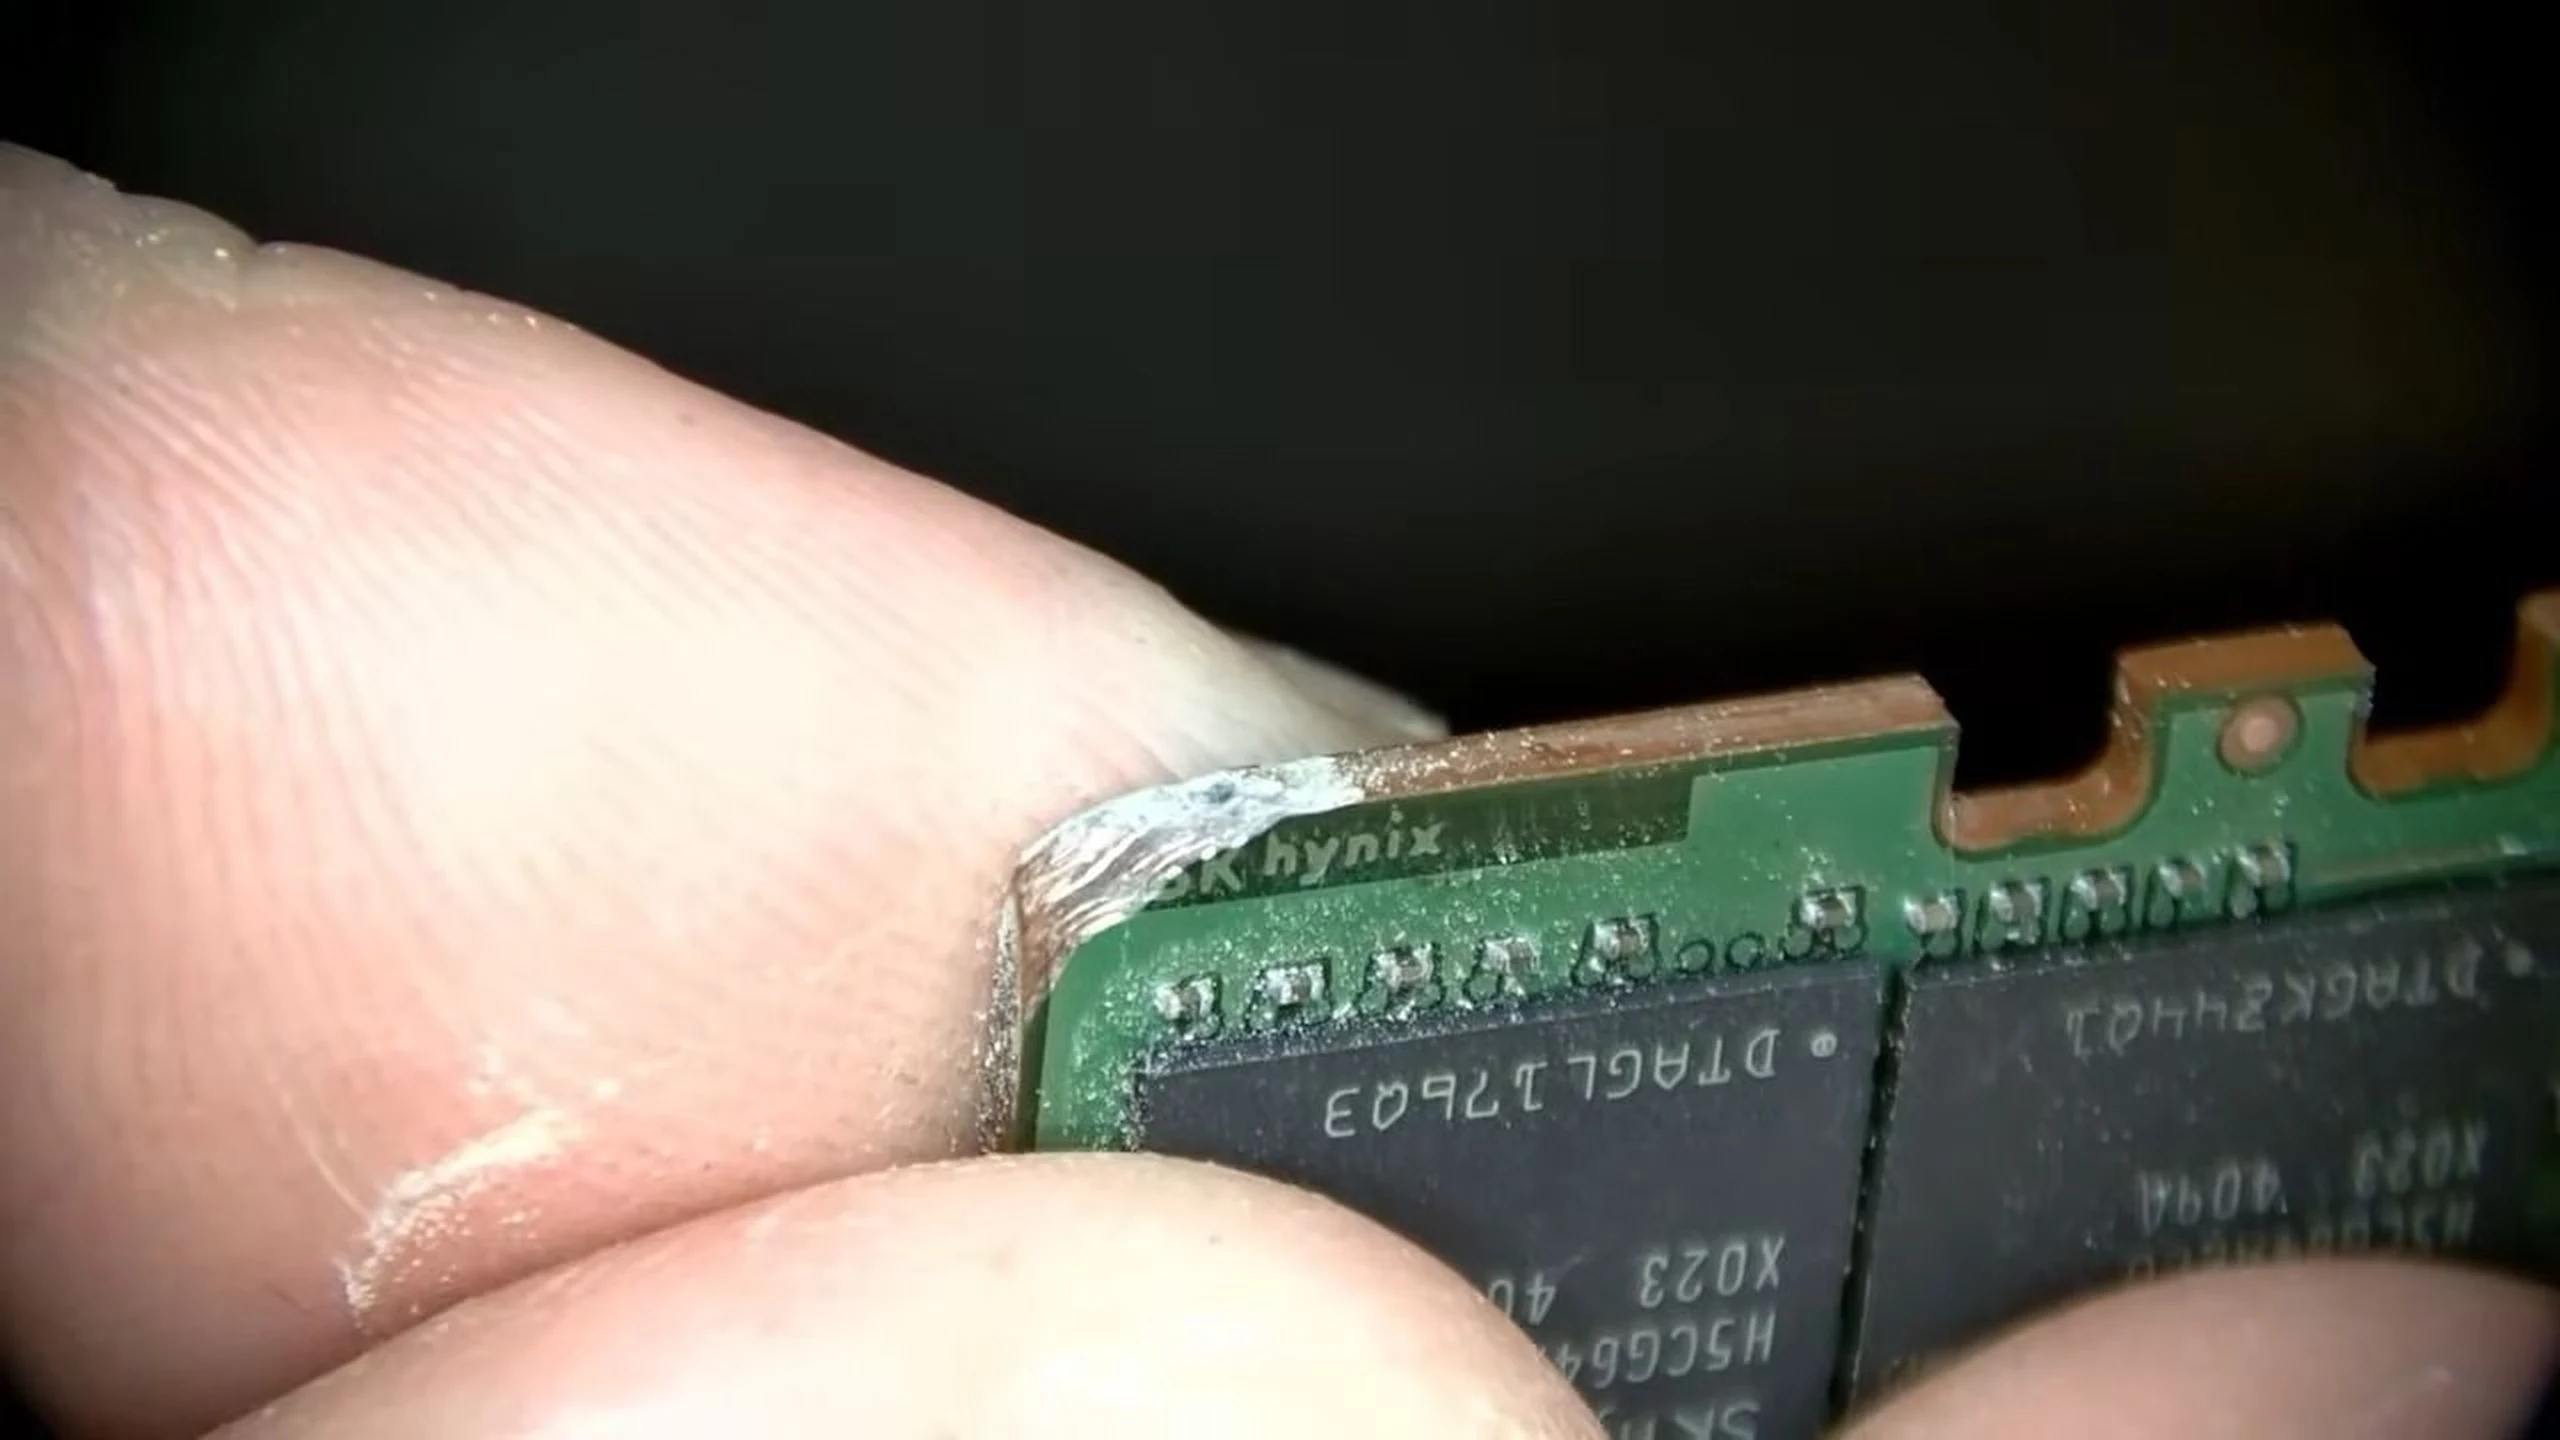
Moduł serwerowy może zawierać setki gigabajtów sprawnej pamięci DRAM, a mimo to być bezużyteczny dla hosta z powodu małego elementu zasilania lub połączenia. Pierwsza udokumentowana naprawa DDR5 NorthWestRepair sprawdziła tę różnicę na SK hynix DDR5 RDIMM 128 GB i module Samsung 256 GB, łącznie 384 GB.
Tony, znany bardziej z kart graficznych, przywrócił oba różnymi drogami diagnostycznymi. Rzekoma pięciocyfrowa wartość wymiany wyjaśnia pracochłonność, ale relacja nie podaje faktury ani dokładnych cen konkretnych części. Pokazuje możliwość naprawy, nie konieczność naprawiania każdego drogiego DIMM-u ani kwalifikację obu do krytycznej produkcji.
Jedna naprawa podążała za lutem, druga za zasilaniem
Oba moduły miały podejrzewane uszkodzenia fizyczne, lecz oględziny nie wyizolowały od razu jednoznacznej usterki. Podobne objawy powodują ścieżki, lut, obwody pomocnicze, układy DRAM lub konfiguracja. Dobry wygląd nie oznacza sprawności elektrycznej.
Tester linii danych nie znalazł wyraźnej przyczyny w 128 GB. Tony zastosował topnik i kontrolowane gorące powietrze do reflow, po czym pamięć zadziałała. Reflow ogrzewa istniejący lut; reballing usuwa układ, czyści styki, nakłada nowe kulki i montuje ponownie. Druga metoda jest bardziej inwazyjna i wymaga precyzyjnego ustawienia oraz temperatury. Odzyskanie sugeruje wadliwe połączenie, ale nie potwierdza jednej konkretnej spoiny lub obudowy jako jedynej przyczyny.
Moduł 256 GB nie reagował po instalacji, a termowizja nie pokazała istotnego ciepła. Zimna płytka skierowała uwagę na zasilanie, nie tylko kanał danych. Tony zbadał EEPROM SPD przechowujący konfigurację inicjalizacji oraz PMIC regulujący i rozdzielający napięcia DDR5.
Reflow kilku układów i reballing podejrzanych elementów nie rozwiązały problemu. Wstrzykiwanie napięcia i obserwacja termiczna ujawniły zwarcie. Naprawiono uszkodzenie krawędzi i wymieniono kondensator, ale dopiero nowy PMIC pozwolił włączyć moduł i przeprowadzić trening.
Trening kalibruje timingi i zachowanie sygnałów, umożliwiając inicjalizację. Dla martwej płytki to ważny etap, nie pomiar trwałej stabilności. Drugi przypadek nie był spektakularną wymianą jednego układu: obejmował oględziny, pomiary, diagnostykę termiczną, pracę przy płytce, wymianę i ponowne testy.
DDR5 skupia wartość wymiany i nowe obszary awarii
RDIMM oznacza registered dual inline memory module. Dodatkowa logika buforuje polecenia między kontrolerem a DRAM, zmniejszając obciążenie elektryczne i umożliwiając większą pojemność oraz więcej obsadzonych slotów. Nie jest zamienny z tanim niebuforowanym UDIMM-em desktopowym. ECC wykrywa i poprawia określone błędy jako dodatkowe zabezpieczenie, ale nie naprawia każdego defektu sprzętu.
Bazy danych, wirtualizacja, nauka i AI wymagają trwałej integralności. Cichy błąd może uszkodzić długie zadanie, a pomocniczy element wyłączyć gęsty moduł mimo sprawności większości DRAM. Wyrzucenie poświęca więcej potencjalnej wartości niż sam wadliwy element.
DDR5 szczególnie zależy od lokalnego zarządzania energią. Micron opisuje PMIC na każdym module, przenoszący regulację napięcia na DIMM. Poprawia to kontrolę, ale rozszerza diagnostykę. Brak inicjalizacji może wynikać z PMIC, kondensatorów, ścieżek, EEPROM-u, rejestru czy lutów, niekoniecznie komórek DRAM. Druga naprawa pokazuje różnicę, nie częstotliwość takich awarii.
Narzędzia z napraw GPU pomagają: pomiar rezystancji, wstrzykiwanie napięcia, termowizja, oscyloskop, widoki płytki i dawcy zawężają problem. Tony użył Unified DDR Flasher Main Board z rozszerzeniem RDIMM, pokazując rolę adapterów i dostępu do konfiguracji. Potrzebne są też sprawne platformy, czytniki, sprzęt termiczny i zgodne części; lutowanie nie wystarcza.
Zgodność to więcej niż fizyczne dopasowanie. PMIC może wymagać właściwego programowania producenta, firmware, granic elektrycznych i konfiguracji platformy. Dawcy dostarczają rzadkie części o niepewnej historii; podróbki i błędne programowanie komplikują testy. Nadmierne ciepło odkształca wielowarstwową płytkę, uszkadza sąsiednie układy i zdrowe połączenia szybkich ścieżek. Reflow może też dać chwilową poprawę bez wyjaśnienia pierwotnej przyczyny.
AI zmienia rachunek, nie dowód ceny
Infrastruktura AI używa HBM przy akceleratorach i zwykłego DRAM wokół procesorów hosta. To odrębne produkty, lecz popyt i alokacja dostawców łączą ich ekonomikę. Produkcję kształtują zgodność procesów, zobowiązania, marże i zapotrzebowanie. Priorytet dla serwerów i HBM może ograniczyć inne zasoby, ale nie czyni wszystkich pamięci zamiennymi.
W styczniu TrendForce wiązał priorytet serwerów z AI, ograniczonymi zapasami i chmurami zabezpieczającymi większy udział dostępnego przyrostu bitów. Prognozował na I kwartał 2026 wzrost kontraktowych cen zwykłego DRAM o 55–60% kwartał do kwartału i ponad 60% dla serwerowego. To prognozy rynkowe, nie udokumentowane ceny dwóch modułów Tony’ego.
Lipcowe omówienie kontraktów III kwartału opisywało dalszą presję związaną z AI i serwerami. Wrześniowa perspektywa wskazywała wsparcie wzrostów IV kwartału mimo ograniczonej dostępności cenowej dla konsumentów. Raporty dają kontekst, nie niezależne potwierdzenie wartości pary ani pewność przyszłych niedoborów.
Kontrakty firmowe, cenniki dystrybutorów i rynek spot różnią się znacznie. Cena zależy również od szybkości, ranków, gęstości, warstwowania, kwalifikacji i dostępności. 256 GB nie musi oznaczać 128 GB za dwa razy tyle. Bez numerów części i warunków zakupu spektakularna kwota pozostaje relacjonowanym twierdzeniem.
Termin dostawy jest równie ważny. Czekający na kwalifikowaną część serwer pracuje z mniejszą pamięcią, jest niedociążony albo wymaga migracji zadań, zużywając czas i rzadką infrastrukturę. Oczekiwana wartość naprawy obejmuje diagnozę, prawdopodobieństwo sukcesu, czas realizacji, podaż części i przerwę operacyjną, nie tylko cenę kondensatora wobec DIMM-u.
To przypomina specjalistyczne GPU i kontrolery przemysłowe, nie dowodzi jednak dojrzałego rynku pamięci. Nie znamy liczby naprawialnych usterek ani właścicieli bez gwarancji i wsparcia. Spadek cen lub dostępny kwalifikowany zapas może ponownie faworyzować nowy moduł z przewidywalną obsługą. Segmentacja na diagnostykę drogich i wymianę tanich jest bardziej prawdopodobna niż powszechne naprawianie.
Trudnym produktem jest godny zaufania naprawiony moduł
Jedna inicjalizacja rozpoczyna kwalifikację. Serwery pracują długo pod ruchem i zmianami temperatury. Graniczna spoina przechodzi start, a zawodzi po cyklach termicznych; przerobiona płytka może inaczej zachowywać się pod obciążeniem. Wewnętrzny DRAM, uszkodzenia wielowarstwowe czy niedostępne elementy zastrzeżone bywają praktycznie nienaprawialne mimo dostępu do kondensatora lub PMIC.
Długie testy muszą obejmować adresy, wzorce, temperatury, warunki oraz błędy poprawione i niepoprawialne. Kontrolery, firmware, kanały i prędkości różnią serwery: trening na jednym nie gwarantuje działania na drugim. Test powinien przypominać konfigurację klienta. Micron akcentuje niezawodność korporacyjną i stałą wydajność, ponad kilka testów desktopowych.
Identyfikowalność łączy zabieg z dowodami. Należy zapisać tożsamość, objawy, pomiary, wymienione części, profil termiczny, platformę, firmware i wyniki. Nieautoryzowane prace mogą zakończyć gwarancję, utrudnić wsparcie lub naruszyć zakupy. Wybór zatwierdzonego zamiennika mimo atrakcyjnej wyceny może być racjonalny.
Biznes mógłby oddzielać miejscowe usterki płytki i zasilania od rozległych awarii układów i DRAM oraz wyceniać przed wzrostem pracy. Diagnoza płatna, opłaty zależne od sukcesu i granice kwalifikacji są wiarygodniejsze od bezwarunkowej obietnicy. Powtarzane udokumentowane przypadki, sukcesy i długość testów uzasadniają adaptery, platformy, programatory i zapasy, nie jeden efektowny film.
Wspólne testy, logi, obciążenia i cykle termiczne oraz warunkowe gwarancje pozwalają porównywać usługi. Dostawcy mogą powoli akceptować niezależne prace ze względu na kontrolowaną produkcję i śledzenie kwalifikacji. Przejrzyste firmy odnawiające mogą jednak tworzyć klasy: zwalidowany serwer, laboratorium lub rozwój, tymczasowy zapas albo dawca. Bez dowodu nie są równoważne.
Trwałe pytanie nie brzmi, czy Tony uruchomił dwie płytki: według relacji tak. Czy specjaliści potrafią wielokrotnie zmieniać lokalną naprawę w usługę o lepszym koszcie i ryzyku niż wymiana? Presja infrastruktury AI zmienia jednorazowy element w odzyskiwalny zasób. Zaufanie potrzebne obok baz klientów i checkpointów AI trzeba jednak zdobyć osobno.
Źródła i dalsza lektura
Raport Tom’s Hardware; styczniowa prognoza TrendForce; Micron o zasilaniu DDR5; przewodnik RDIMM Micron; kontrakty III kwartału; wrześniowa prognoza IV kwartału.