
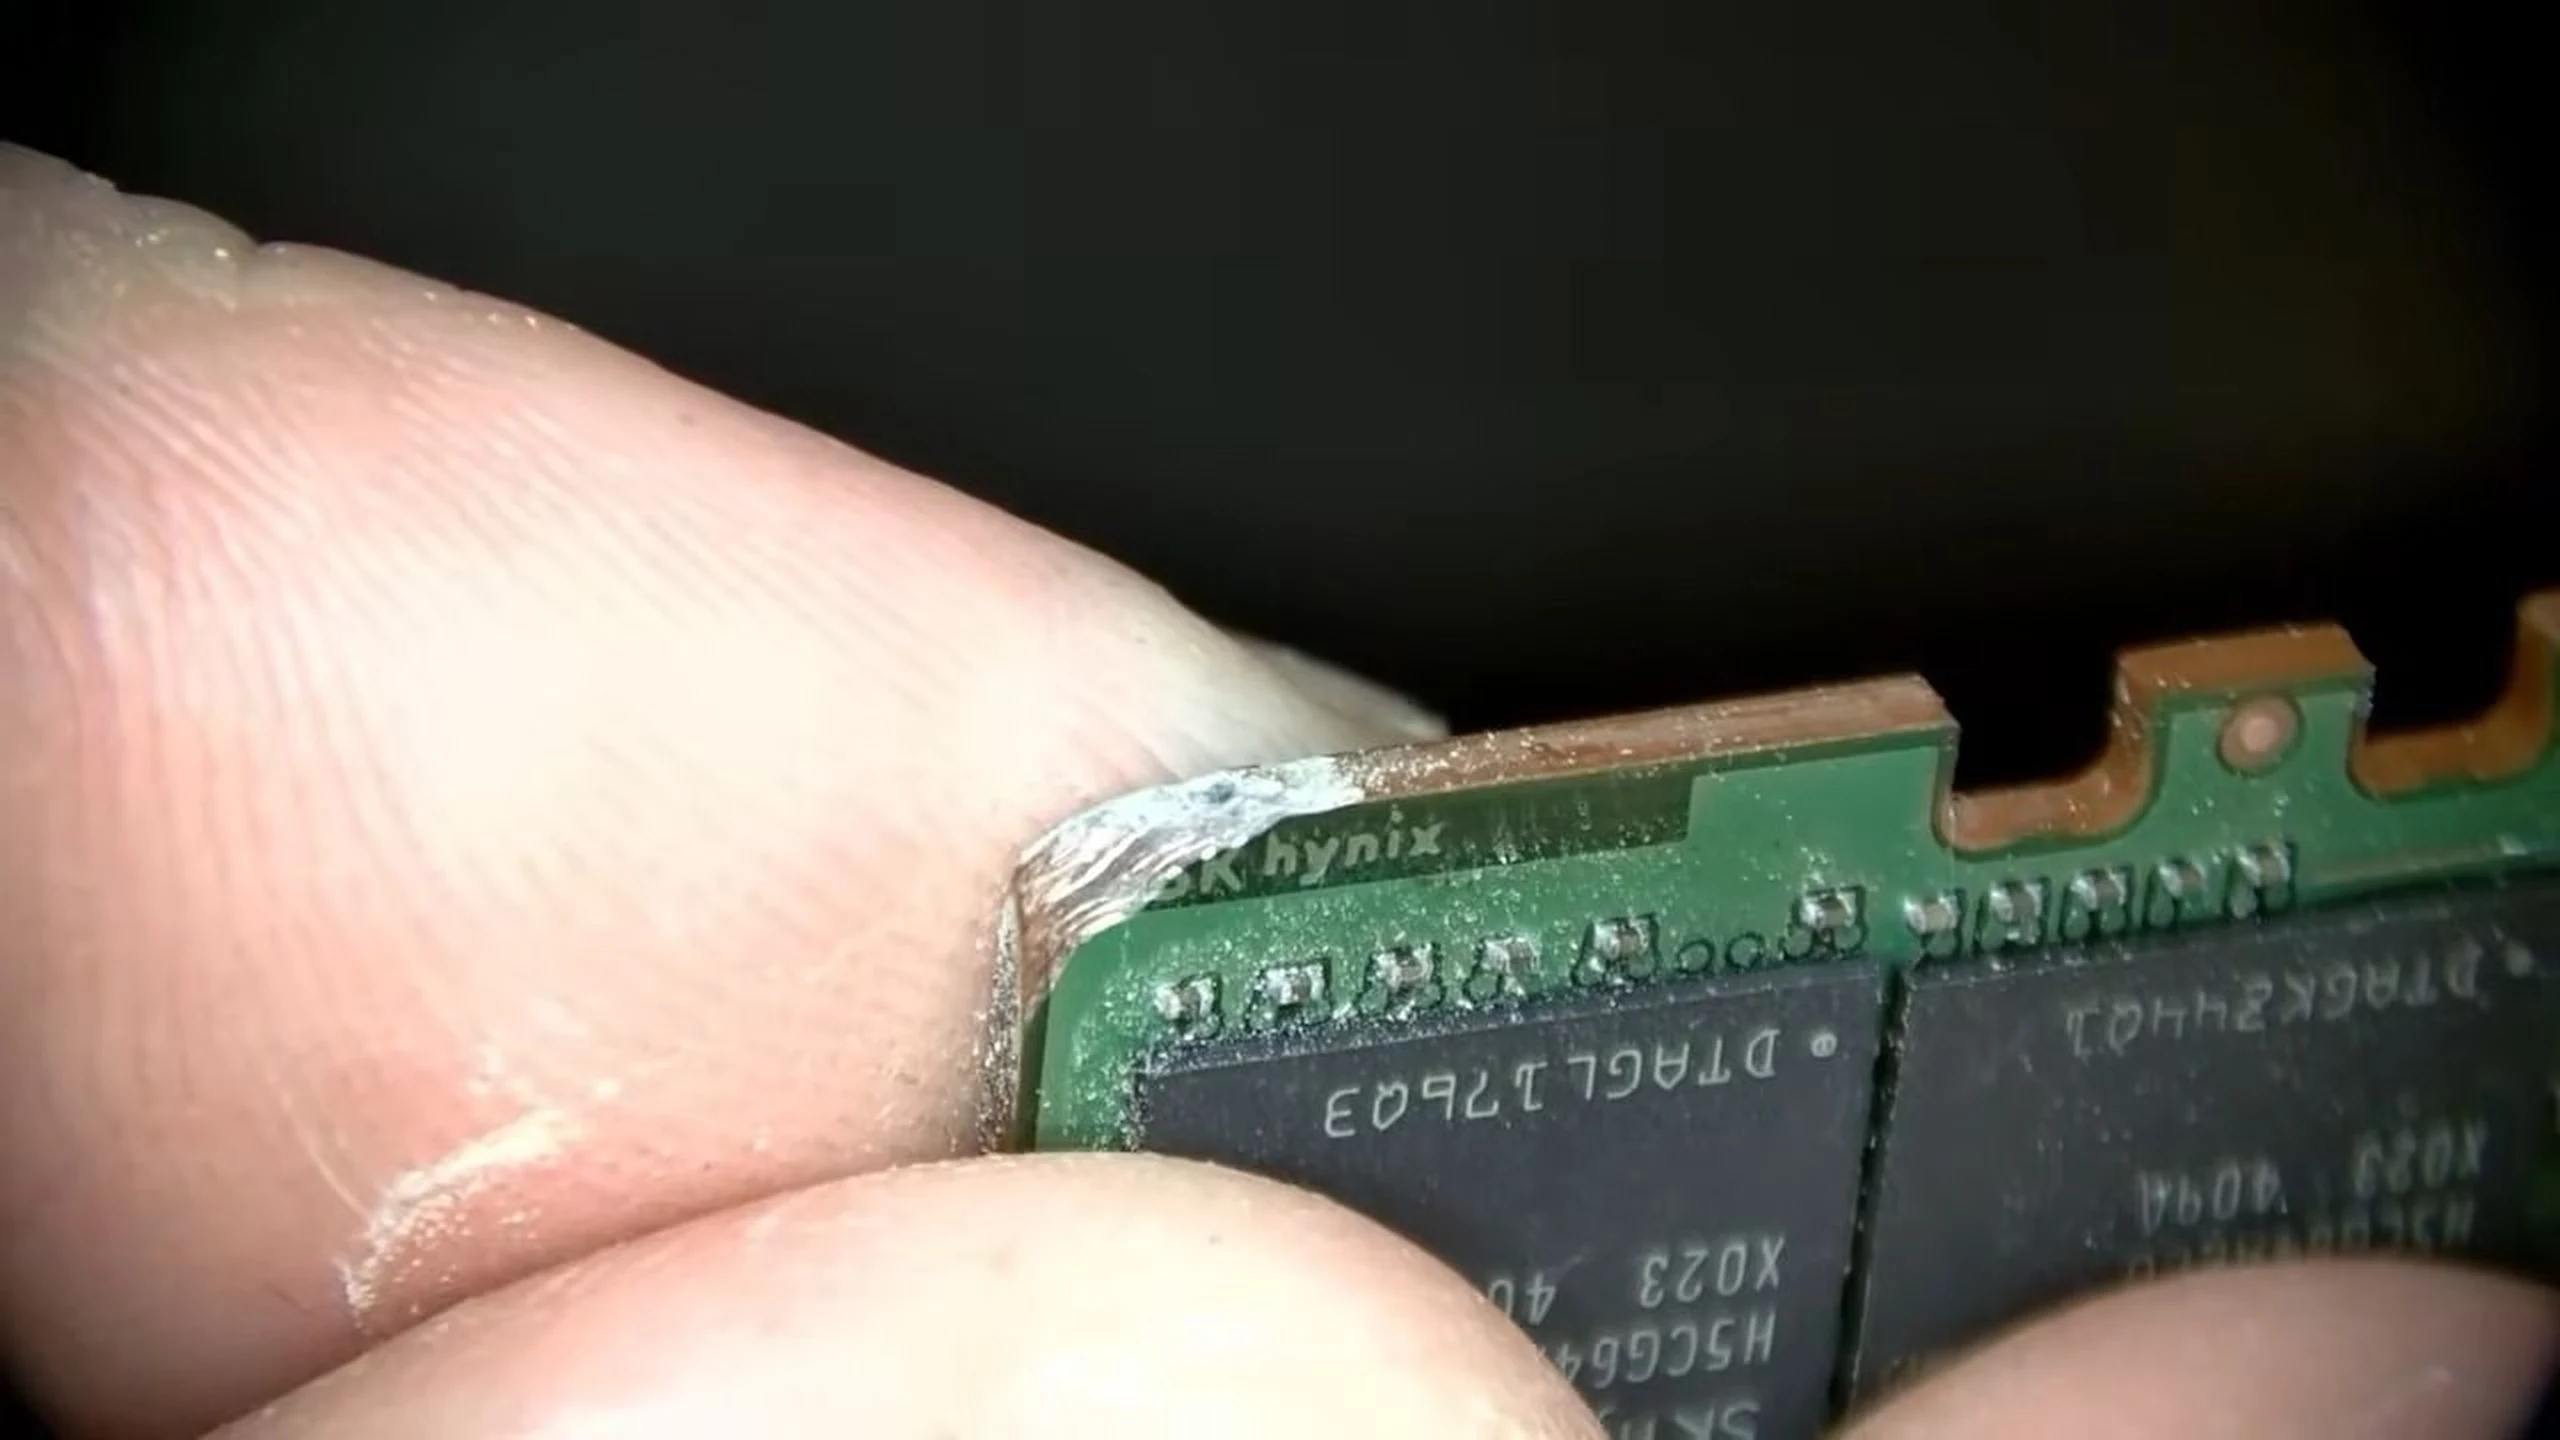
Un modulo server può contenere centinaia di gigabyte di DRAM utilizzabile e risultare inutilizzabile per l’host perché cede un piccolo componente di alimentazione o collegamento. La prima riparazione DDR5 documentata di NorthWestRepair ha esaminato questa distinzione su un SK hynix DDR5 RDIMM da 128 GB e un Samsung da 256 GB, per 384 GB totali.
Tony, noto soprattutto per le schede grafiche, li ha recuperati con diagnosi diverse. Il presunto valore di sostituzione a cinque cifre spiega la manodopera, ma i resoconti non mostrano fattura o prezzi per codici esatti. Il caso dimostra riparabilità, non che ogni DIMM costoso vada riparato o che entrambi siano qualificati per produzione critica.
Una riparazione ha seguito la saldatura, l’altra l’alimentazione
Entrambi arrivavano con sospetti danni fisici, ma l’ispezione non isolò subito un difetto decisivo. Sintomi simili possono derivare da piste, saldature, circuiti ausiliari, package DRAM o configurazione. L’integrità visiva non equivale a quella elettrica.
Il tester delle linee dati non trovò problemi chiari nei 128 GB. Tony applicò flussante e aria calda controllata per il reflow; il modulo funzionò. Il reflow riscalda la saldatura esistente; il reballing rimuove il chip, pulisce i contatti, mette nuove sfere e rimonta. Quest’ultimo è più invasivo e richiede allineamento e temperature precisi. Il recupero suggerisce un problema di connessione, senza confermare un singolo giunto o package come unica causa.
Il modulo da 256 GB non reagiva installato e la termografia non mostrava calore significativo. La scheda fredda orientò verso l’alimentazione, non soltanto il canale dati. Tony controllò l’EEPROM SPD che conserva la configurazione d’avvio e il PMIC che regola e distribuisce le tensioni DDR5.
Reflow su vari package e reballing di elementi sospetti non risolsero. Iniezione di tensione e osservazione termica aiutarono a trovare un corto. Furono trattati danni al bordo e un condensatore guasto, ma non bastò: solo un PMIC sostitutivo permise accensione e completamento del training.
Il training calibra timing e segnali per inizializzare la memoria. È una tappa significativa per una scheda prima morta, non una misura di stabilità prolungata. Il secondo caso non fu uno spettacolare cambio isolato: ispezione, misure, termografia, scheda, componenti e nuove prove contribuirono insieme.
DDR5 concentra valore di sostituzione e nuovi guasti
RDIMM significa registered dual inline memory module. Logica aggiuntiva bufferizza i comandi tra controller e DRAM, riducendo il carico elettrico e consentendo più capacità e slot popolati. Non è intercambiabile con economici UDIMM desktop non bufferizzati. ECC rileva e corregge alcuni errori come ulteriore protezione, senza garantire ogni difetto hardware.
Database, virtualizzazione, scienza e IA richiedono integrità persistente. Errori silenziosi compromettono lavori lunghi, mentre un componente ausiliario può fermare l’intero modulo denso anche con la maggior parte della DRAM integra. Scartarlo sacrifica molto più valore potenziale del pezzo guasto.
DDR5 rende centrale la gestione locale dell’energia. Micron descrive PMIC su ciascun modulo, spostando la regolazione sul DIMM. Migliora il controllo locale ma amplia la diagnosi. Mancata inizializzazione può coinvolgere PMIC, condensatori, piste, EEPROM, registro o saldature, non necessariamente celle DRAM. Il secondo recupero illustra la differenza, non la frequenza.
Strumenti delle GPU aiutano: resistenze, iniezione di tensione, termocamere, oscilloscopi, viste delle schede e donatori restringono il guasto. Tony impiegò Unified DDR Flasher Main Board con estensione RDIMM, mostrando il peso di adattatori specifici e accesso alla configurazione. Servono anche piattaforme funzionanti note, lettori, attrezzature termiche e parti compatibili; saldare non basta.
La compatibilità supera l’incastro fisico. Un PMIC può richiedere programmazione del fornitore, firmware, limiti elettrici e configurazione corretti. I donatori danno pezzi rari ma con storia incerta; contraffazioni e programmazione errata complicano la validazione. Calore eccessivo deforma schede multistrato, danneggia package vicini o giunti sani sulle piste veloci. Il reflow può anche migliorare temporaneamente senza spiegare il cedimento iniziale.
La domanda IA cambia il calcolo, non la prova del prezzo
L’IA usa HBM vicino agli acceleratori e DRAM convenzionale attorno alle CPU host. Sono prodotti distinti, ma domanda e allocazione ne collegano l’economia. Produzione dipende da processi compatibili, impegni, margini e domanda. Privilegiare server e HBM può limitare altri mercati, non rendere tutte le memorie sostituibili direttamente.
A gennaio TrendForce attribuiva la priorità ai server alla domanda IA, scorte limitate e cloud che assicuravano più crescita disponibile in bit. Prevedeva per il primo trimestre 2026 aumenti contrattuali trimestrali del 55–60% nella DRAM convenzionale e oltre il 60% in quella server. Sono previsioni di mercato, non prezzi d’acquisto documentati dei due moduli.
La discussione di luglio sui contratti del terzo trimestre descriveva pressione persistente per la priorità IA/server. A settembre la prospettiva vedeva ancora sostegno ai rincari del quarto trimestre nonostante la scarsa accessibilità ai consumatori. È contesto, non conferma indipendente della valutazione della coppia né certezza di futura scarsità.
Contratti aziendali, listini distributori e offerte spot differiscono. Oltre alla capacità contano velocità, rank, densità, impilamento, qualifica e disponibilità. Un 256 GB non è necessariamente un 128 GB al doppio prezzo. Senza codici e condizioni precisi, il valore eclatante resta una dichiarazione riportata.
I tempi possono contare quanto il prezzo. Un server che aspetta un ricambio qualificato lavora con meno capacità, resta sottoutilizzato o sposta carichi, consumando personale e infrastruttura rara. Il valore atteso della riparazione comprende diagnosi, probabilità di successo, durata, disponibilità e interruzione, non solo condensatore contro DIMM.
Ricorda l’economia di GPU e controllori industriali, senza provare un mercato maturo. Non sappiamo quanti guasti siano riparabili o quanti proprietari siano senza garanzia e supporto. Prezzi bassi e scorte qualificate possono favorire di nuovo il nuovo con assistenza prevedibile. Una segmentazione tra diagnosi dei costosi e sostituzione degli economici è più plausibile della riparazione universale.
Il prodotto difficile è un modulo riparato affidabile
Una sola inizializzazione avvia la qualifica. La memoria server lavora a lungo con traffico e variazioni termiche. Un giunto marginale supera il boot e fallisce con i cicli; il materiale rilavorato cambia comportamento sotto carico. DRAM interna, danni multistrato e parti proprietarie introvabili possono essere impraticabili anche se condensatore o PMIC sono accessibili.
Prove lunghe devono coprire indirizzi, pattern, temperature, condizioni ed errori corretti e non correggibili. Controller, firmware, canali e velocità variano: training su un server non garantisce un altro. Il test deve somigliare alla configurazione del cliente. Micron richiede affidabilità enterprise e prestazioni costanti, oltre qualche prova desktop.
Tracciabilità collega intervento e prove. Identità, sintomi, misure, ricambi, profilo termico, piattaforma, firmware e risultati vanno registrati. Rilavorazione non autorizzata può annullare garanzia, complicare assistenza o violare acquisti. Alcuni operatori scelgono razionalmente ricambi approvati anche con preventivi allettanti.
Un’attività potrebbe separare guasti locali di scheda o energia da ampi difetti di package e DRAM, preventivando prima di aumentare il lavoro. Diagnosi a pagamento, compensi legati al successo e limiti di qualifica sono più credibili di promesse incondizionate. Casi ricorrenti documentati, percentuali e durata dei test giustificano adattatori, server, programmatori e magazzino, non un video spettacolare.
Validazione comune, log, stress e cicli termici, con garanzie condizionate, facilitano confronti. I produttori potrebbero approvare lentamente interventi indipendenti perché dipendono da produzione controllata e tracciabilità. Ricondizionatori trasparenti possono definire gradi: server validato, laboratorio/sviluppo, scorta temporanea o donatore. Senza prove non sono equivalenti.
La domanda duratura non è se Tony abbia acceso le schede: secondo la notizia sì. È se gli specialisti possano ripetere riparazioni locali in un servizio con costi e rischi preferibili alla sostituzione. La pressione IA può trasformare consumabili in beni recuperabili, ma la fiducia per rimetterli accanto a database clienti o checkpoint IA va guadagnata separatamente.
Fonti e letture correlate
Rapporto Tom’s Hardware; previsione TrendForce di gennaio; Micron sull’alimentazione DDR5; guida RDIMM Micron; contratti del terzo trimestre; prospettiva di settembre sul quarto trimestre.