
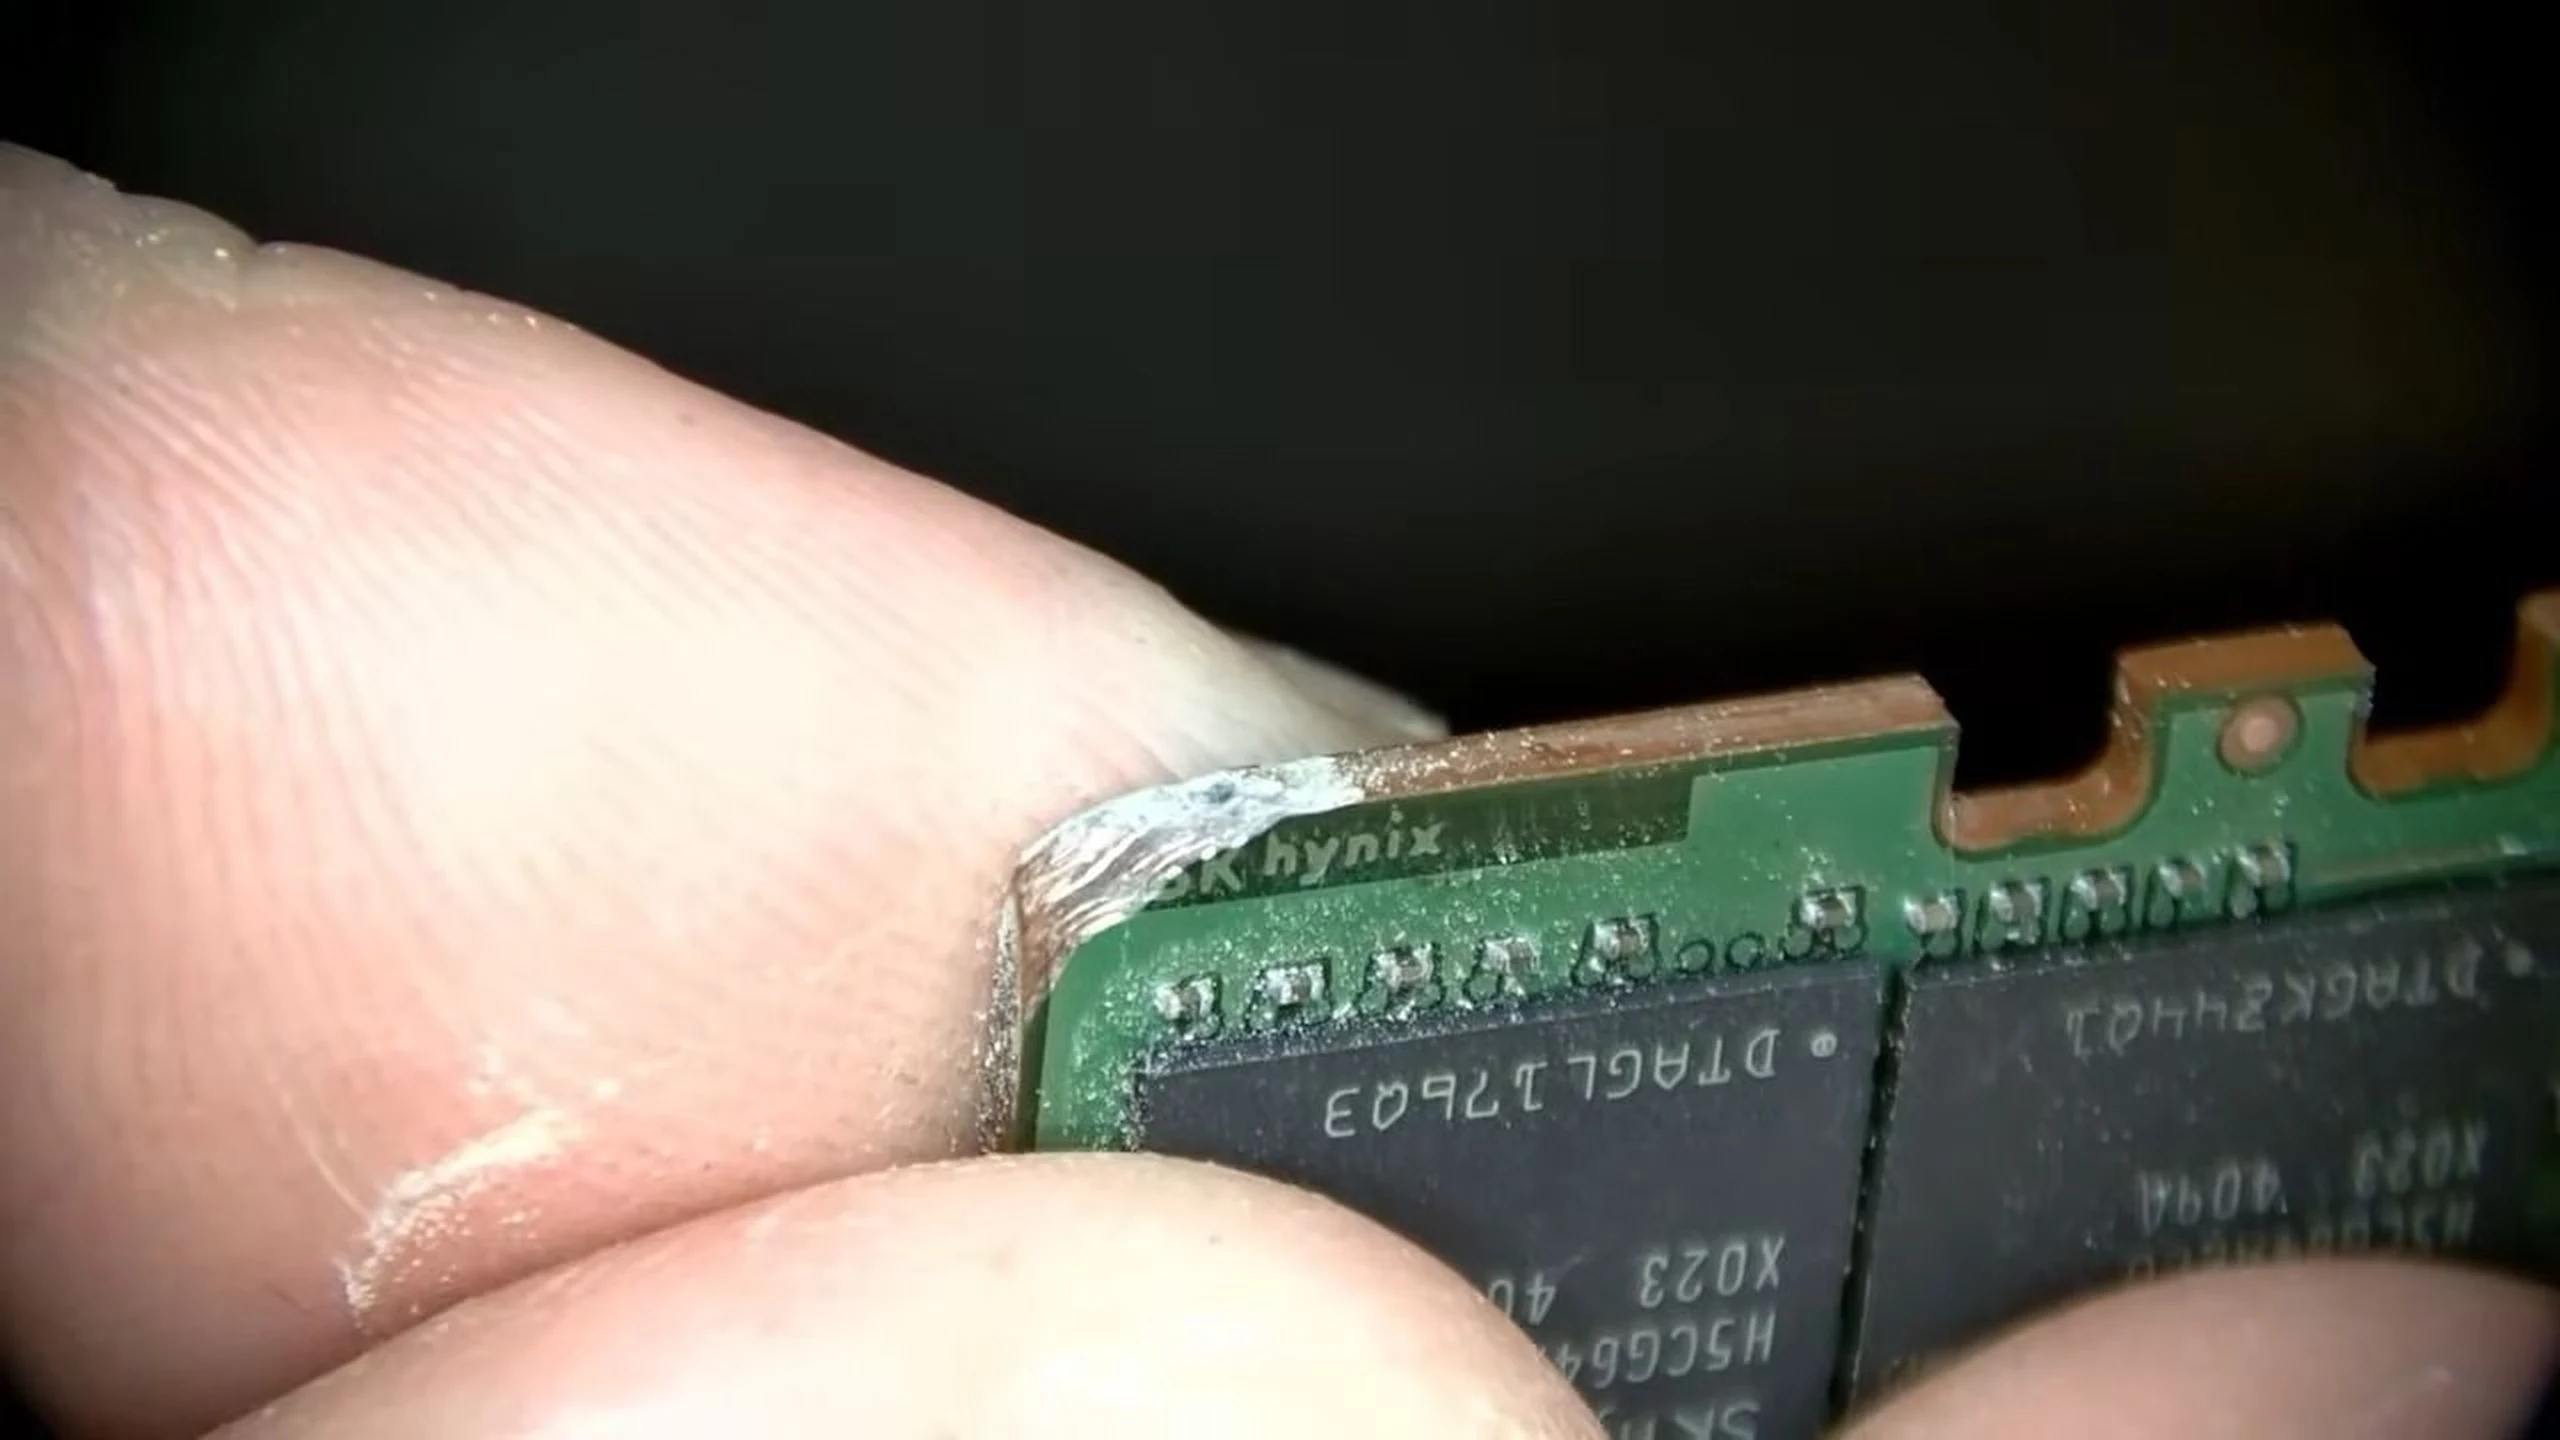
Un módulo servidor puede contener cientos de gigabytes de DRAM utilizable y quedar inservible para el host porque falla un pequeño componente de alimentación o conexión. La primera reparación DDR5 documentada de NorthWestRepair examinó esa diferencia en un SK hynix DDR5 RDIMM de 128 GB y un Samsung de 256 GB, con 384 GB en total.
Tony, conocido por reparar tarjetas gráficas, recuperó ambos mediante diagnósticos distintos. El supuesto valor de sustitución de cinco cifras explica la mano de obra, pero la cobertura no aporta factura ni precios de referencias exactas. Demuestra reparabilidad, no que todo DIMM caro deba repararse o que ambos estén cualificados para producción crítica.
Una reparación siguió la soldadura; la otra, la alimentación
Ambos llegaron con sospechas de daño físico, pero la inspección visual no aisló inmediatamente un fallo decisivo. Síntomas similares proceden de pistas, soldaduras, circuitos auxiliares, encapsulados DRAM o configuración. Parecer intacto no equivale a integridad eléctrica.
El comprobador de líneas de datos no encontró un problema claro en los 128 GB. Tony aplicó flux y aire caliente controlado para reflow; el módulo funcionó. Reflow recalienta soldadura existente; reballing retira el chip, limpia contactos, instala bolas nuevas y vuelve a montarlo. Es más invasivo y exige alineación y temperatura precisas. El éxito sugiere un problema de conexión, sin confirmar una unión o encapsulado como única causa.
Los 256 GB no reaccionaban instalados y la imagen térmica no mostraba calor significativo. La placa fría orientó hacia alimentación, no únicamente un canal de datos. Tony examinó la EEPROM SPD, que almacena configuración de inicialización, y el PMIC, que regula y distribuye tensiones DDR5.
Reflow de varios encapsulados y reballing de elementos sospechosos no resolvieron. La inyección de voltaje y observación térmica ayudaron a localizar un corto. Se trataron daños del borde y un condensador defectuoso, pero no bastó. Solo un PMIC nuevo permitió encendido y entrenamiento de memoria.
El entrenamiento calibra tiempos y señales para inicializar la memoria. Es un hito significativo para una placa antes muerta, no una medición de estabilidad sostenida. El segundo caso no fue una espectacular sustitución aislada: inspección, mediciones, diagnóstico térmico, placa, componentes y nuevas pruebas contribuyeron.
DDR5 concentra valor de sustitución y nuevos ámbitos de fallo
RDIMM significa registered dual inline memory module. La lógica adicional almacena órdenes en búfer entre controlador y DRAM, reduciendo carga eléctrica y permitiendo más capacidad y ranuras ocupadas. No es intercambiable con UDIMM económicos sin búfer de escritorio. ECC detecta y corrige ciertos errores como protección adicional, sin garantizar corregir cualquier defecto físico.
Bases de datos, virtualización, ciencia e IA necesitan integridad persistente. Un error silencioso compromete trabajos largos, mientras un componente auxiliar puede detener todo el módulo denso aunque conserve la mayoría de sus memorias intactas. Desecharlo sacrifica mucho más valor potencial que la pieza averiada.
DDR5 hace importante la gestión local de energía. Micron describe PMIC en cada módulo, trasladando la regulación al DIMM. Mejora el control local, pero amplía el diagnóstico. La inicialización puede fallar por PMIC, condensadores, pistas, EEPROM, registro o soldaduras, no necesariamente por celdas DRAM. El segundo caso ilustra esa diferencia, sin establecer su frecuencia.
Las herramientas GPU se transfieren: resistencia, inyección de voltaje, termografía, osciloscopios, vistas de placa y donantes acotan fallos. Tony utilizó Unified DDR Flasher Main Board con extensión RDIMM, mostrando la importancia de adaptadores específicos y acceso a configuración. Hacen falta también plataformas conocidas, lectores, equipo térmico y piezas compatibles; soldar no basta.
Compatibilidad supera el encaje físico. Un PMIC puede necesitar programación del proveedor, firmware, límites eléctricos y configuración correctos. Los donantes aportan piezas escasas con historial incierto; falsificaciones o programación incorrecta complican validar. El calor excesivo deforma placas multicapa, daña encapsulados vecinos y uniones sanas en pistas rápidas. Reflow puede mejorar temporalmente sin explicar el origen del fallo.
La demanda IA cambia el cálculo, no la prueba del precio
La infraestructura IA utiliza HBM cerca de aceleradores y DRAM convencional junto a procesadores host. Son productos distintos, conectados económicamente por demanda y asignación. La fabricación depende de procesos compatibles, compromisos, márgenes y demanda. Priorizar servidor y HBM puede restringir otros suministros, sin hacer intercambiables todas las memorias.
En enero TrendForce atribuyó esa prioridad a IA, inventarios limitados y nubes reservando más crecimiento de bits disponible. Pronosticó para el primer trimestre de 2026 alzas trimestrales contractuales del 55–60% en DRAM convencional y superiores al 60% en servidor. Son previsiones, no precios documentados de los módulos de Tony.
El análisis de julio sobre contratos del tercer trimestre describía presión continuada por prioridad IA/servidores. La perspectiva de septiembre seguía apoyando subidas del cuarto trimestre pese a límites de asequibilidad del consumidor. Es contexto, no confirmación independiente del valor de la pareja ni garantía de escasez futura.
Contratos empresariales, listas de distribuidores y ofertas al contado difieren. Además de capacidad importan velocidad, rangos, densidad, apilamiento, cualificación y disponibilidad. Un 256 GB no es necesariamente un 128 GB al doble de precio. Sin referencias y condiciones exactas, la cifra espectacular sigue siendo una afirmación comunicada.
El plazo puede importar tanto como el precio. Un servidor esperando recambio cualificado funciona con menos capacidad, queda infrautilizado o necesita migrar cargas, consumiendo personal e infraestructura escasa. El valor esperado de reparar incluye diagnóstico, probabilidad de éxito, duración, disponibilidad e interrupción, no solo condensador frente a DIMM.
Se parece a la economía de GPU y controladores industriales, sin probar un mercado maduro. Desconocemos cuántos fallos son reparables o cuántos dueños carecen de garantía y soporte. Recambios baratos y disponibles pueden devolver ventaja al módulo nuevo con asistencia predecible. Segmentar diagnóstico de caros y sustitución de baratos es más plausible que repararlo todo.
El producto difícil es un módulo reparado fiable
Una inicialización comienza la cualificación. La memoria servidor trabaja mucho tiempo con tráfico sostenido y cambios térmicos. Una unión marginal pasa el arranque y falla con ciclos; el material retrabajado cambia bajo carga. Defectos internos DRAM, daños multicapa y piezas propietarias inaccesibles pueden ser impracticables aunque condensador o PMIC sean accesibles.
Las pruebas prolongadas deben cubrir direcciones, patrones, temperaturas, condiciones y errores corregidos y no corregibles. Controladores, firmware, canales y velocidades varían: entrenar en un servidor no garantiza otro. Las pruebas deben parecerse a la configuración del cliente. Micron destaca fiabilidad empresarial y rendimiento constante, más que varias pasadas de escritorio.
La trazabilidad conecta intervención y evidencias. Identidad, síntomas, mediciones, piezas, perfil térmico, plataforma, firmware y resultados deben registrarse. El trabajo no autorizado puede anular garantía, complicar soporte o violar compras. Algunos operadores eligen racionalmente sustitución aprobada pese a un presupuesto atractivo.
El negocio podría separar fallos locales de placa o energía de defectos extensos de encapsulados o DRAM y presupuestar antes de acumular trabajo. Diagnóstico de pago, cobros por éxito y límites de cualificación son más creíbles que promesas incondicionales. Casos recurrentes documentados, tasas y duración de pruebas justifican adaptadores, servidores, programadores e inventario, no un vídeo dramático.
Validación común, registros, estrés y ciclos térmicos con garantías condicionadas permiten comparar. Los fabricantes podrían tardar en respaldar trabajos independientes porque dependen de producción controlada y trazabilidad. Reacondicionadores transparentes pueden establecer grados: servidor validado, laboratorio/desarrollo, reserva temporal o donante. No son equivalentes sin pruebas.
La pregunta duradera no es si Tony arrancó dos placas: según el informe, sí. Es si especialistas repiten reparaciones locales como servicio de coste y riesgo preferibles a sustituir. La presión IA transforma consumibles en activos recuperables, pero la confianza para volver junto a bases de clientes o checkpoints IA debe ganarse por separado.
Fuentes y lecturas relacionadas
Informe de Tom’s Hardware; pronóstico de enero de TrendForce; Micron sobre alimentación DDR5; guía RDIMM Micron; contratos del tercer trimestre; perspectiva de septiembre para el cuarto trimestre.