
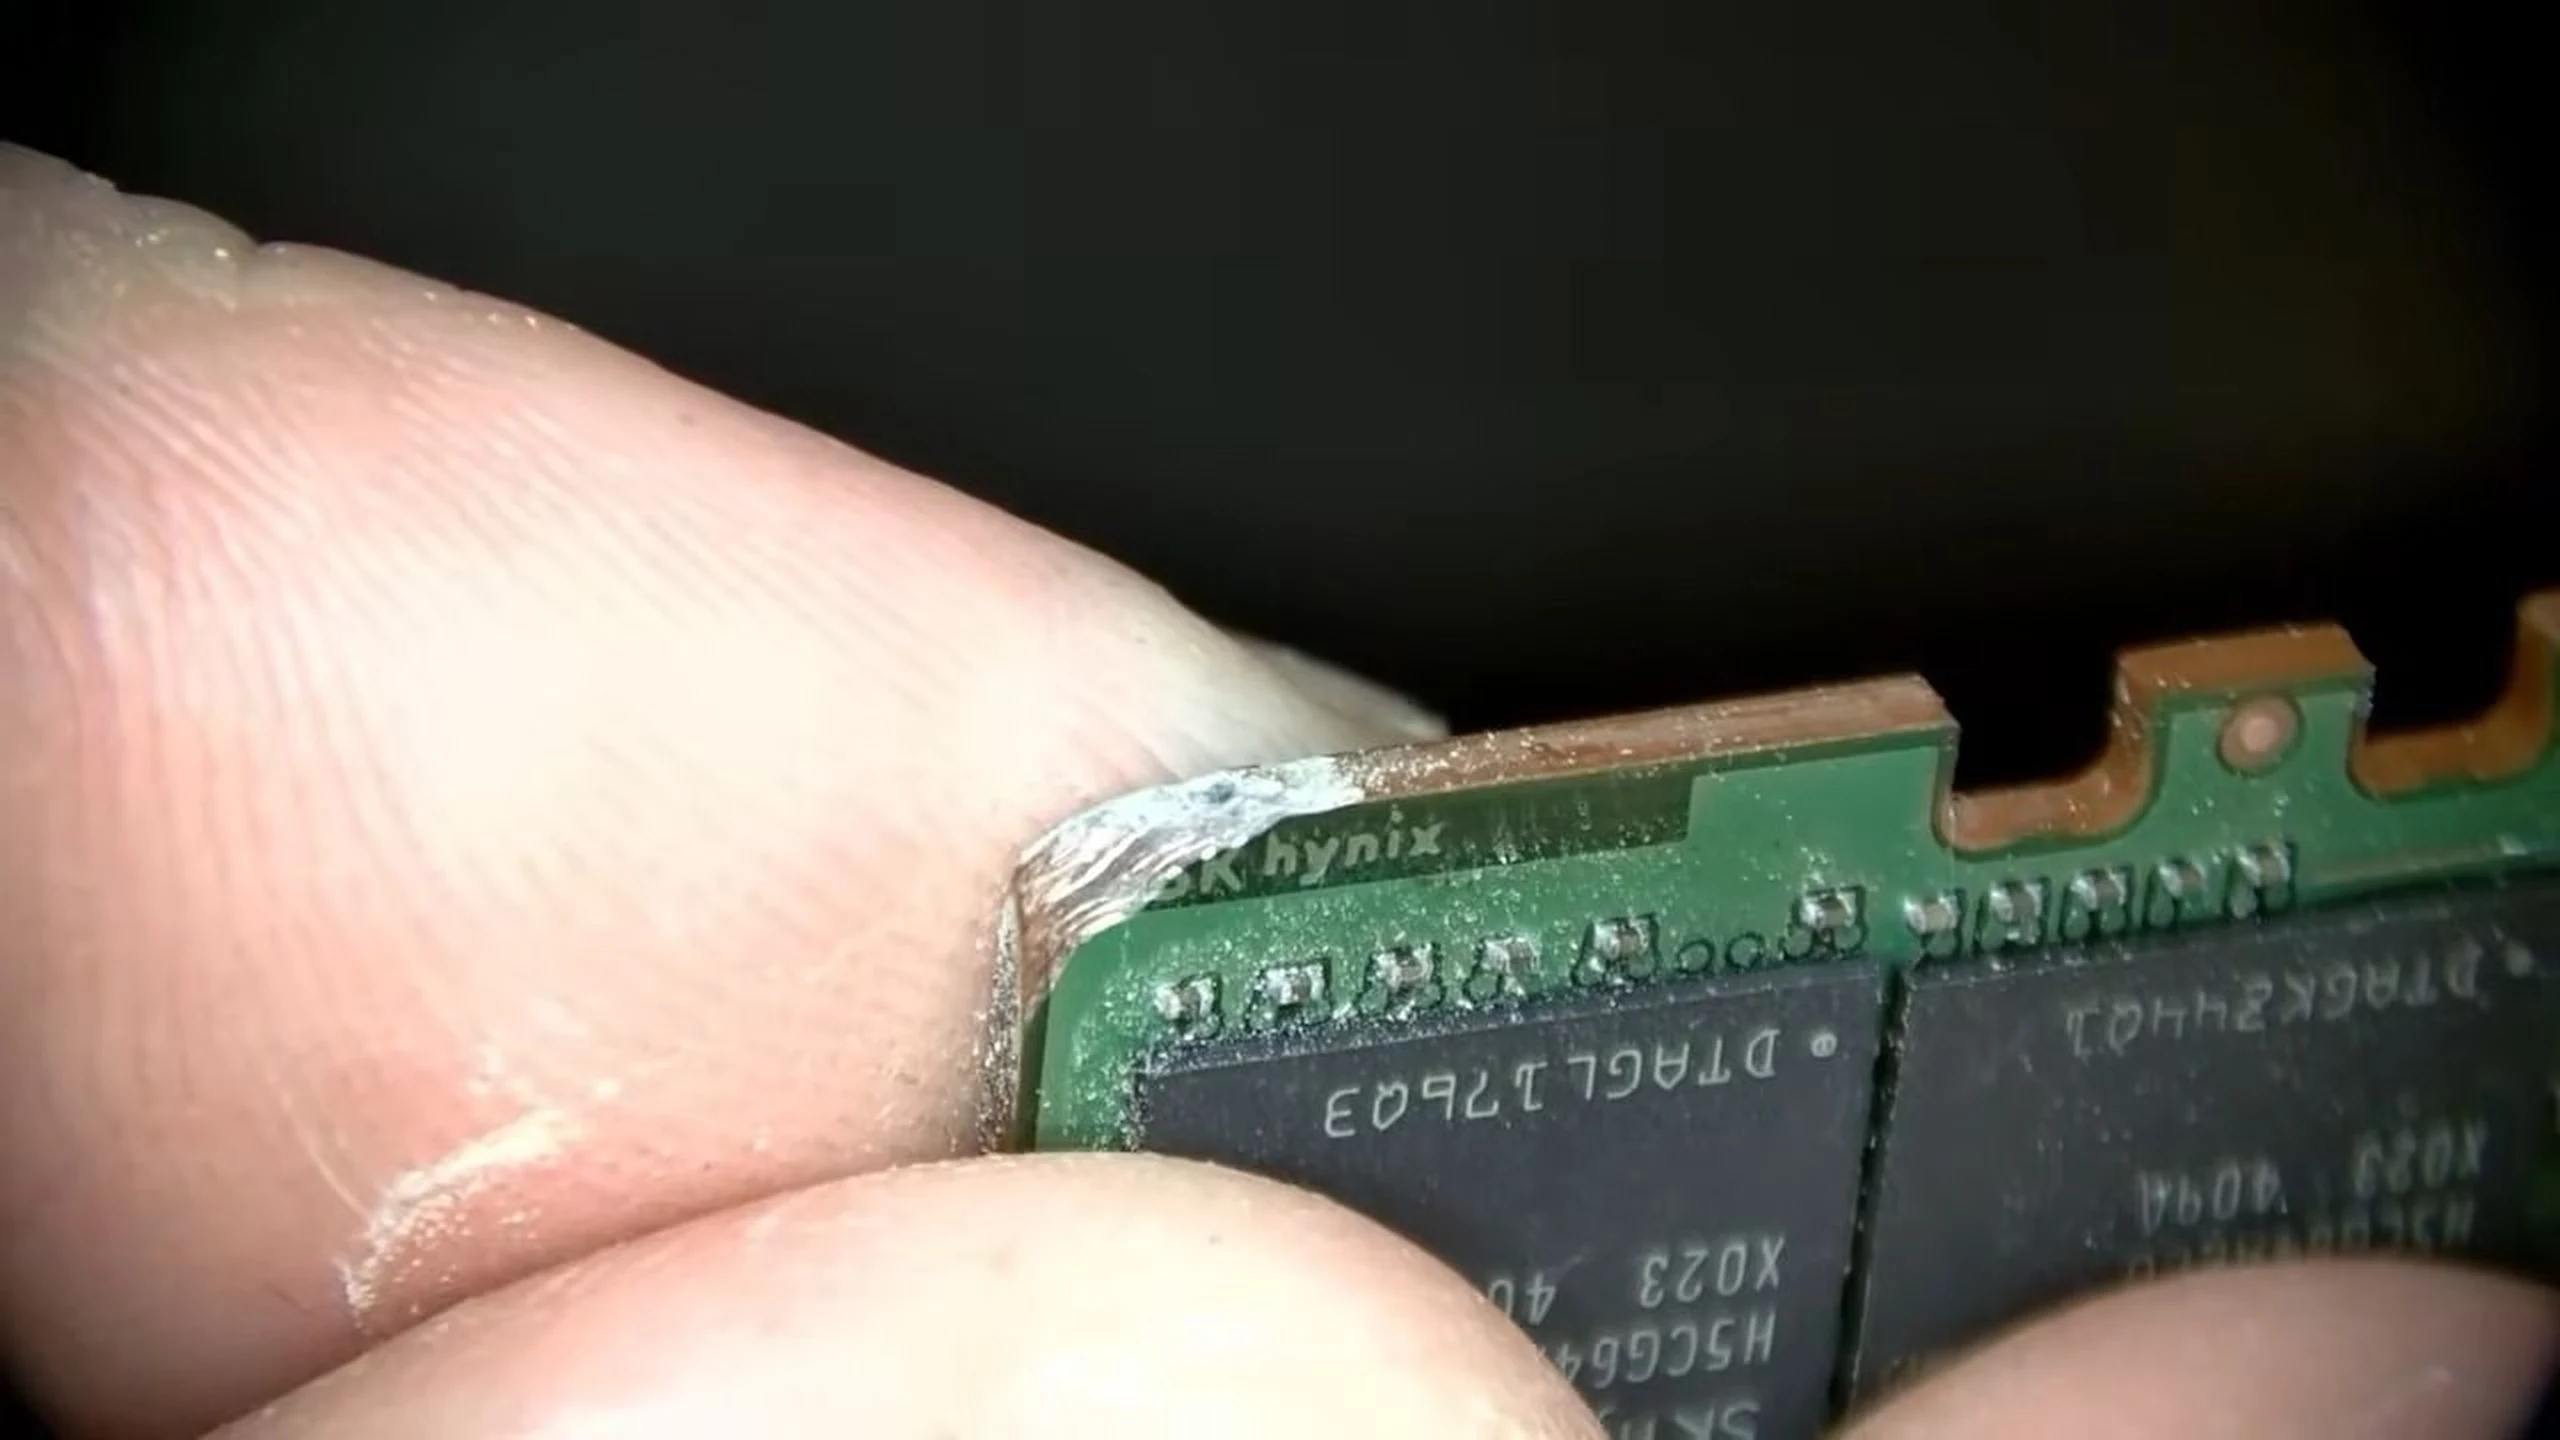
一条服务器内存可能仍有数百GB可用DRAM,却因为小小的供电元件或连接失效而无法被主机使用。NorthWestRepair 首次有记录的DDR5维修,正是在两条受损模块上检验这种区别:128GB的SK hynix DDR5 RDIMM,以及256GB的三星模块,合计384GB。
更以显卡维修闻名的技术员Tony,通过不同诊断路径救回两者。两条模块据称达五位数美元的替换价值,有助解释人工投入,但公开报道没有提供发票或精确料号报价。案例证明可以维修,不代表每条昂贵DIMM都应维修,更不代表这两条已通过关键生产环境认证。
一条沿焊接连接排查,另一条追查供电
两条模块送达时均疑有物理损伤,目视检查却未立即找到决定性故障。相似症状可能来自走线、焊点、辅助电路、DRAM封装或配置数据。看起来完好,并不等于电气上完好。
数据线测试仪没有在128GB模块上发现明确问题。Tony使用助焊剂和受控热风回流焊,之后模块恢复工作。回流焊是重新加热现有焊料;植球则要拆下芯片、清洁接点、更换焊锡球并重新安装,侵入性更强,对对位和温度要求更高。第一条恢复暗示连接问题,但报道没有确认某个焊点或封装就是唯一原因。
256GB模块装机后毫无反应,热成像也没有明显发热模式。整板冰冷使关注点转向供电,而非仅盯着数据通道。Tony检查了保存初始化配置的串行存在检测EEPROM,以及调节和分配DDR5元件电压的PMIC。
对若干封装回流焊、对可疑元件植球,仍未解决问题。电压注入和热观察帮助发现短路。修复板边损伤、更换失效电容后,恢复仍未完成;最终更换PMIC,模块才通电并完成内存训练。
训练会校准时序和信号行为,使平台能够初始化模块。对于原先完全不工作的板卡,这是有意义的里程碑,却不是持续稳定性测量。第二条的恢复并非戏剧性的单次换芯,而是检查、测量、热诊断、修板、换件与反复测试共同作用。
DDR5把替换价值和新的故障领域集中到模块
RDIMM是注册式双列直插内存模块。额外逻辑缓冲控制器与DRAM之间的命令信号,减轻电气负载,支持更大服务器容量和更多插槽装配。它不能与普通桌面廉价无缓冲UDIMM互换。ECC是另一道服务器防线,能检测并纠正某些错误,但不能保证所有硬件故障都能纠正。
数据库、虚拟化、科学计算和AI任务依赖持续数据完整性。静默错误可能破坏长时间作业,而一个辅助元件故障也可能禁用整条高密度模块,即便大多数内存封装仍完好。直接报废便会牺牲远超失效零件的潜在价值。
DDR5尤其依赖本地电源管理。Micron技术资料说明,每条模块搭载PMIC,将调压转移到DIMM上。这改善局部电压控制,也新增诊断领域。无法初始化可能涉及PMIC、电容、走线、配置EEPROM、寄存器或焊接,而不一定是DRAM单元坏了。第二条的恢复说明这种区别,但不能证明这类故障有多常见。
显卡维修的工具和推理可迁移过来:电阻测量、电压注入、热像仪、示波器、板图和供体零件可缩小故障范围。Tony用了带RDIMM扩展的Unified DDR Flasher Main Board,说明服务器专用适配器及配置访问的重要性。维修店还需要已知良好的测试平台、读取器、热处理设备和兼容零件,只有焊接技巧并不够。
兼容性超出物理尺寸。替代PMIC可能需要正确的厂商编程、固件状态、电气限值和平台配置。供体板能提供稀缺零件,却有历史不明的问题;假冒或错误编程会增加验证难度。同时,过热可使多层板翘曲、损坏邻近封装,或削弱高速走线附近原本良好的焊点。回流焊还可能只暂时改善,而没有解释原始失效原因。
AI需求改变计算方式,不会自动证实价格标签
AI基础设施既使用加速器附近的HBM,也使用主机处理器周边常规DRAM。两者是不同产品,但需求和供应商分配把经济性联系起来。制造选择受工艺兼容、客户承诺、预期利润和需求影响;优先服务器内存与HBM可能挤压其他供应,并不代表所有内存能直接互换。
TrendForce在1月将服务器优先归因于AI服务器需求、库存有限,以及云厂商锁定更多可用位元产能增量。它预测2026年第一季度常规DRAM合约价环比涨55%–60%,服务器DRAM涨幅超过60%。这是市场预测,不是Tony这两条模块的已记录成交价。
该机构7月对第三季度合约的讨论,描述供应商优先AI与服务器用途带来的持续压力。9月展望同样称,虽然消费者负担能力受限,AI服务器需求仍支撑第四季度上涨。这些是市场背景,既不能独立证实两条模块的估值,也不能确立未来必然稀缺。
企业合约、分销商挂牌和现货报价可能差别很大。容量不是唯一价格因素:速度、rank配置、密度、堆叠方式、厂商认证和供货都重要。256GB不一定只是128GB产品的双倍价格。缺少具体料号及采购条件,醒目估值仍只能是转述主张。
交期可与价格同样重要。等待合格替换件的服务器可能减容、闲置,或将任务迁往其他位置,消耗人力和稀缺设施。因此维修预期价值包含诊断成本、成功概率、周转时间、替件供应及运行中断,而非只比较电容与整条DIMM价格。
这类似支撑GPU和工业控制器专业维修的经济逻辑,但不能证明内存维修市场已经成熟。两条模块没有告诉我们可修故障有多少、多少所有者缺少保修或厂商支持。若替件降价或合格库存恢复充足,新件的可预测支持可能再次胜出。昂贵模块接受诊断、廉价模块直接更换的细分市场,比普遍维修更可信。
真正难交付的是值得信任的修复模块
一次初始化只是认证起点。服务器内存在持续流量、温度变化下长期运行。边缘状态焊点可能通过启动,却在热循环后失效;返工板材在负载下表现也可能不同。内部DRAM缺陷、多层板损伤及无法取得的专有元件也可能难以实修,即便电容或PMIC相对容易处理。
长期测试需要覆盖地址、数据模式、温度及运行条件,并监测可纠正和不可纠正错误。控制器、固件、通道装配和支持速度不同,可能使模块在一台服务器完成训练、在另一台失败。测试应贴近客户配置。Micron的RDIMM指南强调企业可靠性与一致性能,门槛高于几次桌面测试。
可追溯性把维修与证据相连。可信服务应记录模块身份、初始症状、测量、更换元件、热处理曲线、测试平台、固件和结果。未授权返工可能取消厂商保修、增加支持困难或违反采购规则。因此即便维修报价吸引人,有些运营商仍会合理选择获批替件。
维修业务可先区分局部板卡或供电问题与广泛封装、内部DRAM故障,在人工继续累积前报价。诊断费、按成功收费及明确认证边界,比无条件恢复承诺可信。持续记录案例、成功率和测试时长,而非一段戏剧化视频,才能支撑适配器、服务器平台、编程工具和零件库存投资。
共同验证实践、错误日志、压力与热循环记录、附条件保修,可帮助客户比较服务。服务器及内存厂商依赖受控制造和可追溯认证,可能不会迅速认可独立维修。透明翻新商仍可形成分级:已验证服务器用途、实验室或开发用途、临时备件、供体零件。在证据支持前,这些不应被当作等价。
持久问题不是Tony有没有让两块板启动——报道说他做到了——而是专业人员能否反复把局部维修变成成本和风险优于更换的可靠服务。AI基础设施压力可将曾经的一次性元件变为可恢复资产,但让它重回客户数据库或AI检查点旁边所需的信任,必须单独赢得。
来源与相关阅读
Tom’s Hardware维修报道;TrendForce一月服务器内存展望;Micron DDR5电源管理说明;Micron RDIMM指南;TrendForce第三季度合约讨论;TrendForce九月第四季度展望。