
25. Oktober 2026 —
OpenAI zur Absicherung unserer Trainingsumgebung für Frontier-Modelle: Containment erfordert mehr als Sandboxes
Diese Ausgabe fragt, wie Teams beobachtbare, bewertbare und reversible Kontrolle behalten, wenn KI in reale Abläufe und Infrastruktur gelangt. Originalquellen bleiben auf der Ausgabeseite.
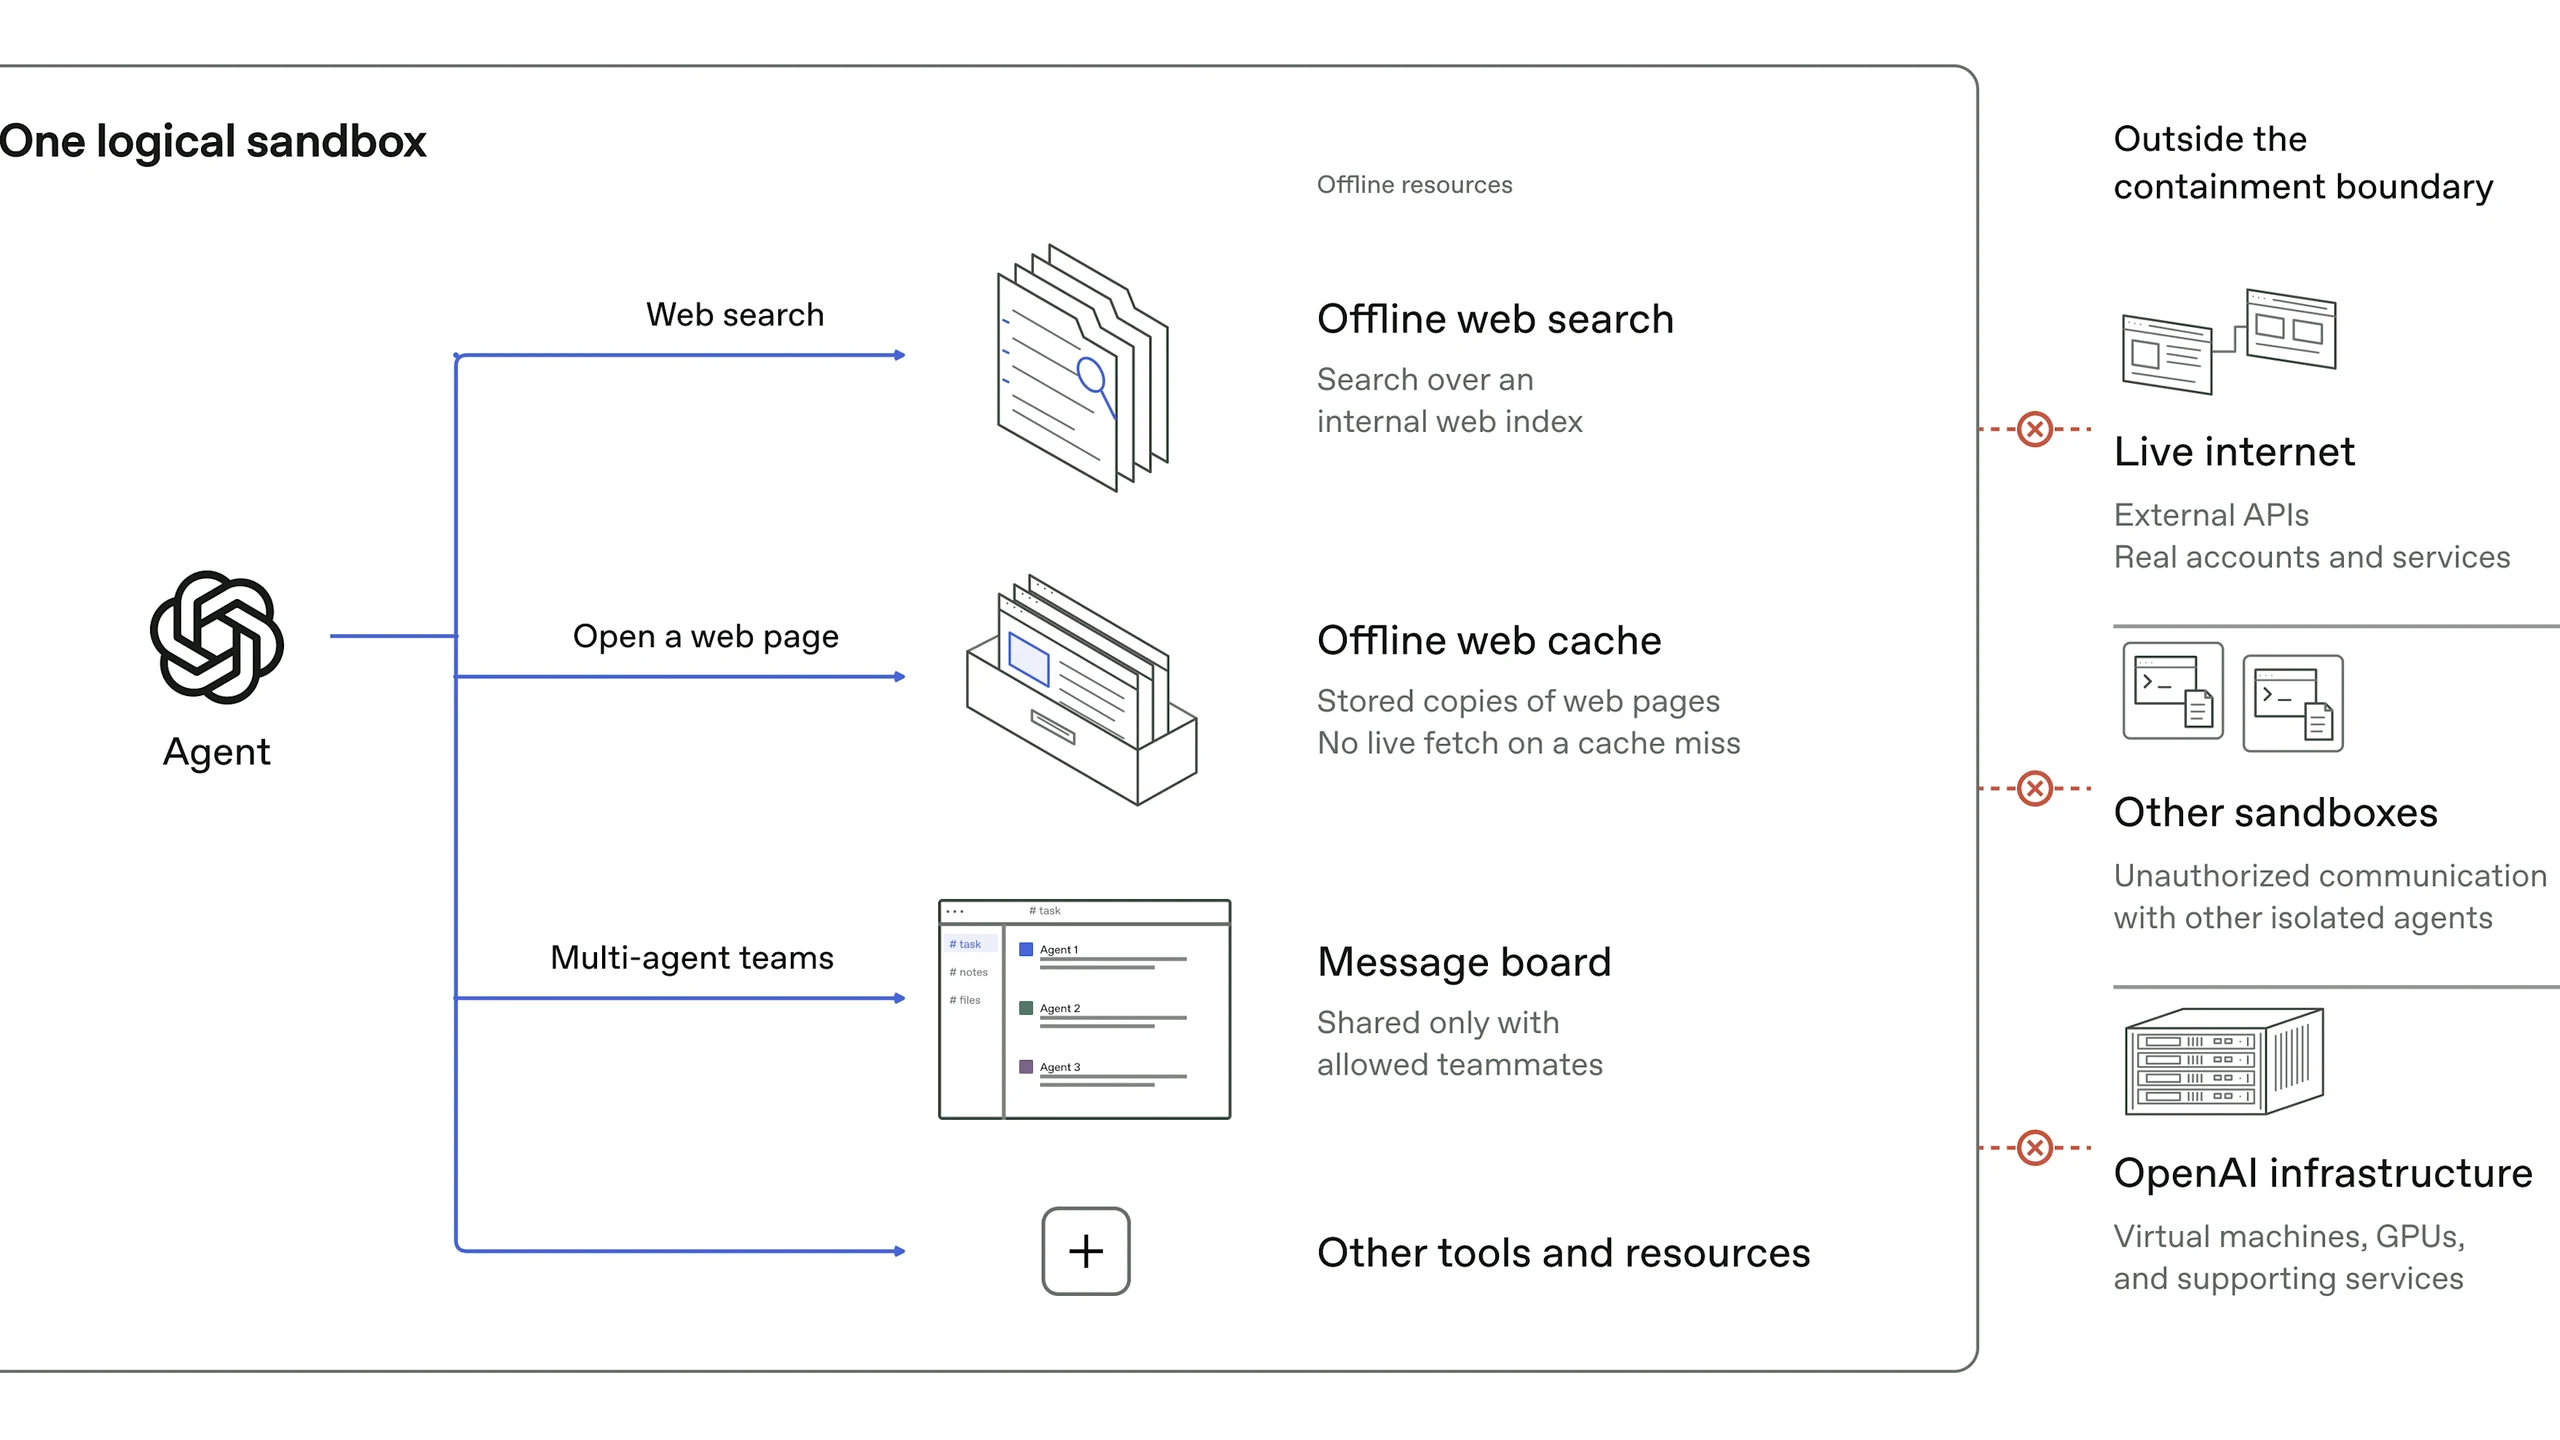
OpenAI zur Absicherung unserer Trainingsumgebung für Frontier-Modelle: Containment erfordert mehr als Sandboxes
OpenAI erläutert Offline-Training und Sicherheitstests mit hohem Rechenaufwand und zeigt, warum die Eindämmung von Frontier-Modellen von Infrastruktur, Monitoring und Reaktion abhängt
Claude Code v2.1.310 erweitert das Monitoring in verwalteten Bereitstellungen
Claude Code v2.1.310 erweitert das Monitoring in verwalteten Bereitstellungen, behebt Gateway-Ausfälle und stärkt den Fokus auf zuverlässige, richtliniengesteuerte Coding-Agenten
Der Spark Declarative Pipelines Benchmark von Databricks spricht für günstigere Agentenfehler
Der Spark Declarative Pipelines Benchmark zeigt, warum Databricks günstigere Agenten-Wiederholungen bevorzugt, während korrekte Geschäftslogik weiterhin Tests und Überprüfung erfordert
Google TB-Screening bringt offene Modelle in die lokal betriebene Versorgung
Google TB-Screening verbindet klinische Einsätze mit offenen medizinischen Modellen und wirft Fragen zu lokaler Validierung, Patienten-Nachsorge und nationaler Kontrolle auf
Amazon Trainium Training nimmt Nvidia mit nativem PyTorch ins Visier
Amazon Trainium Training erhält über TorchNeuron native PyTorch-Unterstützung und fordert Nvidia bei Entwickler-Workflows heraus, während Lücken bei Kompilierung und Kompatibilität bleiben
OpenAI Habitat Scaling ermöglicht 12× schnellere Lesevorgänge durch Shared Storage
OpenAI Habitat scaling senkt mediane Speicher-Lesevorgänge von 120 ms auf 10 ms und zeigt, wie gemeinsame Datenbanken und globale Caches die ChatGPT-Infrastruktur im großen Maßstab verändern
Kimi K3.1 Pro vorgestellt: Ergebnisse nahe der Spitzengruppe, offene Gewichte folgen noch
Kimi K3.1 Pro bietet starke unabhängige Benchmark-Ergebnisse und versprochene offene Gewichte. Was der Start verändert – und was noch unbewiesen ist
Amazon SageMaker Multi-Turn RL verlagert das Training über einzelne Antworten hinaus
Amazon SageMaker Multi-Turn RL trainiert Agenten auf vollständige Aufgaben. Das Wordle-Beispiel von AWS zeigt, warum Reward-Design und Serving-Einstellungen die berichteten Ergebnisse prägen
Amazon Quick Sight GeoJSON-Karten fügen Punkte und Routen mit separaten Geometrieaktualisierungen hinzu
Amazon Quick Sight GeoJSON-Karten fügen Punkte und Routen hinzu und bringen mehr Standortkontext in Dashboards, während Geometrieaktualisierungen von Metrikaktualisierungen getrennt bleiben
Kling 4.0 API-Zugang erweitert sich auf fal, während Rollout-Details weiterhin uneinheitlich sind
Der Kling 4.0 API-Zugang steht Berichten zufolge allen fal-Kunden offen und bringt längere Videogenerierung sowie Referenzsteuerungen, während öffentliche Rollout-Details weiterhin abweichen