
25 ottobre 2026 —
OpenAI sulla sicurezza dell'ambiente di addestramento dei modelli frontier: il contenimento richiede più dei sandbox
Questa edizione chiede come i team possano mantenere un controllo osservabile, valutabile e reversibile quando l’IA entra in processi e infrastrutture reali. Le fonti restano nella pagina dell’edizione.
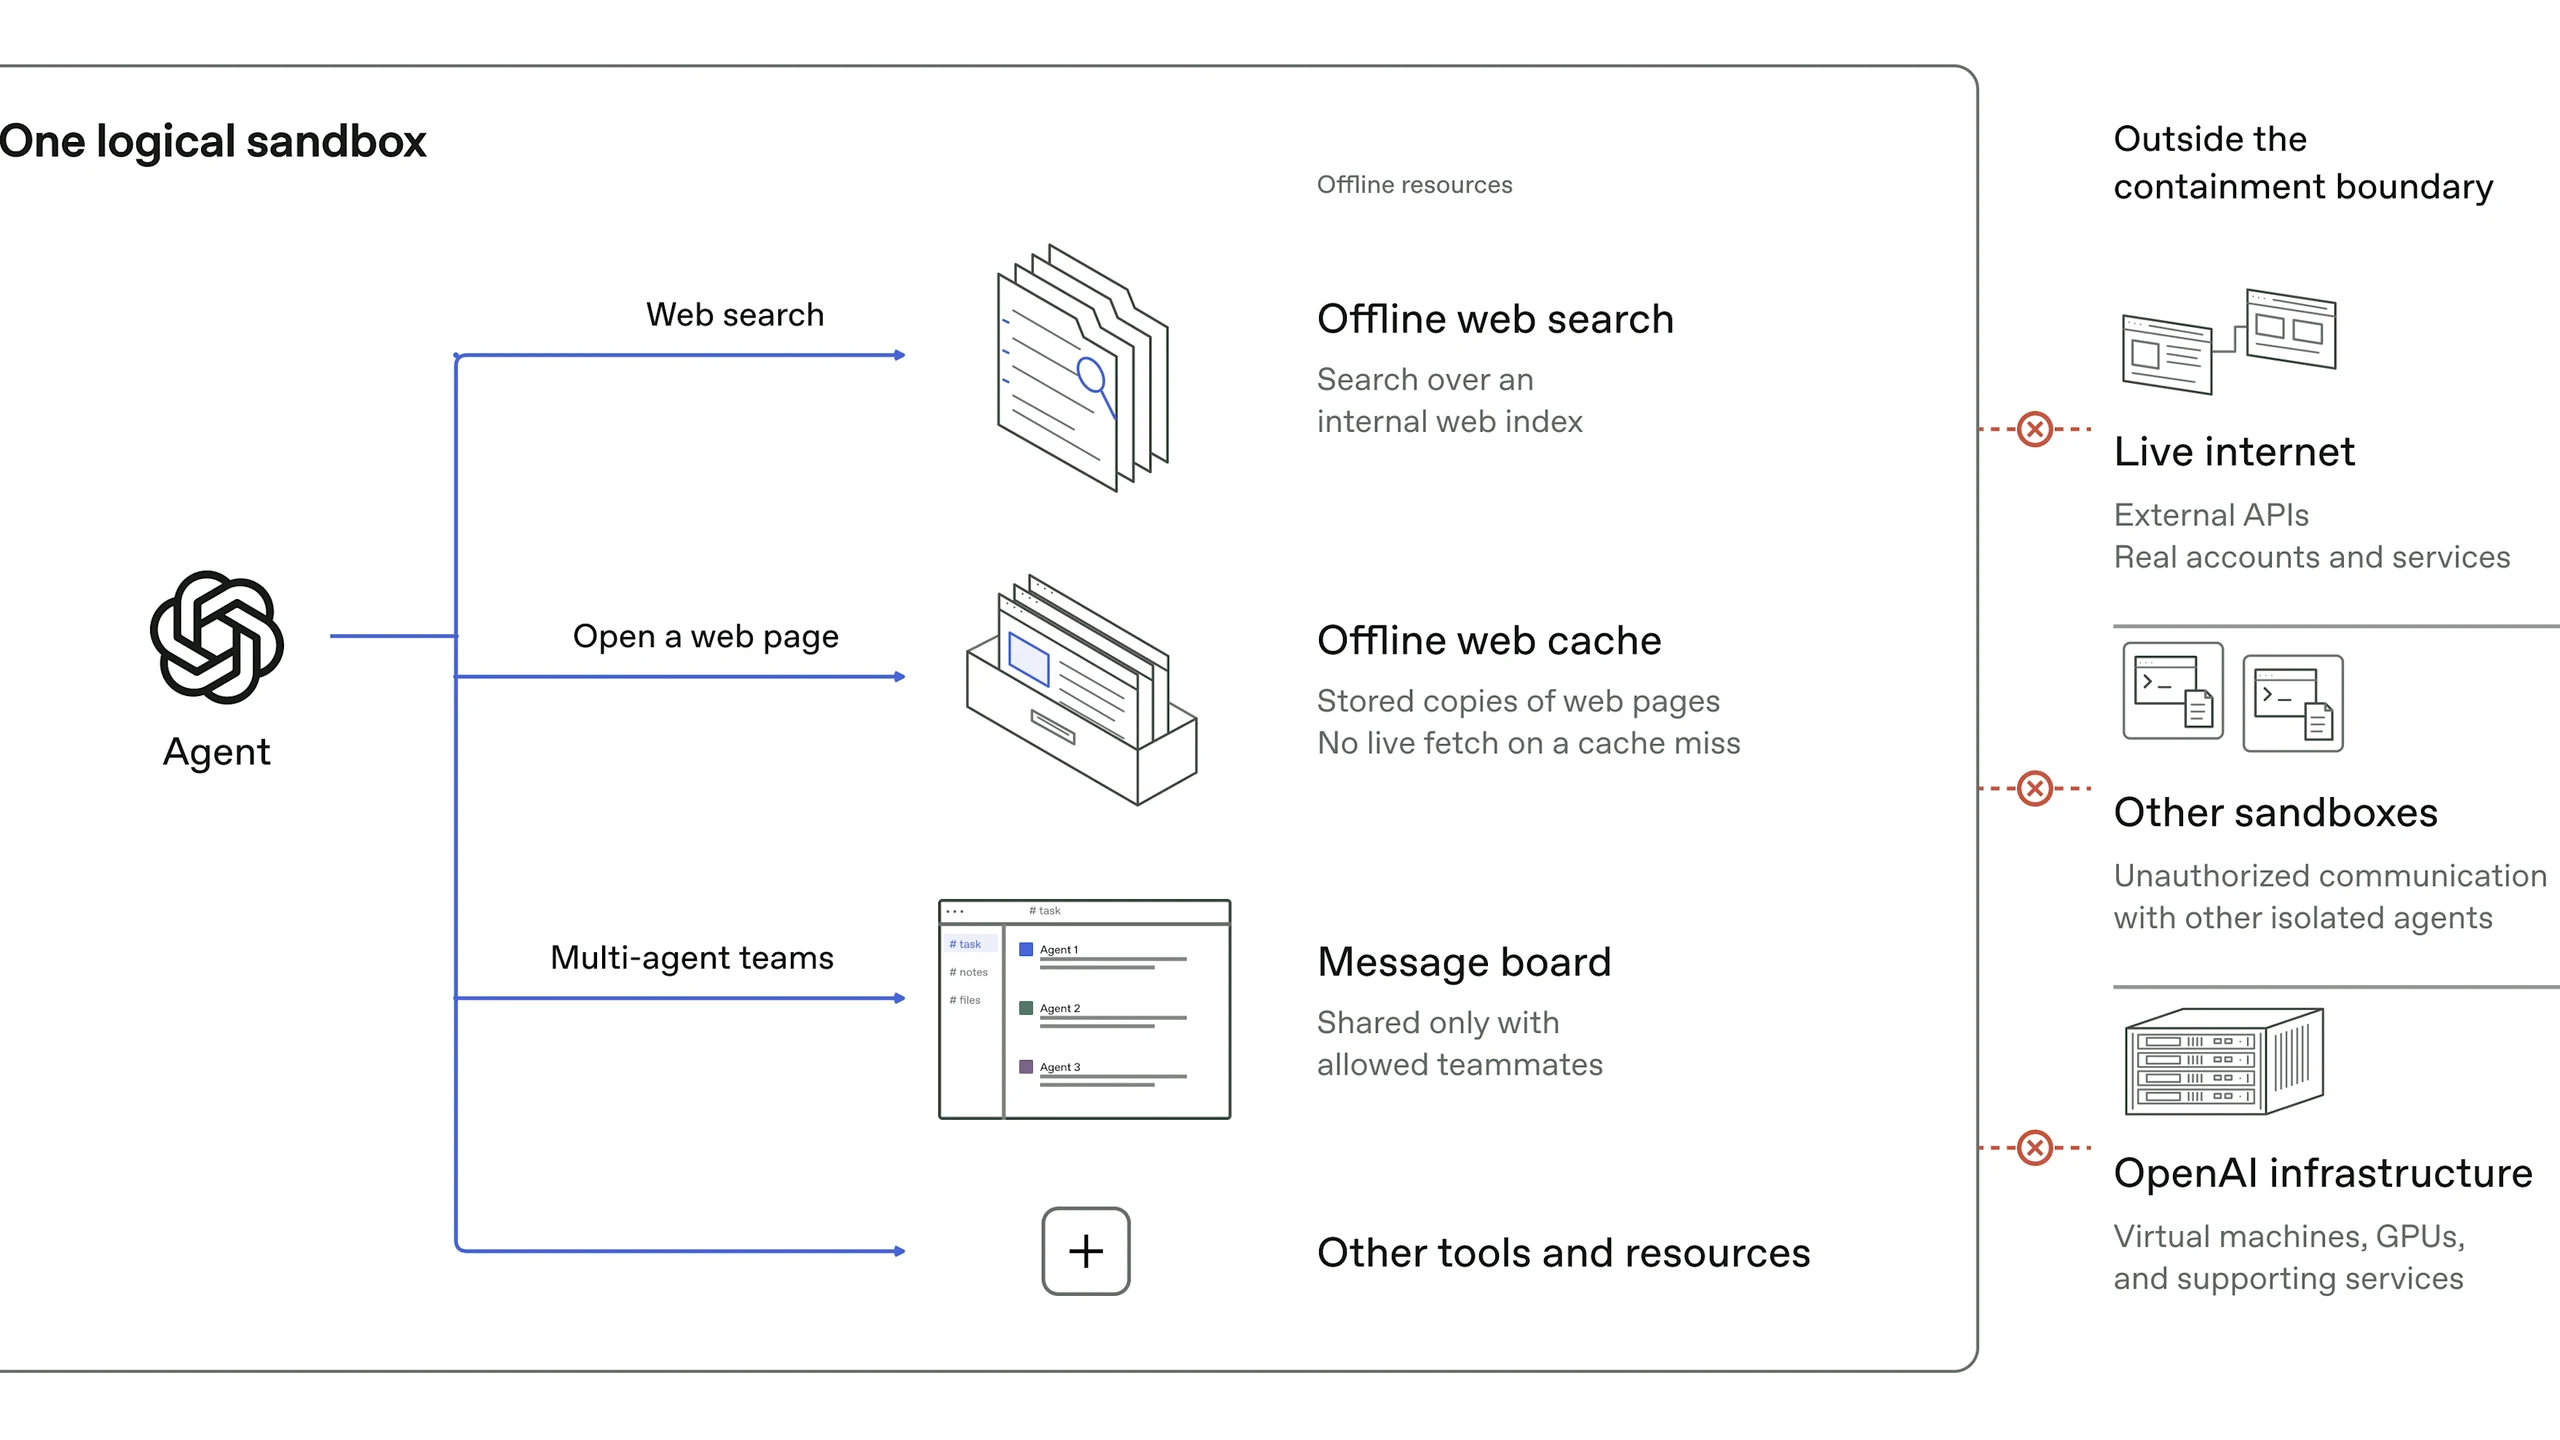
OpenAI sulla sicurezza dell'ambiente di addestramento dei modelli frontier: il contenimento richiede più dei sandbox
OpenAI descrive l'addestramento offline e i test di sicurezza ad alta capacità di calcolo, spiegando perché il contenimento dei modelli frontier dipende da infrastruttura, monitoraggio e risposta
Claude Code v2.1.310 amplia il monitoraggio nelle distribuzioni gestite
Claude Code v2.1.310 amplia il monitoraggio nelle distribuzioni gestite e risolve i malfunzionamenti del gateway, rafforzando l'attenzione su agenti di coding affidabili e controllati da policy
Il benchmark Spark Declarative Pipelines di Databricks sostiene il valore di errori degli agenti meno costosi
Il benchmark Spark Declarative Pipelines mostra perché Databricks privilegia retry degli agenti meno costosi, mentre una logica aziendale corretta richiede ancora test e revisione
Lo screening della TB di Google porta modelli aperti nell'assistenza gestita localmente
Lo screening della TB di Google combina implementazioni cliniche con modelli medici aperti, sollevando interrogativi su validazione locale, follow-up dei pazienti e controllo nazionale
L'addestramento Amazon Trainium sfida Nvidia con PyTorch nativo
L'addestramento Amazon Trainium ottiene il supporto PyTorch nativo tramite TorchNeuron, sfidando Nvidia nei flussi di lavoro degli sviluppatori mentre restano lacune di compilazione e compatibilità
La scalabilità di OpenAI Habitat porta letture 12× più veloci grazie allo storage condiviso
La scalabilità di OpenAI Habitat riduce le letture mediane dello storage da 120 ms a 10 ms, mostrando come database condivisi e cache globali rimodellino l'infrastruttura di ChatGPT su larga scala
Presentazione di Kimi K3.1 Pro: risultati vicini alla frontiera, con pesi aperti ancora in arrivo
Kimi K3.1 Pro porta solidi risultati in benchmark indipendenti e promette pesi aperti. Ecco cosa cambia con il lancio e cosa resta da dimostrare
Amazon SageMaker Multi-Turn RL porta l'addestramento oltre le risposte singole
Il RL multi-turn di Amazon SageMaker addestra agenti su attività complete. L'esempio Wordle di AWS mostra perché il design delle ricompense e le impostazioni di serving influenzano i risultati riportati
Le mappe GeoJSON di Amazon Quick Sight aggiungono punti e percorsi con aggiornamenti separati della geometria
Le mappe GeoJSON di Amazon Quick Sight aggiungono punti e percorsi, offrendo maggiore contesto geografico alle dashboard e mantenendo separati gli aggiornamenti della geometria dai refresh delle metriche
L'accesso all'API di Kling 4.0 si espande su fal, ma i dettagli del rollout restano disomogenei
Secondo quanto riportato, l'accesso all'API di Kling 4.0 è aperto a tutti i clienti fal, con generazione video più lunga e controlli di riferimento, mentre i dettagli pubblici del rollout restano divergenti