
25 października 2026 —
OpenAI o zabezpieczaniu środowiska trenowania modeli frontier: powstrzymywanie wymaga czegoś więcej niż sandboxów
To wydanie pyta, jak zespoły mogą zachować obserwowalną, ocenialną i odwracalną kontrolę, gdy AI trafia do prawdziwych procesów i infrastruktury. Źródła pozostają na stronie wydania.
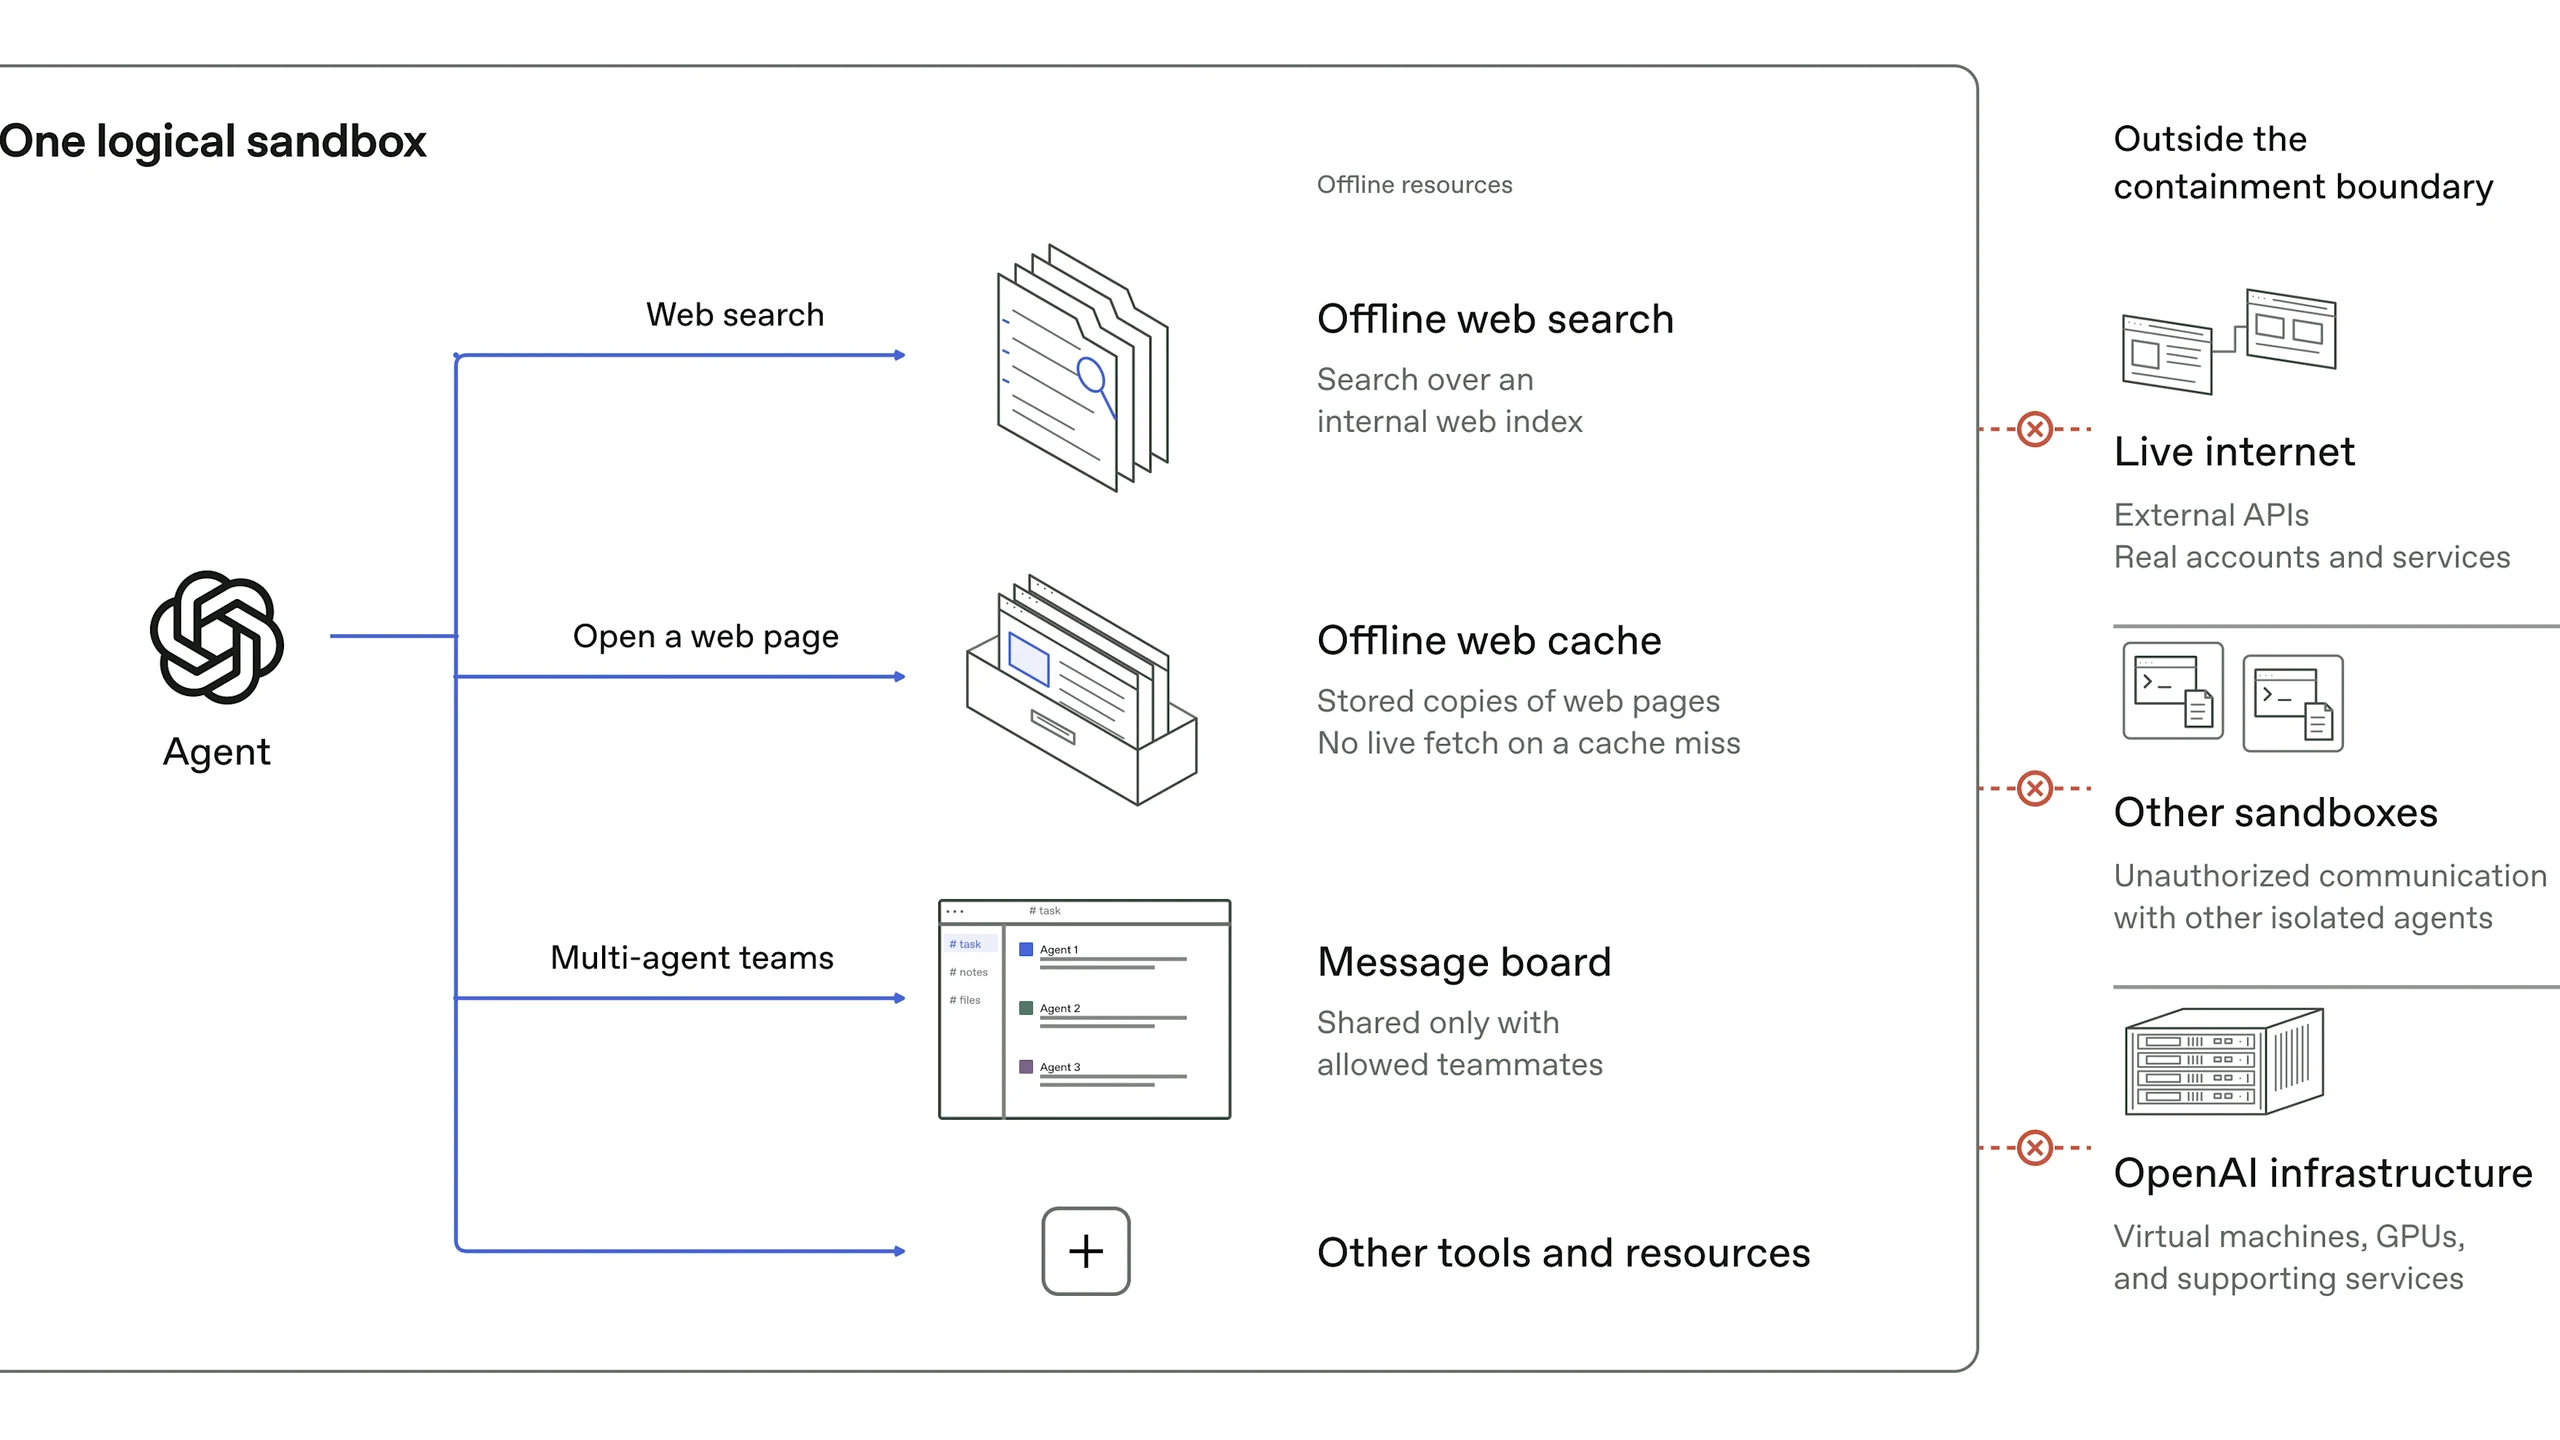
OpenAI o zabezpieczaniu środowiska trenowania modeli frontier: powstrzymywanie wymaga czegoś więcej niż sandboxów
OpenAI opisuje trenowanie offline i testy bezpieczeństwa przy dużej mocy obliczeniowej, wyjaśniając, dlaczego powstrzymywanie modeli frontier zależy od infrastruktury, monitorowania i reakcji
Claude Code v2.1.310 rozszerza monitorowanie w zarządzanych wdrożeniach
Claude Code v2.1.310 rozszerza monitorowanie w zarządzanych wdrożeniach i naprawia awarie bram, kładąc większy nacisk na niezawodnych agentów programistycznych kontrolowanych przez polityki
Benchmark Spark Declarative Pipelines firmy Databricks przemawia za tańszymi błędami agentów
Benchmark Spark Declarative Pipelines pokazuje, dlaczego Databricks stawia na tańsze ponowne próby agentów, podczas gdy poprawna logika biznesowa nadal wymaga testowania i przeglądu
Badania przesiewowe Google w kierunku gruźlicy wprowadzają otwarte modele do lokalnie prowadzonej opieki
Badania przesiewowe Google w kierunku gruźlicy łączą wdrożenia kliniczne z otwartymi modelami medycznymi, rodząc pytania o lokalną walidację, dalszą opiekę nad pacjentami i krajową kontrolę
Trenowanie Amazon Trainium rzuca wyzwanie Nvidia dzięki natywnemu PyTorch
Trenowanie Amazon Trainium zyskuje natywną obsługę PyTorch za pośrednictwem TorchNeuron, rzucając wyzwanie Nvidia w zakresie przepływów pracy deweloperów, mimo utrzymujących się luk w kompilacji i kompatybilności
Skalowanie OpenAI Habitat zapewnia 12× szybsze odczyty dzięki współdzielonemu magazynowi danych
Skalowanie OpenAI Habitat skraca medianę odczytów z magazynu danych z 120 ms do 10 ms, pokazując, jak współdzielone bazy danych i globalne pamięci podręczne przekształcają infrastrukturę ChatGPT na dużą skalę
Przedstawiamy Kimi K3.1 Pro: wyniki bliskie czołówce, a otwarte wagi wciąż przed nami
Premiera Kimi K3.1 Pro przynosi mocne wyniki niezależnych benchmarków i zapowiedź otwartych wag. Oto, co zmienia to uruchomienie i co pozostaje nieudowodnione
Amazon SageMaker Multi-Turn RL przenosi trenowanie poza pojedyncze odpowiedzi
Amazon SageMaker multi-turn RL trenuje agentów na pełnych zadaniach. Przykład Wordle od AWS pokazuje, dlaczego projektowanie nagród i ustawienia obsługi kształtują raportowane wyniki
Mapy GeoJSON Amazon Quick Sight dodają punkty i trasy z oddzielnymi aktualizacjami geometrii
Mapy GeoJSON Amazon Quick Sight dodają punkty i trasy, zapewniając pulpitom większy kontekst lokalizacyjny przy jednoczesnym oddzieleniu aktualizacji geometrii od odświeżania metryk
Dostęp do API Kling 4.0 rozszerza się na fal, choć szczegóły wdrożenia nadal są nierówne
Dostęp do API Kling 4.0 ma być otwarty dla wszystkich klientów fal, oferując dłuższe generowanie wideo i kontrolę odniesień, choć publiczne informacje o wdrożeniu nadal się różnią