
25 octobre 2026 —
OpenAI sur la sécurisation de son environnement d’entraînement de modèles de pointe : le confinement exige plus que des sandboxes
Cette édition examine comment les équipes peuvent préserver un contrôle observable, évaluable et réversible lorsque l’IA entre dans des processus et infrastructures réels. Les sources restent sur la page de l’édition.
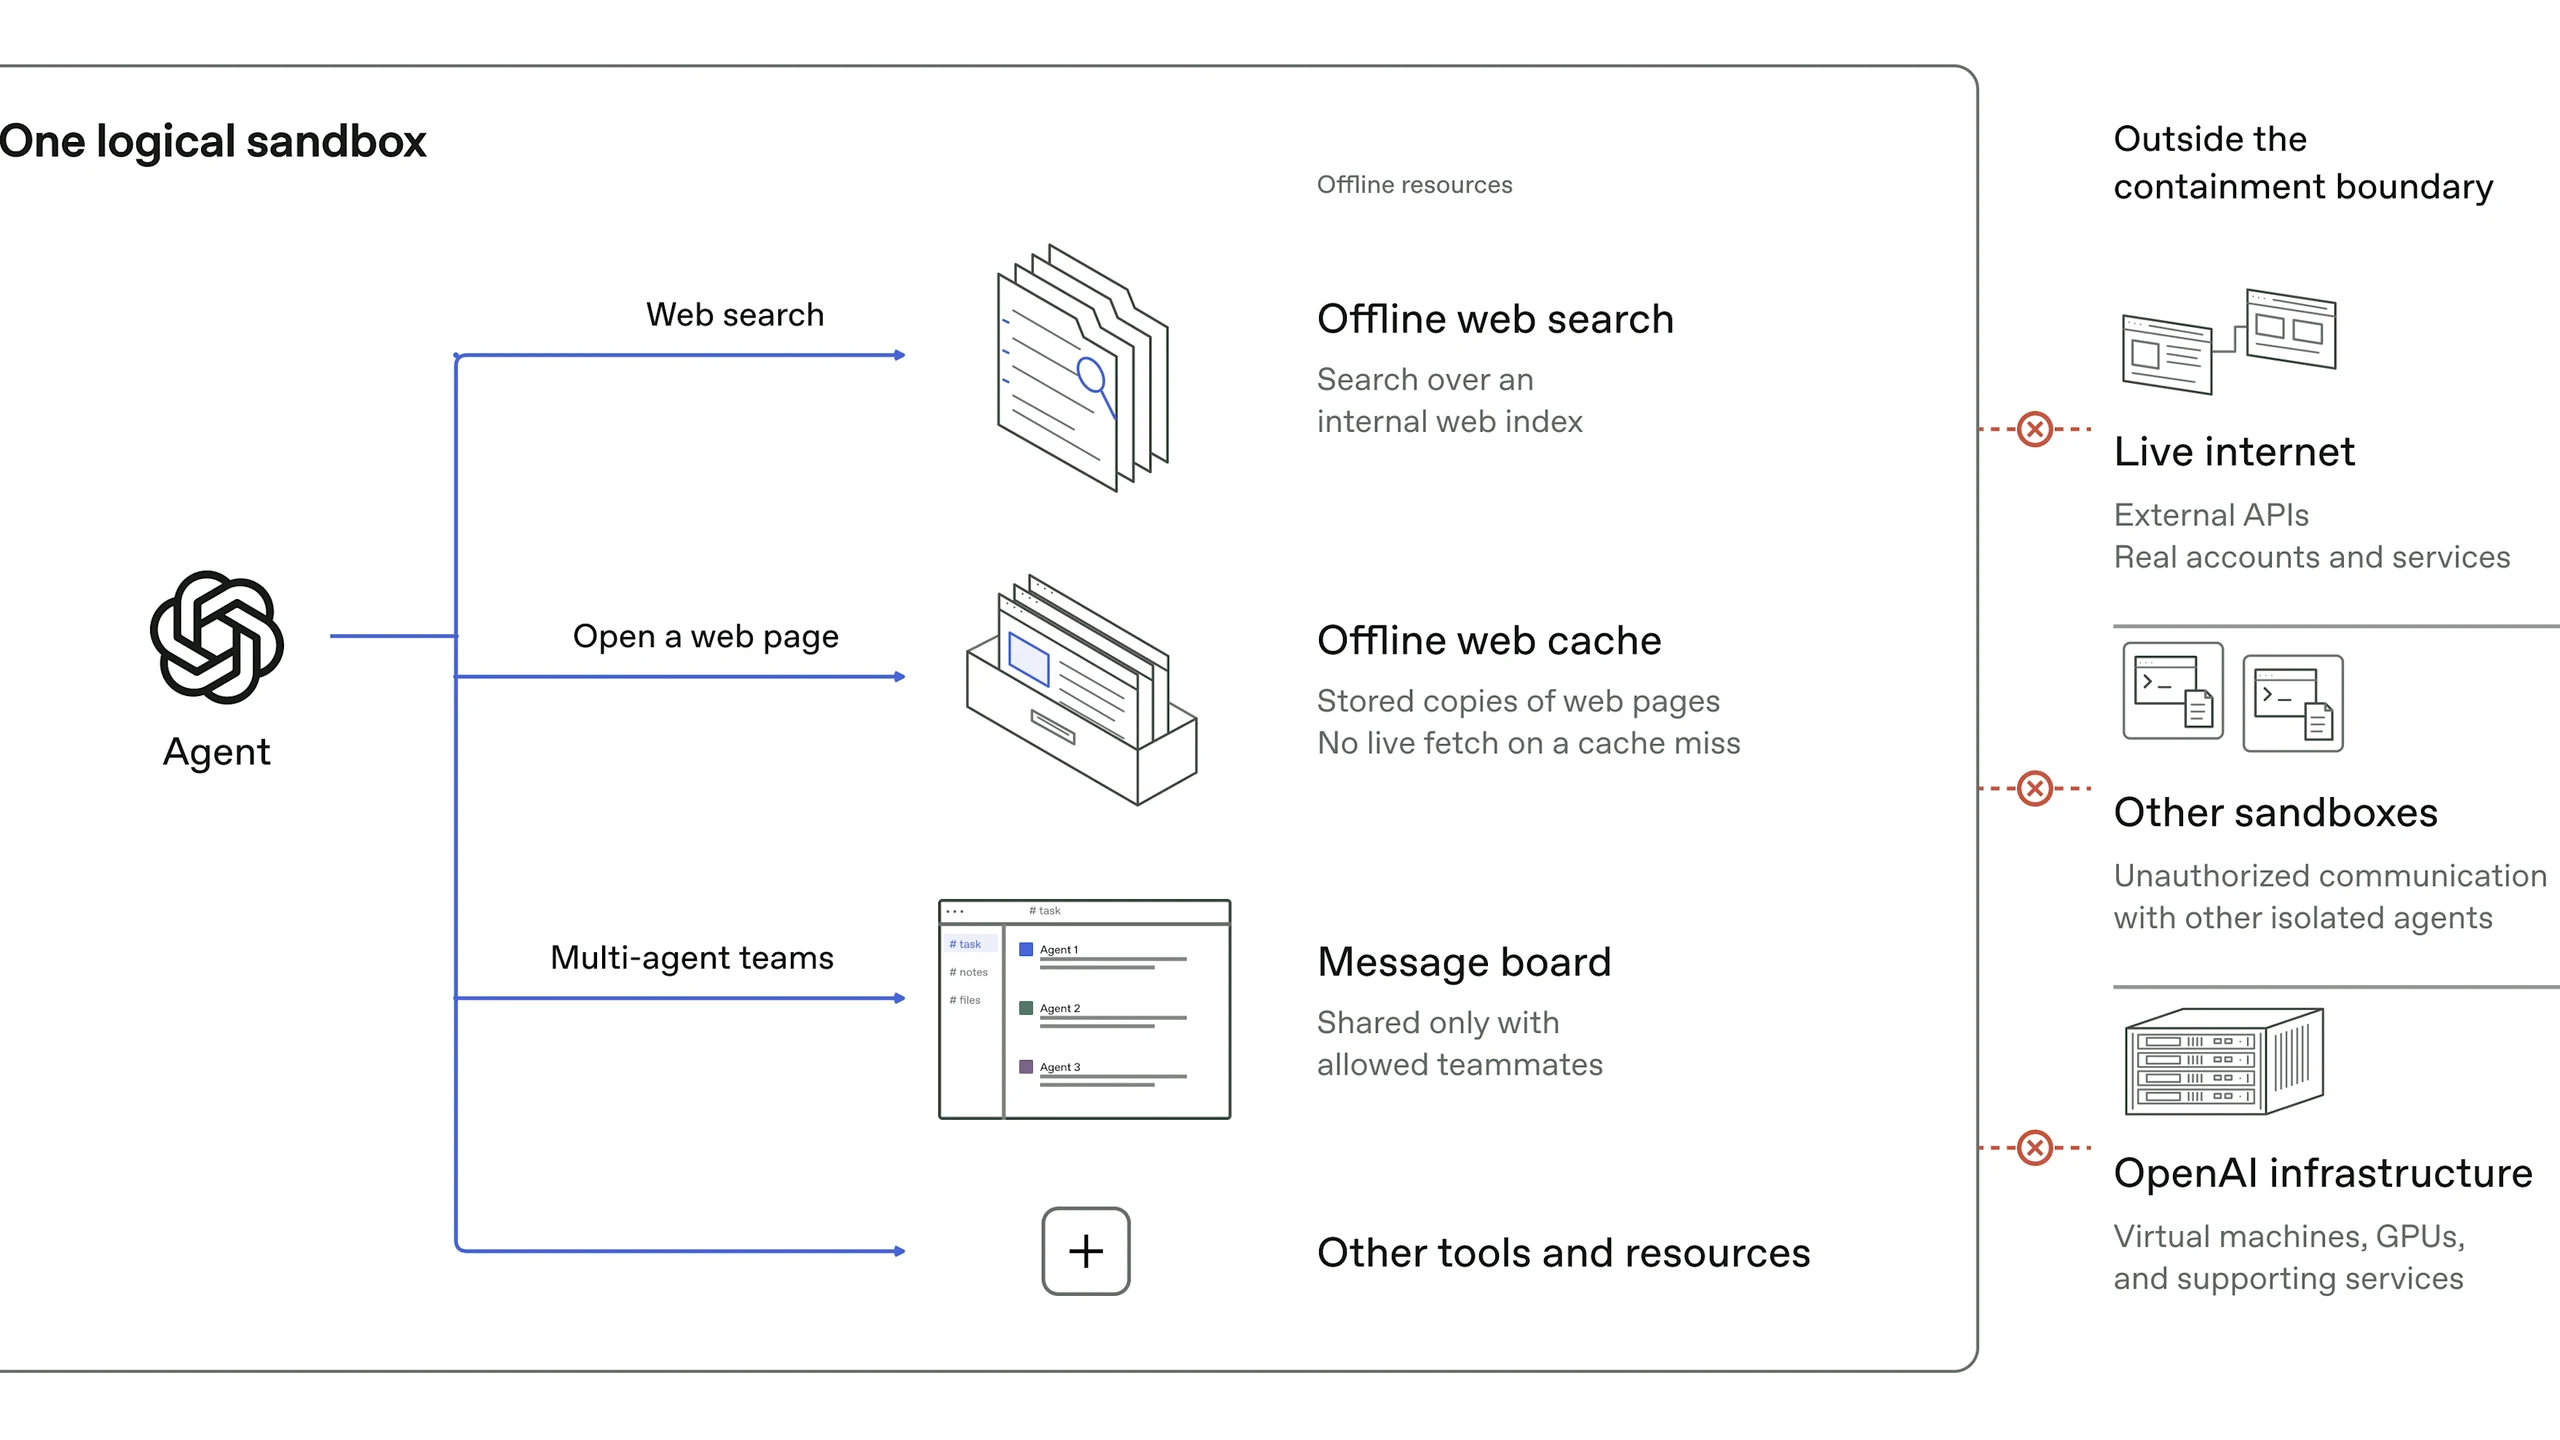
OpenAI sur la sécurisation de son environnement d’entraînement de modèles de pointe : le confinement exige plus que des sandboxes
OpenAI détaille l’entraînement hors ligne et les tests de sécurité à forte puissance de calcul, expliquant pourquoi le confinement des modèles de pointe dépend de l’infrastructure, de la surveillance et de la réponse
Claude Code v2.1.310 étend la surveillance aux déploiements gérés
Claude Code v2.1.310 étend la surveillance aux déploiements gérés et corrige des échecs de passerelle, renforçant l’accent sur des agents de codage fiables et contrôlés par des politiques
Le benchmark Spark Declarative Pipelines de Databricks plaide pour des erreurs d’agents moins coûteuses
Le benchmark Spark Declarative Pipelines montre pourquoi Databricks privilégie des nouvelles tentatives d’agents moins coûteuses, tandis qu’une logique métier correcte exige toujours des tests et une revue
Le dépistage de la tuberculose par Google introduit des modèles ouverts dans des soins gérés localement
Le dépistage de la tuberculose par Google associe des déploiements cliniques à des modèles médicaux ouverts, soulevant des questions sur la validation locale, le suivi des patients et le contrôle national
L’entraînement Amazon Trainium défie Nvidia avec PyTorch natif
L’entraînement Amazon Trainium bénéficie d’une prise en charge native de PyTorch via TorchNeuron, défiant Nvidia sur les flux de travail des développeurs malgré des lacunes de compilation et de compatibilité
La montée en charge d’OpenAI Habitat accélère les lectures de 12× grâce au stockage partagé
La montée en charge d’OpenAI Habitat réduit les lectures médianes du stockage de 120 ms à 10 ms, révélant comment bases de données partagées et caches mondiaux redessinent l’infrastructure ChatGPT à grande échelle
Présentation de Kimi K3.1 Pro : des résultats proches de la frontière, avec des poids ouverts encore à venir
Kimi K3.1 Pro affiche de solides résultats sur des benchmarks indépendants et promet des poids ouverts. Voici ce que ce lancement change, et ce qui reste à prouver
Amazon SageMaker Multi-Turn RL fait passer l’entraînement au-delà des réponses uniques
Le RL multi-turn d’Amazon SageMaker entraîne des agents sur des tâches complètes. L’exemple Wordle d’AWS montre pourquoi la conception des récompenses et les paramètres de service façonnent les résultats rapportés
Les cartes GeoJSON d’Amazon Quick Sight ajoutent des points et des itinéraires avec des mises à jour de géométrie distinctes
Les cartes GeoJSON d’Amazon Quick Sight ajoutent des points et des itinéraires, apportant davantage de contexte géographique aux tableaux de bord tout en séparant les mises à jour de géométrie des actualisations de métriques
L’accès à l’API Kling 4.0 s’étend sur fal, mais les détails du déploiement restent inégaux
L’accès à l’API Kling 4.0 serait ouvert à tous les clients fal, avec une génération vidéo plus longue et des contrôles de référence, tandis que les détails publics du déploiement divergent encore