
25 de octubre de 2026 —
OpenAI sobre la seguridad de su entorno de entrenamiento de modelos de frontera: la contención requiere más que sandboxes
Esta edición analiza cómo los equipos pueden conservar control observable, evaluable y reversible cuando la IA entra en procesos e infraestructura reales. Las fuentes originales permanecen en la página de la edición.
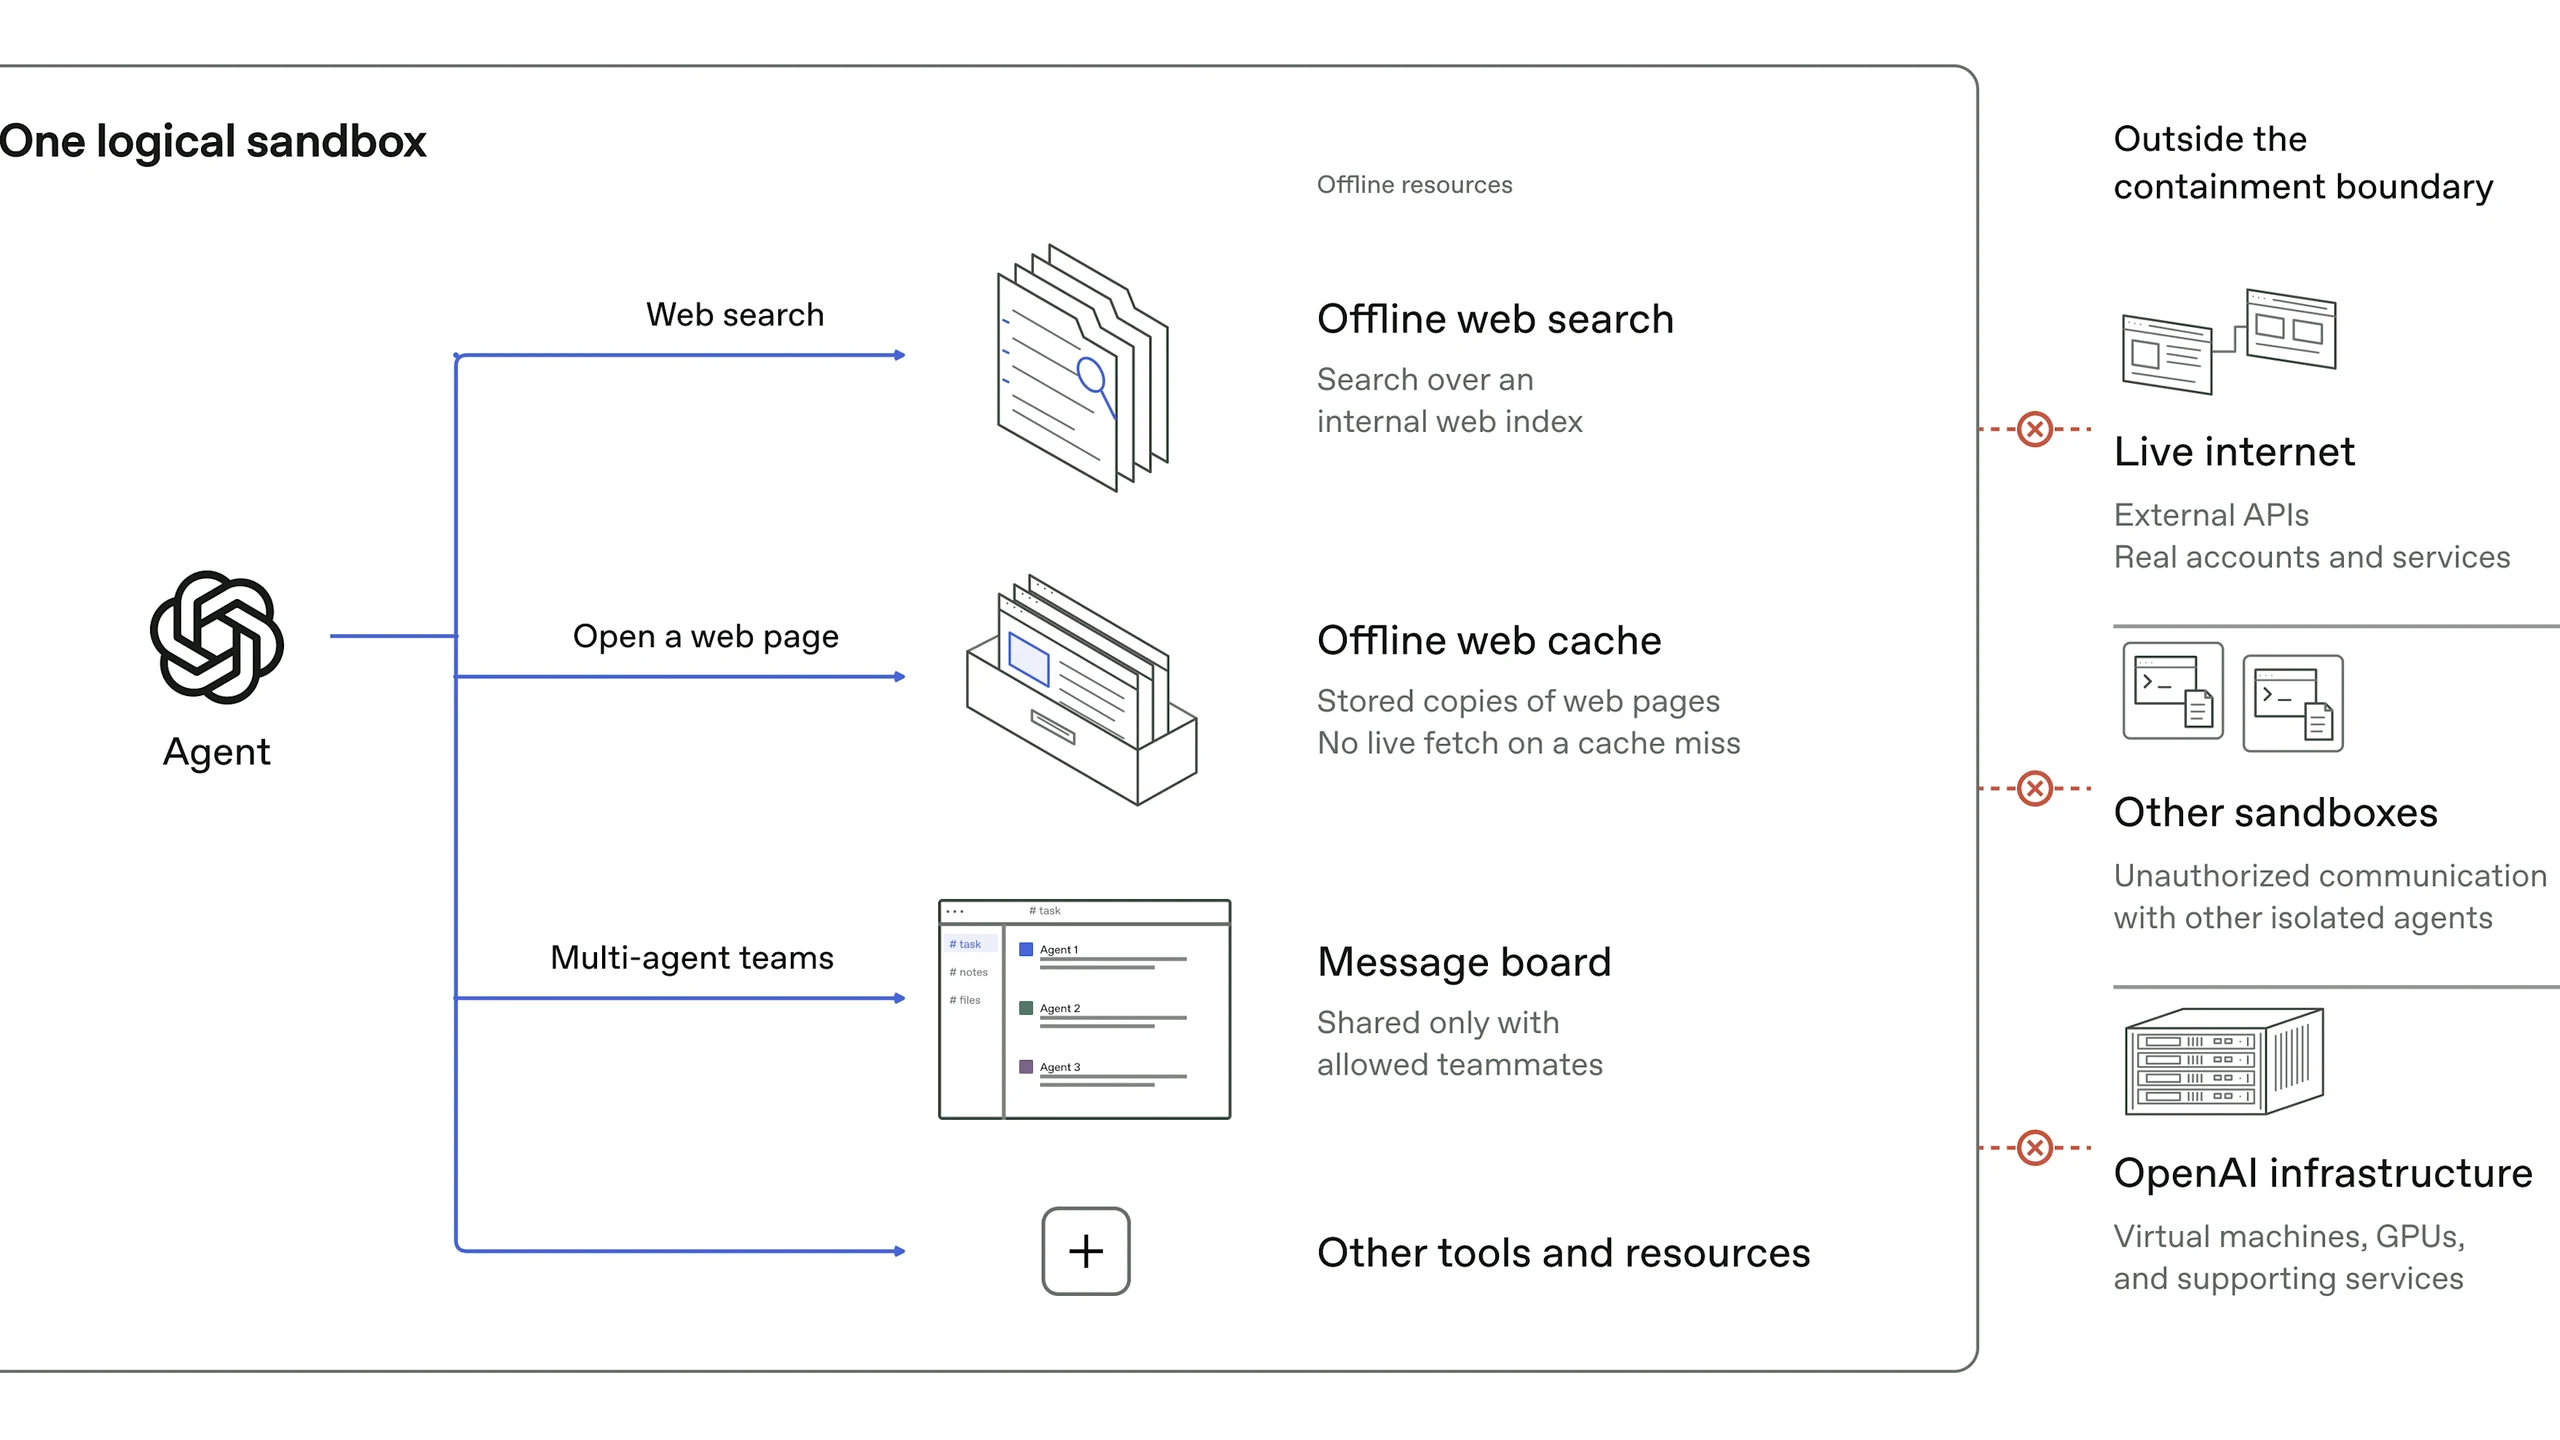
OpenAI sobre la seguridad de su entorno de entrenamiento de modelos de frontera: la contención requiere más que sandboxes
OpenAI detalla el entrenamiento offline y las pruebas de seguridad de alto cómputo, revelando por qué la contención de modelos de frontera depende de la infraestructura, la supervisión y la respuesta
Claude Code v2.1.310 amplía la monitorización en implementaciones gestionadas
Claude Code v2.1.310 amplía la monitorización en implementaciones gestionadas y corrige fallos de gateway, reforzando el enfoque en agentes de programación fiables y controlados por políticas
El benchmark de Spark Declarative Pipelines de Databricks defiende errores de agentes más baratos
El benchmark de Spark Declarative Pipelines muestra por qué Databricks prefiere reintentos de agentes más baratos, mientras que la lógica empresarial correcta aún requiere pruebas y revisión
El cribado de TB de Google lleva modelos abiertos a la atención gestionada localmente
El cribado de TB de Google combina despliegues clínicos con modelos médicos abiertos y plantea interrogantes sobre la validación local, el seguimiento de pacientes y el control nacional
El entrenamiento de Amazon Trainium apunta a Nvidia con PyTorch nativo
El entrenamiento de Amazon Trainium incorpora soporte nativo de PyTorch mediante TorchNeuron, desafiando a Nvidia en los flujos de trabajo de desarrolladores mientras persisten brechas de compilación y compatibilidad
El escalado de OpenAI Habitat logra lecturas 12× más rápidas mediante almacenamiento compartido
El escalado de OpenAI Habitat reduce las lecturas medianas de almacenamiento de 120 ms a 10 ms, revelando cómo las bases de datos compartidas y las cachés globales transforman la infraestructura de ChatGPT a gran escala
Presentamos Kimi K3.1 Pro: resultados cercanos a la frontera, con pesos abiertos aún por llegar
Presentamos Kimi K3.1 Pro, con sólidos resultados en benchmarks independientes y pesos abiertos prometidos. Esto es lo que cambia con el lanzamiento y lo que aún falta por demostrar
Amazon SageMaker Multi-Turn RL Lleva el Entrenamiento Más Allá de las Respuestas Únicas
El RL multi-turn de Amazon SageMaker entrena agentes en tareas completas. El ejemplo de Wordle de AWS muestra por qué el diseño de recompensas y la configuración de serving determinan los resultados comunicados
Los mapas GeoJSON de Amazon Quick Sight añaden puntos y rutas con actualizaciones de geometría independientes
Los mapas GeoJSON de Amazon Quick Sight añaden puntos y rutas, aportando más contexto de ubicación a los paneles mientras mantienen las actualizaciones de geometría separadas de las actualizaciones de métricas
El acceso a la API de Kling 4.0 se amplía en fal, aunque los detalles del despliegue siguen siendo desiguales
Según se informa, el acceso a la API de Kling 4.0 está abierto a todos los clientes de fal, con generación de vídeo más larga y controles de referencia, aunque los detalles públicos del despliegue aún difieren