
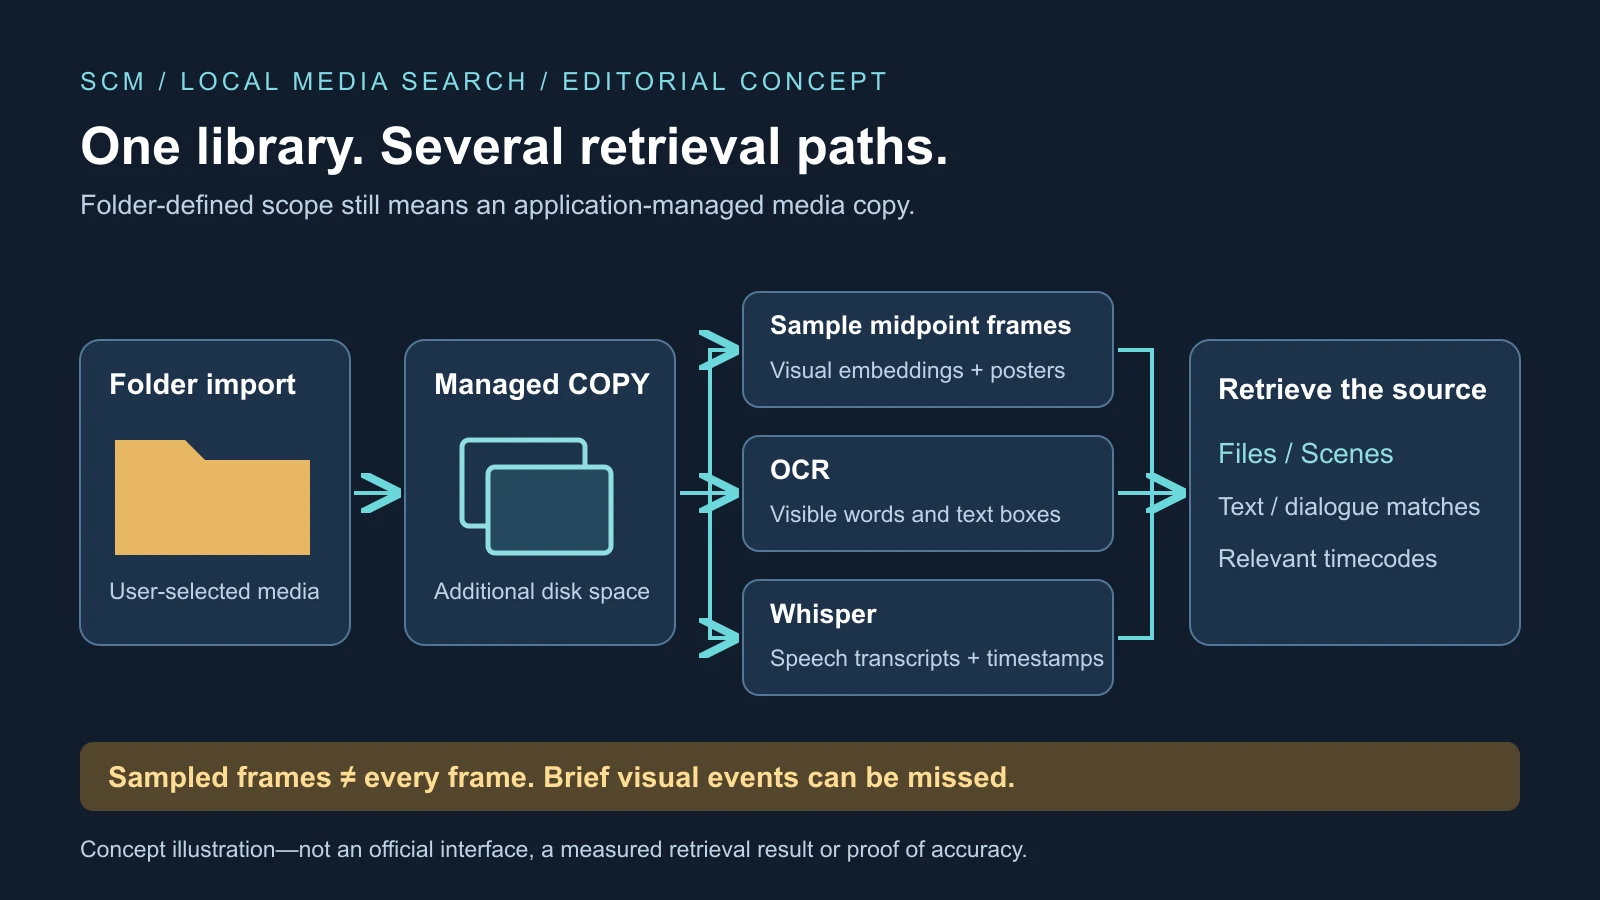
A oportunidade do SCM frente ao Apple Photos não é uma nova alegação de que imagens podem ser pesquisadas com linguagem cotidiana. A Apple já oferece isso. O aplicativo aberto para Mac combina busca visual, de cenas, texto e fala em mídias selecionadas de pastas, incluindo exportações de projetos e arquivos em discos externos. A estreia torna o processo inspecionável, mas não estabelece precisão ou adoção: o registro inicial do Hacker News tinha quatro pontos e nenhum comentário.
Há uma ressalva para quem imagina um índice leve sobre um disco existente. O SCM copia as mídias importadas para sua própria biblioteca gerenciada. E, embora prometa localizar momentos ao longo dos vídeos, sua cadeia visual documentada amostra quadros representativos, em vez de analisar separadamente cada quadro decodificado. Essas duas escolhas determinam suas capacidades e seus custos de operação.
Várias buscas, não um modelo que sabe tudo
O repositório SCM descreve Files, Scenes, OCR e Dialogue, além de um modelo local opcional de perguntas e respostas. Files recupera fotos ou vídeos inteiros por significado visual; Scenes retorna momentos com códigos de tempo. OCR pesquisa palavras visíveis. Dialogue usa transcrições Whisper para localizar palavras exatas em instantes específicos. A camada opcional Ask trabalha com texto já extraído, não com uma compreensão independente de tudo nas mídias originais.
Essas rotas são complementares. Um editor de documentários pode lembrar uma frase de entrevista, um carro vermelho nas imagens de apoio ou um e-mail numa autorização digitalizada. Busca em transcrições, embeddings visuais e OCR respondem a partes diferentes do problema. Uma associação como “cachorro ao lado de um carro vermelho” não garante a leitura de um número de série minúsculo; uma transcrição não recupera uma frase que o reconhecimento de fala registrou incorretamente.
O SCM expõe parte dessa separação nas explicações dos resultados. Emblemas distinguem correspondências visuais e de nome de arquivo; resultados de diálogos mostram trechos coincidentes da transcrição. Pontuações e dicas tornam mais visível o caminho até o resultado. São recursos de diagnóstico, não provas de que a classificação está correta. O usuário pode distinguir falha de transcrição de consulta visual malsucedida, sem tratar toda omissão como o mesmo erro misterioso da IA.
Abas de buscas salvas mantêm consulta e modo enquanto as pastas monitoradas mudam. A visualização de capturas de tela combina nomes, metadados, contexto de pastas e correções manuais, não apenas aparência. Uma visualização especializada de e-mail tenta reconstruir endereços divididos entre caixas de OCR ou danificados por erros de pontuação. Esses detalhes ampliam a recuperação além de uma galeria convencional, sem tornar o OCR infalível.
Coleções definidas por pastas ainda criam outra cópia
As mídias entram por importação no aplicativo, arrastar e soltar ou pastas monitoradas. O projeto afirma que essas pastas recebem atualizações ao vivo e são examinadas novamente na inicialização. Antes da cópia, calcula um hash de conteúdo SHA-256 para reconhecer duplicatas renomeadas e verifica o tipo real de mídia, não apenas a extensão. Planos de cenas em cache também podem evitar repetir parte do trabalho na reimportação.
A cópia fica no diretório de suporte do aplicativo. Portanto, um arquivo externo não continua como referência apenas indexada: a mídia original e a cópia gerenciada coexistem, além de embeddings, miniaturas, pôsteres de cenas, transcrições, caixas de OCR e arquivos auxiliares. Vários terabytes de filmagem representam um compromisso de armazenamento muito diferente de uma pequena coleção de capturas de tela. Snapshots de versões dos embeddings acrescentam custo, embora limitados a dez.
A distribuição descrita pelo projeto atende Macs Apple silicon com macOS 12 ou posterior, via Homebrew. Electron empacota o aplicativo, React fornece a interface e workers separados cuidam de visão, OCR e fala. A licença MIT permite inspecionar e adaptar código, compilações e testes. Isso não comprova que um lançamento ou dependência não auditados sejam seguros, nem que um único mantenedor consiga acompanhar todas as mudanças de componentes upstream.
A comparação com Photos também exige precisão. A documentação do Apple Photos já descreve busca em linguagem natural por imagens e momentos-chave de vídeo, com filtros de fotos, vídeos, capturas, favoritos e palavras-chave. Photos integra pessoas, animais, álbuns, edições, memórias e iCloud. A oportunidade mais específica do SCM é um corpus definido pelo usuário de pastas de produção, backups de cartões e arquivos de clientes fora dessa biblioteca, não uma prova de que substituirá Photos para a maioria.
O que a busca de cenas realmente amostra
Primeiro, FFmpeg examina limites entre tomadas; depois o SCM cria um plano de segmentos com a densidade escolhida. Os presets vão de um ponto de busca a cada 60 segundos a um a cada 2,5 segundos. O padrão equilibrado usa intervalos de 30 segundos e um orçamento declarado de 8–128 segmentos. Para cada segmento, o programa gera o embedding do quadro central e guarda uma imagem de prévia. A consulta textual vira uma representação numérica comparável aos quadros armazenados.
A pesquisa do arquivo de vídeo inteiro usa outro resumo: quadros em 20%, 50% e 80% da duração, com embeddings calculados pela média. Isso pode representar o caráter geral do arquivo, mas não todas as cenas incomuns. Scenes é a rota adequada para um momento lembrado. Mesmo assim, uma cartela de um segundo, uma placa de carro passando ou alguém aparecendo brevemente numa tomada longa podem cair entre os quadros representativos.
A razão computacional é clara. Um vídeo de 30 minutos a 30 quadros por segundo tem 54.000 quadros; indexar todos multiplicaria processamento e tamanho do índice, preservando muita redundância. Amostragem mais densa reduz lacunas com custo adicional de tempo e armazenamento. Não transforma um índice amostrado em garantia de cobertura completa quadro a quadro.
O SCM aplica filtro de ruído, limiares calibrados por modelo e filtragem de quase duplicatas, limitando cada vídeo a três resultados de cenas. Isso pode aumentar diversidade e suprimir correspondências fracas, mas também esconder vários momentos válidos do mesmo arquivo. Cores, composição ou associações aprendidas podem ter pontuação alta sem identificar o assunto desejado. Um mapa de cenas descreve melhor o sistema do que a promessa de que cada quadro foi compreendido.
Os modelos alteram velocidade e comportamento
O mecanismo padrão é CLIP ViT-L/14 com entrada de 336 pixels e download de aproximadamente 435MB. A visão geral do CLIP da OpenAI explica o aprendizado de associações entre imagens e texto, que permite recuperar conceitos sem rotular cada um manualmente. O SCM oferece ainda três variantes SigLIP. A pesquisa SigLIP 2 destaca compreensão multilíngue, recuperação imagem-texto e localização; essas propriedades, sozinhas, não estabelecem precisão em um arquivo pessoal.
Os números de inferência em CPU informados pelo projeto vão de aproximadamente 50–100 milissegundos por imagem na opção mais rápida a cerca de 200 ou 480 milissegundos nas mais lentas. Não são benchmarks independentes entre Macs. Trocar o modelo provoca nova geração de embeddings em segundo plano, enquanto o SCM recorre temporariamente aos nomes de arquivo. Portanto, não é uma troca gratuita de relevância sobre um índice inalterado.
O OCR inclui inglês e 35 opções adicionais de idiomas, mas pacotes não garantem reconhecimento com todas as resoluções, contrastes, fontes e orientações. Whisper pode errar sotaques, vozes sobrepostas, ruído e vocabulário especializado. Embeddings visuais podem herdar vieses sociais ou culturais; o model card CLIP pede testes rigorosos no domínio pretendido. “Uma reunião tensa” exige interpretação, enquanto identificar quem aprovou um contrato pode exigir conhecimento ausente dos pixels.
Essas limitações tornam avaliações por modo mais informativas do que uma taxa combinada de sucesso. Momentos-alvo conhecidos e consultas escritas antes de ver os resultados podem revelar recall, falsos positivos e tempo até o resultado separadamente em Scenes, Files, OCR e Dialogue. O SCM inclui testes unitários, testes de fumaça do Electron e scripts de benchmark, mas testes de regressão de software não equivalem a um benchmark independente e representativo de recuperação.
Privacidade local não elimina confiança
O SCM afirma não ter contas, telemetria ou uploads de mídia. Após baixar pesos de visão, dados OCR e arquivos Whisper necessários, o processamento pode ocorrer localmente e a indexação visual pode funcionar offline. O modelo de linguagem opcional fica desativado até ser habilitado; recebe diálogos, OCR e evidências de nomes de arquivo extraídos. Seu processo auxiliar usa loopback, normalmente restringindo conexões à mesma máquina.
Segundo o projeto, Ask cita as evidências locais e para antes de gerar quando não há evidência. Isso reduz uma via de respostas sem apoio, não todos os erros: um modelo pequeno pode resumir incorretamente uma transcrição real. Citações são um caminho de volta à mídia, não substituem a verificação. A ideia lembra uma base de conhecimento pessoal centrada em mídia, mas recuperação e geração de respostas continuam sendo problemas distintos de confiabilidade.
A distribuição cria outra fronteira de confiança. As instruções Homebrew exigem confiar no tap ou cask do projeto e afetam a quarentena do macOS; não equivalem à revisão da Mac App Store. Compilações locais sem assinatura podem gerar avisos. A assinatura identifica o desenvolvedor e ajuda a verificar que o código não mudou após assinado, mas não prova segurança inerente. O SHA-256 também verifica correspondência com bytes esperados, não a confiabilidade desses bytes.
As dependências incluem Electron, FFmpeg, ONNX Runtime, Tesseract, Whisper, modelos de visão e llama.cpp opcional. O código aberto permite examinar comportamento de rede e substituir componentes, mas a maioria não auditará toda a cadeia. Malware, contas compartilhadas, backups inseguros e Mac desbloqueado ainda podem expor a biblioteca local. A vantagem é menor exposição obrigatória à nuvem, não imunidade ao comprometimento do dispositivo.
O teste restante é uma biblioteca duradoura
Controles em segundo plano e pausa global reconhecem que a indexação compete com trabalho normal, calor, bateria e memória. Mesmo inferência rápida por imagem vira trabalho contínuo em centenas de milhares de amostras, além das filas separadas de OCR e transcrição. Hashes, planos em cache, snapshots e novas tentativas são bases úteis, mas importações interrompidas, discos desconectados, índices danificados e migrações de modelos testarão a recuperação em escala.
O SCM entra numa categoria existente de ferramentas locais de fotos para Mac e vídeo profissional, não num mercado vazio. Sua combinação útil é código aberto, escopo por pastas, processamento local e múltiplos modos. Lançamentos reproduzíveis, resposta a problemas, relatos de segurança, contribuições externas e avaliações independentes importarão mais do que estrelas ou uma interface de chat elaborada.
Uma pasta representativa e controlada pode expor essas escolhas antes que um arquivo inteiro seja copiado. Vídeos longos, capturas, texto visível, diálogos e arquivos semelhantes revelam falhas diferentes; tempo de importação, espaço adicional e timestamps da fonte tornam os resultados mensuráveis. Originais e backups devem ficar fora da cópia gerenciada. A promessa substancial é encontrar repetidamente a fonte certa perto do momento certo, não apenas adicionar outra caixa de busca com IA ao Mac.