
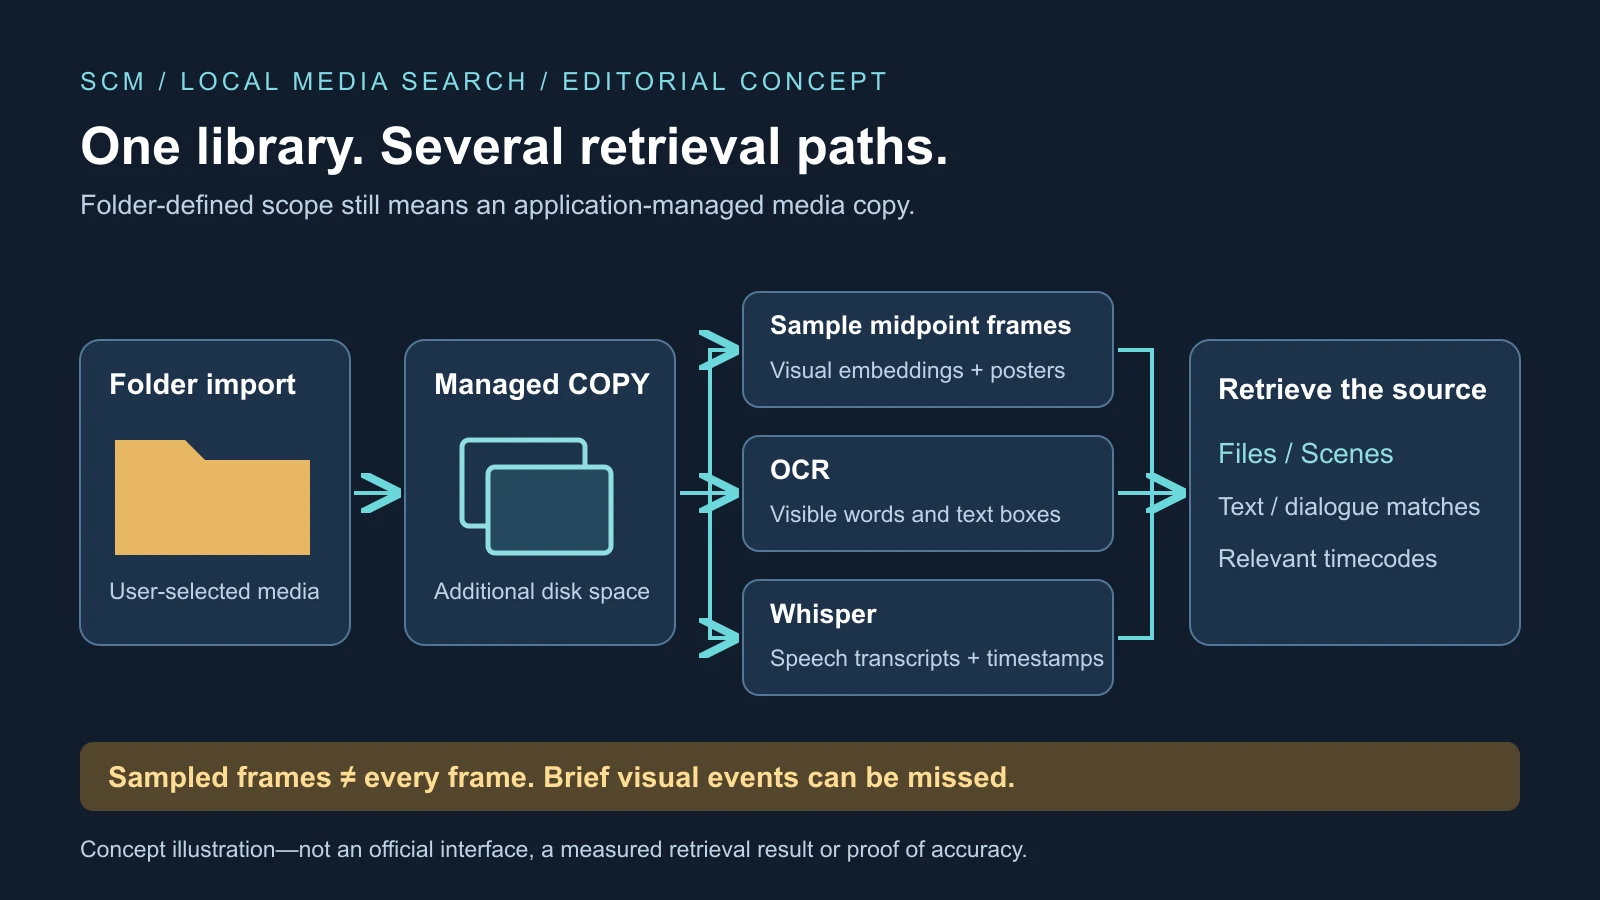
SCM 与 Apple Photos 竞争的切入点,并不是首次宣称照片可以用日常语言搜索。Apple 已有这项能力。这款开源 Mac 应用将视觉、场景、文字与语音检索组合起来,处理用户从文件夹选入的媒体,包括项目导出文件和外置硬盘归档。它的亮相让整套检索流程可以接受检查,但不能证明准确性或普及程度:早期 Hacker News 快照只有四个积分,没有评论。
如果把它想象成覆盖现有磁盘的轻量索引,就会忽略一个重要条件:SCM 会把导入的媒体复制到自管资料库。它虽承诺寻找视频各处的时刻,文档描述的视觉流程却是抽取代表帧,而非逐一独立分析所有解码帧。这两项选择直接决定软件的能力与运行成本。
多种检索,而非一个无所不知的模型
SCM 仓库介绍了 Files、Scenes、OCR、Dialogue 模式,以及可选的本地问答模型。Files 按视觉语义返回完整照片或视频,Scenes 返回带时间码的片段;OCR 搜索可见文字,Dialogue 通过 Whisper 转录定位特定时间的精确词语。可选的 Ask 层使用已经提取的文本,并非独立理解原始媒体中的一切。
这些路径相互补充。纪录片剪辑师可能记得采访中的一句话、补充镜头里的红车,或者扫描授权书上的邮箱。转录检索、视觉嵌入与 OCR 分别解决其中不同部分。“红车旁的一只狗”这样的视觉关联,并不保证能识别细小序列号;语音识别转错的短语,也无法靠转录检索找回。
SCM 通过结果解释呈现部分差异。文件徽标区分视觉匹配和文件名匹配,对话结果显示命中的转录片段,评分与提示则让结果的来源更清楚。这些功能有助诊断错误,并不证明排序正确。用户可以把转录失败与视觉查询无果分开判断,而不必把所有遗漏都视为同一种神秘的 AI 错误。
已保存的搜索标签页会保留查询与模式,便于在监控文件夹变化后再次查看。截图视图综合文件名、元数据、文件夹上下文及手动修正,而非只看画面。专门的邮箱视图尝试重建被 OCR 拆到多个框中、或因标点误识而受损的地址。这些细节把检索拓展到普通相册之外,却不能让 OCR 永不出错。
用户按文件夹定义范围,系统仍会另存一份
媒体可通过应用导入、拖放或监控文件夹进入系统。项目称监控文件夹会实时更新,并在 SCM 启动时重新扫描。复制前,软件计算 SHA-256 内容哈希,以便识别改名后的重复文件;它还检查实际媒体类型,而不只相信扩展名。缓存的场景规划也能在重新导入时避免部分重复处理。
副本存放在应用支持目录。因此,外置归档并非仅保留一个索引引用:原媒体与 SCM 自管副本同时存在,另外还有嵌入向量、缩略图、场景预览、转录、OCR 框和辅助文件。数 TB 素材与一个小截图文件夹,对存储的要求截然不同。嵌入版本快照还会增加占用,不过 SCM 将其上限设为十份。
项目介绍的发行版通过 Homebrew 面向运行 macOS 12 或更新系统的 Apple silicon Mac。应用以 Electron 打包,React 提供界面,独立工作进程分别处理视觉、OCR 和语音。MIT 许可证允许检查、修改代码以及构建和测试。但这并不证明未经审查的发行文件或依赖是安全的,也不证明单一维护者能持续跟上所有上游变化。
与 Photos 的比较同样需要准确。Apple 的 Photos 文档已介绍用自然语言搜索图像及视频关键时刻,并可按照片、视频、截图、收藏和关键词筛选。Photos 还整合人物、宠物、相簿、编辑、回忆与 iCloud。SCM 更聚焦的机会,是资料库之外由用户定义的制作文件夹、相机卡备份与客户归档,而不是已经证明它能取代大多数用户的 Photos。
场景搜索究竟抽取哪些画面
FFmpeg 首先检查镜头边界,然后 SCM 按选定密度规划片段。预设从每 60 秒一个搜索点到每 2.5 秒一个不等。默认均衡设置采用 30 秒间隔,标称片段预算为 8–128。每个规划片段会提取中点帧的嵌入,并保留预览图;文本查询也转成数值表示,以便与这些已存画面比较排序。
整文件视频检索采用另一种摘要:在视频的 20%、50% 和 80% 位置取帧,再对嵌入求平均。这可以反映整个文件的大致特征,却无法捕捉每个特殊场景。寻找某个记忆中的时刻应使用 Scenes。即便如此,一秒的标题卡、经过的车牌,或长镜头中短暂出现的人,也可能落在代表帧之间。
其计算原因不难理解。30 分钟、每秒 30 帧的视频共有 54,000 帧;全部建立索引会成倍增加处理量和索引体积,其中许多相邻画面又高度重复。提高采样密度能减少空隙,但要付出额外时间与存储。它不会把采样索引变成逐帧完整覆盖的保证。
SCM 使用噪声门限、按模型校准的阈值和近似重复过滤,并把每个视频的场景结果限制为三个。这能改善多样性、抑制弱匹配,也可能隐藏同一文件内多个正确时刻。相似颜色、构图或学习到的关联可能得到高排名,却没有识别出目标主体。把它称为场景地图,比承诺理解每一帧更准确。
模型选择同时改变速度与检索行为
默认视觉引擎为输入尺寸 336 像素的 CLIP ViT-L/14,模型下载约 435MB。OpenAI 的 CLIP 介绍解释了图文关联学习,使检索无需为每个概念手动打标签。SCM 还提供三种 SigLIP 变体。相关的 SigLIP 2 研究强调多语言理解、图文检索与定位,但这些研究特性本身不能证明模型在某个个人归档上的准确率。
项目报告的 CPU 推理速度,最快方案约为每图 50–100 毫秒,较慢方案约为 200 或 480 毫秒。这不是跨 Mac 的独立基准。切换模型会触发后台重建嵌入,期间 SCM 暂时回退到文件名搜索。因此,换模型并非在不变索引上免费切换相关性算法。
OCR 提供英语及另外 35 种语言开关,但语言包不能保证不同分辨率、对比度、字体和方向下都识别正确。Whisper 可能误听口音、重叠语音、噪声与专业词汇。视觉嵌入也可能继承社会或文化偏见;CLIP 模型卡要求针对目标领域充分测试。“紧张的会议”需要解释氛围,而判断谁批准了合同,可能需要像素中没有的知识。
因此,逐模式评估比混合成功率更有意义。事先确定目标时刻、在看到结果前写出查询,可以分别测量 Scenes、Files、OCR 和 Dialogue 的召回率、误匹配和出结果时间。SCM 含单元测试、Electron 冒烟测试与基准脚本,但软件回归检查不等于具有代表性的独立检索基准。
本地隐私并不消除信任问题
SCM 称无需账户、不收集遥测、不上传媒体。下载必要的视觉权重、OCR 数据和 Whisper 文件后,处理可在本地进行,视觉索引可离线运行。可选语言模型在用户启用前默认关闭,接收提取的对话、OCR 与文件名证据。其辅助服务使用回环接口,通常只允许同一台机器连接。
据项目介绍,Ask 会引用本地证据,并在证据为空时停止生成。这减少了无依据回答的一种来源,却不能排除所有错误:小型本地模型仍可能误述真实转录。引用是返回媒体核对的路径,并非核对的替代品。这类似围绕媒体建立的个人知识库,但检索与答案生成仍是不同的可靠性问题。
分发又引入一道信任边界。Homebrew 安装说明要求信任项目的 tap 或 cask,并影响 macOS 隔离机制的处理;这不等于 Mac App Store 审核。未签名本地构建可能触发警告。签名有助确认开发者身份及签名后代码未变,不证明代码本身安全。SHA-256 下载校验同样只能确认字节与预期一致,而非证明这些字节值得信任。
依赖链包含 Electron、FFmpeg、ONNX Runtime、Tesseract、Whisper、视觉模型及可选的 llama.cpp。开源代码允许开发者检查网络行为、替换组件,但多数用户不会审计整条链。恶意软件、共享账户、不安全备份或未锁定的 Mac,仍可能暴露本地资料库。隐私优势是减少强制云端暴露,不是免受设备入侵。
最后的考验是长期可用的资料库
后台控制与全局暂停承认,索引会与日常工作争夺算力、散热、电池和内存。即使单图推理很快,数十万样本仍需持续处理,OCR 和转录又有独立队列。内容哈希、缓存规划、快照和重试是有用基础,但中断导入、断开的磁盘、损坏索引与模型迁移,会在大规模使用中检验恢复能力。
SCM 进入的是已经存在本地 Mac 照片工具和专业视频工具的市场,而非空白领域。它有价值的组合是开源、文件夹自定义范围、本地处理与多模式检索。可复现发布、问题响应、安全报告、外部贡献及独立评估,会比星标数量或复杂聊天界面更重要。
先用一个可控且有代表性的文件夹,可以在复制整个归档前显露这些权衡。长视频、截图、可见文字、对话及外观相似文件会暴露不同失败;导入时间、额外磁盘占用和原媒体时间码则让结果可衡量。原文件与备份应放在自管副本之外。真正的承诺是反复找到正确来源、定位到正确时刻附近,而不是只在 Mac 上再加一个 AI 搜索框。