
L’ouverture de SCM face à Apple Photos n’est pas une nouvelle affirmation selon laquelle on peut chercher des images avec le langage courant. Apple le propose déjà. L’application Mac open source combine plutôt recherche visuelle, scènes, texte et parole dans des médias sélectionnés depuis des dossiers, notamment des exports de projets et des archives sur disques externes. Son lancement rend ce traitement vérifiable, mais ne démontre ni précision ni adoption : le premier instantané de Hacker News affichait quatre points et aucun commentaire.
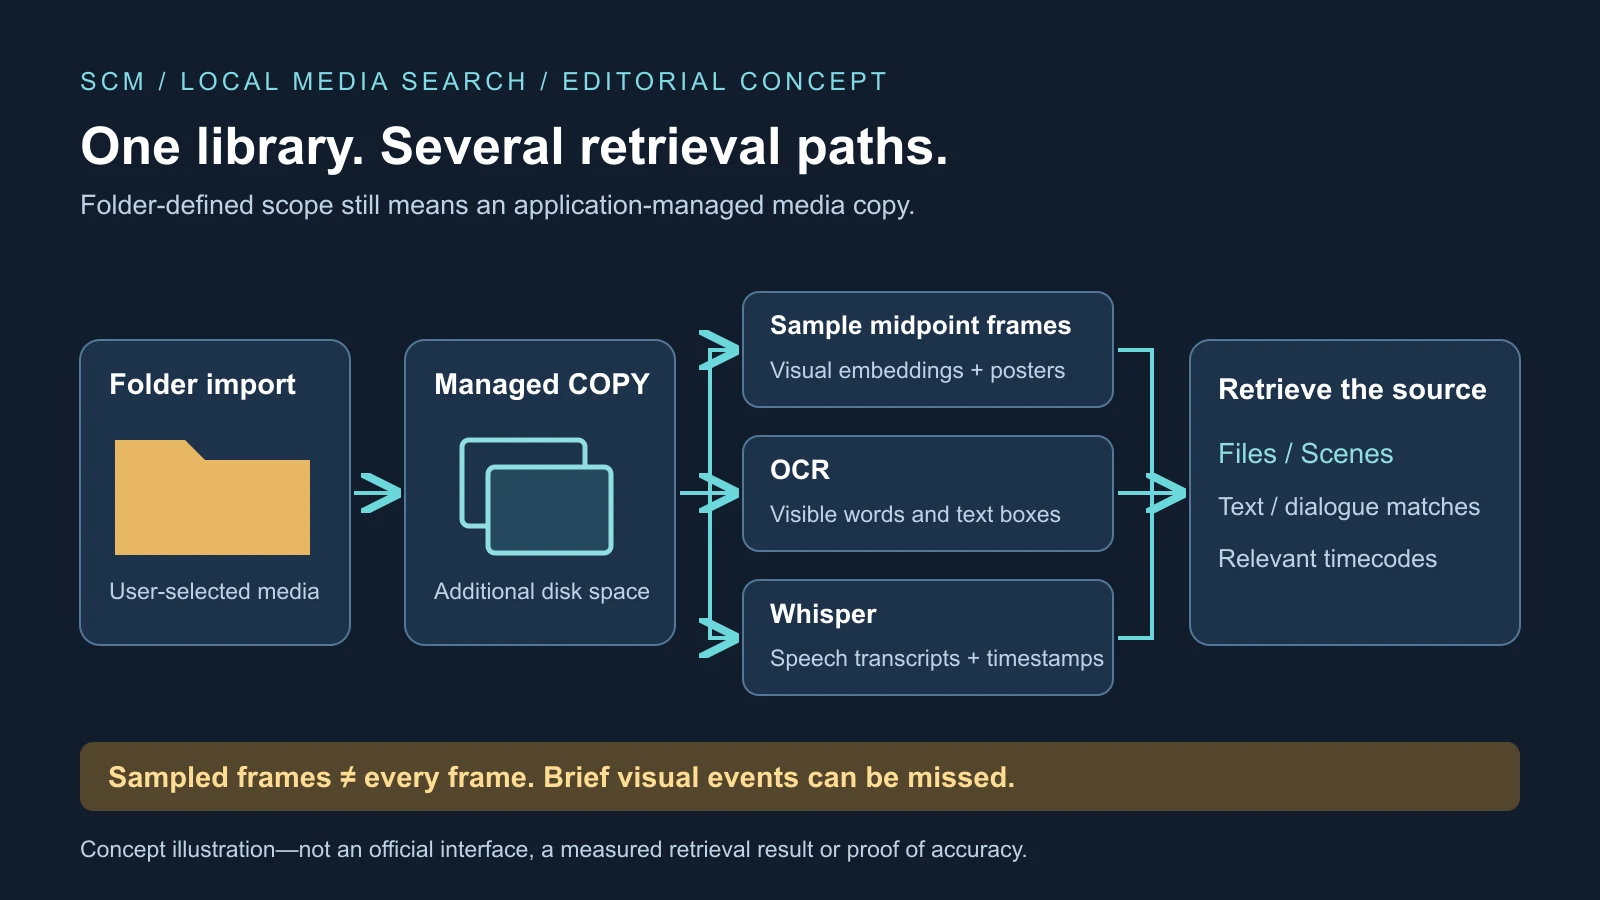
Une réserve attend quiconque imagine un index léger sur un disque existant. SCM copie les médias importés dans sa propre bibliothèque gérée. Et, même s’il promet de retrouver des moments tout au long des vidéos, sa chaîne visuelle documentée échantillonne des images représentatives au lieu d’analyser indépendamment chaque image décodée. Ces deux choix déterminent ses capacités et son coût de fonctionnement.
Plusieurs recherches, pas un modèle omniscient
Le dépôt SCM décrit Files, Scenes, OCR et Dialogue, plus un modèle local facultatif de questions-réponses. Files retrouve des photos ou vidéos entières par leur signification visuelle ; Scenes renvoie des moments avec timecodes. OCR recherche les mots visibles. Dialogue utilise des transcriptions Whisper pour localiser des mots exacts à des instants précis. La couche Ask facultative travaille à partir du texte déjà extrait plutôt que de comprendre indépendamment tout le contenu original.
Ces voies sont complémentaires. Un monteur de documentaire peut se souvenir d’une phrase d’entretien, d’une voiture rouge dans des plans de coupe ou d’une adresse électronique sur une autorisation numérisée. Transcriptions, représentations visuelles et OCR répondent à différentes parties du problème. Une association comme « chien à côté d’une voiture rouge » ne garantit pas la reconnaissance d’un minuscule numéro de série ; une transcription ne retrouve pas une phrase mal reconnue par le système vocal.
SCM expose une partie de cette séparation dans les explications des résultats. Des badges distinguent correspondances visuelles et noms de fichiers ; les résultats de dialogues montrent les extraits de transcription concordants. Scores et infobulles rendent le chemin vers le résultat plus visible. Ce sont des aides au diagnostic, pas des preuves de justesse du classement. L’utilisateur peut distinguer une mauvaise transcription d’une recherche visuelle infructueuse, sans traiter chaque omission comme la même mystérieuse erreur d’IA.
Les onglets de recherches enregistrées conservent requête et mode lorsque les dossiers surveillés évoluent. La vue des captures combine noms de fichiers, métadonnées, contexte des dossiers et corrections manuelles, pas seulement l’apparence. Une vue spécialisée d’adresses électroniques tente de reconstruire celles que l’OCR a séparées entre plusieurs cadres ou endommagées par des erreurs de ponctuation. Ces détails élargissent la recherche au-delà d’une galerie traditionnelle sans rendre l’OCR infaillible.
Des collections définies par dossiers créent quand même une copie
Les médias entrent par importation dans l’application, glisser-déposer ou dossiers surveillés. Le projet annonce des mises à jour en direct et une nouvelle analyse au démarrage. Avant la copie, il calcule un hachage de contenu SHA-256 pour reconnaître les doublons renommés et vérifie les véritables types de médias plutôt que les seules extensions. Les plans de scènes en cache peuvent aussi éviter une partie du travail lors d’une réimportation.
La copie est placée dans le répertoire de support de l’application. Une archive externe ne reste donc pas une simple référence indexée : originaux et copie SCM coexistent, avec représentations numériques, miniatures, aperçus de scènes, transcriptions, cadres OCR et fichiers auxiliaires. Plusieurs téraoctets de séquences constituent un engagement de stockage très différent d’une petite collection de captures. Les instantanés de versions des représentations ajoutent un coût, bien que SCM les limite à dix.
La distribution décrite cible les Mac Apple silicon sous macOS 12 ou ultérieur via Homebrew. Electron emballe l’application, React fournit l’interface et des processus distincts prennent en charge vision, OCR et parole. La licence MIT permet inspection et adaptation du code, des compilations et des tests. Cela ne prouve ni la sécurité d’une version ou dépendance non examinée, ni la capacité d’un seul mainteneur à suivre chaque évolution des composants en amont.
La comparaison avec Photos exige aussi de la précision. La documentation Apple Photos décrit déjà la recherche en langage naturel d’images et de moments clés de vidéos, avec filtres photos, vidéos, captures, favoris et mots-clés. Photos intègre personnes, animaux, albums, retouches, souvenirs et iCloud. L’opportunité plus ciblée de SCM est un corpus défini par l’utilisateur de dossiers de production, sauvegardes de cartes et archives clients hors de cette bibliothèque, pas la preuve qu’il remplacera Photos pour la majorité.
Ce que la recherche de scènes échantillonne réellement
FFmpeg examine d’abord les limites de plans ; SCM construit ensuite un plan de segments à la densité choisie. Les préréglages vont d’un point de recherche toutes les 60 secondes à un toutes les 2,5 secondes. Le réglage équilibré par défaut utilise des intervalles de 30 secondes et un budget annoncé de 8 à 128 segments. Pour chacun, le logiciel encode l’image centrale et conserve un aperçu. La requête textuelle devient une représentation numérique comparable aux images stockées.
La recherche sur un fichier vidéo entier utilise un autre résumé : des images à 20 %, 50 % et 80 % de la durée, dont les représentations sont moyennées. Cela peut rendre le caractère général du fichier, pas toutes ses scènes inhabituelles. Scenes est la voie adaptée à un moment mémorisé. Même là, un carton d’une seconde, une plaque qui passe ou une brève apparition dans un long plan sans coupe peuvent se trouver entre deux images représentatives.
La raison informatique est simple. Une vidéo de 30 minutes à 30 images par seconde contient 54 000 images ; toutes les indexer multiplierait calcul et taille de l’index en conservant beaucoup de redondance. Un échantillonnage plus dense réduit les trous au prix de temps et de stockage supplémentaires. Il ne transforme pas un index échantillonné en garantie de couverture complète image par image.
SCM applique un seuil de bruit, des seuils calibrés par modèle et un filtrage des quasi-doublons, et limite chaque vidéo à trois résultats de scènes. Cela peut favoriser la diversité et écarter les faibles correspondances, mais aussi cacher plusieurs moments valides d’un même fichier. Des couleurs, compositions ou associations apprises similaires peuvent être bien classées sans identifier le sujet demandé. Une carte des scènes est une description plus juste que la promesse d’avoir compris chaque image.
Les modèles changent vitesse et comportement
Le moteur par défaut est CLIP ViT-L/14 avec une entrée de 336 pixels et un téléchargement d’environ 435MB. La présentation CLIP d’OpenAI explique l’apprentissage d’associations image-texte permettant la recherche sans étiqueter manuellement chaque concept. SCM propose aussi trois variantes SigLIP. Les travaux SigLIP 2 soulignent compréhension multilingue, recherche image-texte et localisation ; ces propriétés ne suffisent pas à établir la précision sur une archive personnelle.
Les chiffres CPU rapportés par le projet vont d’environ 50–100 millisecondes par image pour l’option la plus rapide à environ 200 ou 480 millisecondes pour les plus lentes. Ce ne sont pas des benchmarks indépendants sur différents Mac. Changer de modèle déclenche un nouvel encodage en arrière-plan, pendant lequel SCM revient temporairement aux noms de fichiers. Ce n’est donc pas un changement gratuit de pertinence sur un index inchangé.
L’OCR comprend l’anglais et 35 options linguistiques supplémentaires, mais les packs ne garantissent pas la reconnaissance pour toutes les résolutions, tous les contrastes, toutes les polices et orientations. Whisper peut mal entendre accents, voix superposées, bruit et vocabulaire spécialisé. Les représentations visuelles peuvent hériter de biais sociaux ou culturels ; la fiche CLIP exige des essais approfondis dans le domaine visé. « Une réunion tendue » requiert une interprétation, tandis qu’identifier qui a approuvé un contrat peut demander des connaissances absentes des pixels.
Ces limites rendent l’évaluation par mode plus instructive qu’un taux de réussite agrégé. Des moments cibles connus et des requêtes écrites avant de voir les résultats peuvent révéler rappel, fausses correspondances et temps de réponse séparément pour Scenes, Files, OCR et Dialogue. SCM inclut tests unitaires, tests smoke Electron et scripts de benchmark, mais les contrôles de régression logicielle ne sont pas un benchmark indépendant représentatif de recherche.
La confidentialité locale ne supprime pas la confiance
SCM affirme n’avoir ni comptes, ni télémétrie, ni envoi de médias. Une fois téléchargés les poids visuels, données OCR et fichiers Whisper nécessaires, le traitement peut être local et l’indexation visuelle fonctionner hors ligne. Le modèle de langage facultatif reste désactivé jusqu’à son activation ; il reçoit dialogues, OCR et indices de noms de fichiers extraits. Son service auxiliaire utilise l’interface loopback, qui limite normalement les connexions à la même machine.
Selon le projet, Ask cite les preuves locales et s’arrête avant génération si elles sont absentes. Cela réduit une voie vers les réponses sans fondement, pas toutes les erreurs : un petit modèle local peut encore mal résumer une véritable transcription. Les citations ramènent au média, elles ne remplacent pas la vérification. Cela ressemble à une base de connaissances personnelle centrée sur les médias, mais recherche et génération restent des problèmes de fiabilité distincts.
La distribution crée une autre frontière de confiance. Les instructions Homebrew demandent de faire confiance au tap ou cask du projet et influencent la quarantaine macOS ; elles n’équivalent pas à la validation du Mac App Store. Des compilations locales non signées peuvent déclencher des avertissements. La signature identifie un développeur et aide à confirmer que le code n’a pas changé depuis, pas sa sécurité intrinsèque. SHA-256 vérifie également les octets attendus, pas leur fiabilité.
La chaîne de dépendances comprend Electron, FFmpeg, ONNX Runtime, Tesseract, Whisper, modèles visuels et llama.cpp facultatif. Le code ouvert permet d’examiner le comportement réseau et de remplacer des composants, mais la majorité n’auditera pas toute la chaîne. Logiciels malveillants, comptes partagés, sauvegardes non sécurisées et Mac déverrouillé peuvent encore exposer la bibliothèque locale. L’avantage est une moindre exposition obligatoire au cloud, pas une immunité à la compromission de l’appareil.
Le test restant est celui d’une bibliothèque durable
Les contrôles d’arrière-plan et la pause globale reconnaissent que l’indexation concurrence travail ordinaire, dissipation thermique, batterie et mémoire. Même une inférence rapide devient un travail soutenu sur des centaines de milliers d’échantillons, avec des files OCR et transcription distinctes. Hachages, plans en cache, instantanés et nouvelles tentatives sont des bases utiles, mais importations interrompues, disques débranchés, index endommagés et migrations de modèles éprouveront la récupération à grande échelle.
SCM entre dans une catégorie existante d’outils photo locaux sur Mac et de vidéo professionnelle, pas dans un marché vide. Sa combinaison utile associe code ouvert, périmètre par dossiers, traitement local et plusieurs modes. Versions reproductibles, réponse aux problèmes, signalements de sécurité, contributions externes et évaluations indépendantes compteront davantage que les étoiles ou un chat élaboré.
Un dossier représentatif et contrôlé peut révéler ces compromis avant de copier une archive entière. Longues vidéos, captures, texte visible, dialogues et fichiers ressemblants exposent des échecs différents ; durée d’importation, espace ajouté et horodatages originaux les rendent mesurables. Originaux et sauvegardes devraient rester hors de la copie gérée. La promesse substantielle est de retrouver régulièrement la bonne source près du bon moment, pas simplement d’ajouter un champ de recherche IA au Mac.