
SCMs Ansatz gegen Apple Photos besteht nicht in der neuen Behauptung, Bilder ließen sich mit Alltagssprache durchsuchen. Apple bietet das bereits an. Die quelloffene Mac-Anwendung kombiniert vielmehr Bild-, Szenen-, Text- und Sprachsuche für Medien aus ausgewählten Ordnern, einschließlich Projektexporten und Archiven auf externen Laufwerken. Ihr Debüt macht die Verarbeitung überprüfbar, belegt aber weder Genauigkeit noch Verbreitung: Der frühe Hacker-News-Schnappschuss zeigte vier Punkte und keine Kommentare.
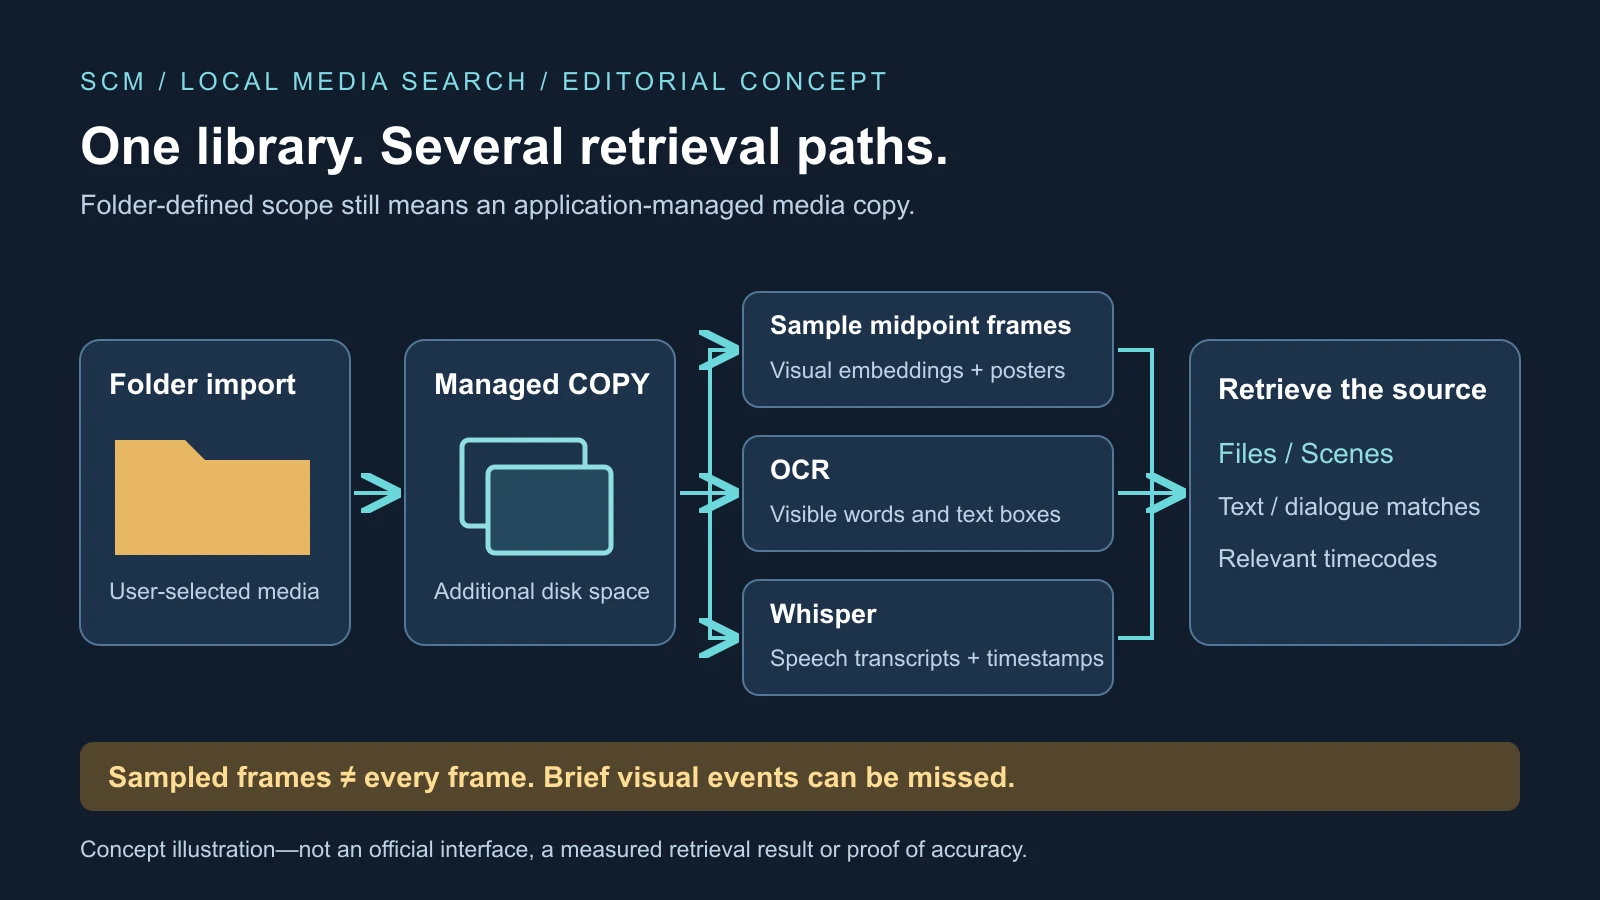
Wer sich einen schlanken Index über eine vorhandene Festplatte vorstellt, übersieht einen Haken. SCM kopiert importierte Medien in eine eigene verwaltete Bibliothek. Und obwohl es Momente im gesamten Video finden will, verwendet die dokumentierte Bildpipeline repräsentative Einzelbilder statt jedes dekodierte Bild unabhängig zu analysieren. Beide Entscheidungen bestimmen Leistung und Betriebskosten.
Mehrere Suchwege statt eines allwissenden Modells
Das SCM-Repository beschreibt Files, Scenes, OCR und Dialogue sowie ein optionales lokales Frage-Antwort-Modell. Files findet ganze Fotos oder Videos nach visueller Bedeutung; Scenes liefert Momente mit Zeitcodes. OCR sucht sichtbare Wörter. Dialogue nutzt Whisper-Transkripte, um genaue Wörter an Zeitstempeln zu finden. Die optionale Ask-Schicht arbeitet mit bereits extrahiertem Text und versteht nicht eigenständig alles im Originalmedium.
Diese Wege ergänzen sich. Ein Dokumentarfilm-Editor erinnert sich vielleicht an einen Interviewsatz, ein rotes Auto im B-Roll-Material oder eine E-Mail-Adresse auf einer eingescannten Freigabe. Transkriptsuche, visuelle Embeddings und OCR bearbeiten verschiedene Teile dieser Aufgabe. Die visuelle Assoziation „Hund neben einem roten Auto“ garantiert keine winzige Seriennummernerkennung; ein Transkript kann keine Phrase zurückholen, die die Spracherkennung falsch erfasst hat.
SCM zeigt einen Teil dieser Trennung in den Ergebnisbegründungen. Datei-Badges unterscheiden Bild- und Dateinamentreffer; Dialogergebnisse zeigen passende Transkriptausschnitte. Werte und Tooltips machen den Weg zum Ergebnis sichtbarer. Das hilft bei der Fehlerdiagnose, ist aber kein Beleg für eine korrekte Rangfolge. Nutzer können eine fehlerhafte Transkription von einer erfolglosen Bildabfrage unterscheiden, statt jeden Fehlschlag als denselben rätselhaften KI-Fehler zu behandeln.
Gespeicherte Such-Tabs behalten Abfrage und Modus bei, während sich überwachte Ordner ändern. Die Screenshot-Ansicht kombiniert Dateinamen, Metadaten, Ordnerkontext und manuelle Korrekturen statt nur das Aussehen. Eine spezielle E-Mail-Ansicht versucht Adressen wiederherzustellen, die OCR über Kästen verteilt oder durch Satzzeichenfehler beschädigt hat. Solche Details erweitern die Suche über eine herkömmliche Fotogalerie hinaus, machen OCR jedoch nicht unfehlbar.
Auch eine ordnerdefinierte Sammlung erzeugt eine zweite Kopie
Medien gelangen per Anwendungsimport, Drag-and-drop oder überwachten Ordnern hinein. Laut Projekt werden überwachte Ordner laufend aktualisiert und beim Start erneut gescannt. Vor dem Kopieren berechnet SCM einen SHA-256-Inhaltshash, um umbenannte Duplikate zu erkennen, und prüft tatsächliche Medientypen statt nur Erweiterungen. Zwischengespeicherte Szenenpläne können bei erneutem Import ebenfalls Arbeit sparen.
Die Kopie liegt im Support-Verzeichnis der Anwendung. Ein externes Archiv bleibt damit keine reine Indexreferenz: Originalmedien und SCM-Kopie bestehen nebeneinander, ergänzt um Embeddings, Vorschaubilder, Szenenposter, Transkripte, OCR-Kästen und Begleitdateien. Mehrere Terabyte Filmmaterial bedeuten einen ganz anderen Speicherbedarf als eine kleine Screenshot-Sammlung. Versions-Snapshots der Embeddings kosten zusätzlich Platz, sind allerdings auf zehn begrenzt.
Die beschriebene Distribution richtet sich per Homebrew an Apple-Silicon-Macs ab macOS 12. Electron verpackt die Anwendung, React stellt die Oberfläche bereit und getrennte Worker übernehmen Bildanalyse, OCR und Sprache. Die MIT-Lizenz erlaubt Prüfung und Anpassung von Code, Builds und Tests. Das beweist weder die Sicherheit eines ungeprüften Releases oder einer Abhängigkeit noch die Fähigkeit eines einzelnen Maintainers, jede Änderung vorgelagerter Komponenten dauerhaft zu bewältigen.
Auch der Vergleich mit Photos braucht Präzision. Apples Photos-Dokumentation beschreibt bereits natürlichsprachliche Bild- und Videomomentsuche mit Filtern für Fotos, Videos, Screenshots, Favoriten und Schlüsselwörter. Photos integriert Personen, Haustiere, Alben, Bearbeitungen, Rückblicke und iCloud. SCMs engere Chance liegt in einem selbst definierten Bestand aus Produktionsordnern, Speicherkartensicherungen und Kundenarchiven außerhalb dieser Mediathek, nicht im Nachweis, Photos für die meisten Nutzer zu ersetzen.
Welche Bilder die Szenensuche tatsächlich auswählt
Zunächst untersucht FFmpeg Schnittgrenzen; anschließend erstellt SCM einen Segmentplan mit gewählter Dichte. Die Voreinstellungen reichen von einem Suchpunkt alle 60 Sekunden bis zu einem alle 2,5 Sekunden. Die ausgewogene Standardeinstellung nutzt 30-Sekunden-Abstände bei einem angegebenen Budget von 8–128 Segmenten. Für jedes Segment wird das mittlere Bild eingebettet und ein Poster gespeichert. Eine Textabfrage wird numerisch dargestellt und mit den gespeicherten Bildern verglichen.
Die Suche nach ganzen Videodateien nutzt eine andere Zusammenfassung: Bilder bei 20%, 50% und 80% der Laufzeit, deren Embeddings gemittelt werden. Das kann den Gesamtcharakter wiedergeben, aber nicht jede ungewöhnliche Szene. Scenes ist der passende Weg für einen erinnerten Moment. Doch auch dort können eine einsekündige Titelkarte, ein vorbeifahrendes Kennzeichen oder ein kurzer Auftritt in einer langen ungeschnittenen Einstellung zwischen die repräsentativen Bilder fallen.
Der Rechengrund ist leicht nachvollziehbar. Ein 30-minütiges Video mit 30 Bildern pro Sekunde enthält 54.000 Bilder. Alle zu indexieren würde Rechenaufwand und Indexgröße vervielfachen und viel redundantes Material bewahren. Dichteres Sampling verkleinert Lücken, kostet aber Zeit und Speicher. Es verwandelt einen Stichprobenindex nicht in eine Garantie vollständiger Einzelbildabdeckung.
SCM verwendet eine Rauschschwelle, modellspezifisch kalibrierte Grenzwerte und einen Filter für nahezu identische Treffer; pro Video werden höchstens drei Szenenergebnisse angezeigt. Das kann Vielfalt fördern und schwache Treffer unterdrücken, aber auch mehrere richtige Momente derselben Datei verbergen. Ähnliche Farben, Kompositionen oder gelernte Assoziationen können hoch rangieren, ohne das gesuchte Motiv zu identifizieren. Eine Szenenkarte ist genauer als das Versprechen, jedes Bild verstanden zu haben.
Modelle verändern Geschwindigkeit und Suchverhalten
Die Standard-Bildengine ist CLIP ViT-L/14 mit 336 Pixeln Eingabegröße und ungefähr 435MB Download. OpenAIs CLIP-Überblick erklärt das Lernen von Bild-Text-Beziehungen, das Suche ohne manuelle Kennzeichnung jedes Konzepts ermöglicht. SCM bietet außerdem drei SigLIP-Varianten. Die dazugehörige SigLIP-2-Forschung betont mehrsprachiges Verständnis, Bild-Text-Suche und Lokalisierung; diese Forschungseigenschaften beweisen allein keine Genauigkeit im persönlichen Archiv.
Die vom Projekt genannten CPU-Inferenzzeiten reichen von ungefähr 50–100 Millisekunden je Bild bei der schnellsten Option bis zu etwa 200 oder 480 Millisekunden bei langsameren Modellen. Es handelt sich nicht um unabhängige Mac-übergreifende Benchmarks. Ein Modellwechsel löst Hintergrund-Neueinbettung aus; SCM fällt zwischenzeitlich auf Dateinamensuche zurück. Es ist also kein kostenloser Relevanzschalter über einem unveränderten Index.
OCR bietet Englisch und 35 zusätzliche Sprachschalter. Sprachpakete garantieren jedoch keine Erkennung bei unterschiedlichen Auflösungen, Kontrasten, Schriften und Ausrichtungen. Whisper kann Akzente, überlappende Stimmen, Geräusche und Fachbegriffe falsch hören. Visuelle Embeddings können soziale oder kulturelle Verzerrungen übernehmen; die CLIP-Modellkarte fordert gründliche domänenspezifische Tests. Ein „angespanntes Treffen“ erfordert Interpretation, während die Identifikation des Vertragsgenehmigers Wissen außerhalb der Pixel verlangen kann.
Deshalb ist eine Bewertung je Modus aufschlussreicher als eine vermischte Erfolgsquote. Bekannte Zielmomente und vor Sichtung der Ergebnisse formulierte Abfragen können Recall, Fehlertreffer und Ergebniszeit getrennt für Scenes, Files, OCR und Dialogue zeigen. SCM enthält Unit-Tests, Electron-Smoke-Tests und Benchmark-Skripte, doch Software-Regressionsprüfungen ersetzen keinen repräsentativen unabhängigen Suchbenchmark.
Lokaler Datenschutz beseitigt Vertrauen nicht
SCM erklärt, weder Konten noch Telemetrie oder Medienuploads zu verwenden. Sobald benötigte Bildgewichte, OCR-Daten und Whisper-Dateien geladen sind, kann lokal verarbeitet werden; die Bildindexierung funktioniert offline. Das optionale Sprachmodell bleibt bis zur Aktivierung ausgeschaltet und erhält extrahierte Dialog-, OCR- und Dateinamenbelege. Sein Sidecar verwendet die Loopback-Schnittstelle, die gewöhnlich Verbindungen auf denselben Rechner begrenzt.
Ask soll lokale Belege zitieren und bei leerer Evidenz vor der Generierung stoppen. Das reduziert einen Weg zu unbelegten Antworten, nicht sämtliche Fehler: Auch ein kleines lokales Modell kann ein echtes Transkript falsch zusammenfassen. Zitate führen zurück zum Medium und ersetzen keine Prüfung. Das ähnelt einer medienzentrierten persönlichen Wissensbasis, doch Suche und Antwortgenerierung bleiben unterschiedliche Zuverlässigkeitsprobleme.
Die Verteilung schafft eine weitere Vertrauensgrenze. Homebrew-Anweisungen verlangen Vertrauen in Tap oder Cask des Projekts und beeinflussen die macOS-Quarantäne; sie entsprechen keiner Mac-App-Store-Prüfung. Unsigned lokale Builds können Warnungen auslösen. Signierung identifiziert einen Entwickler und hilft unveränderten signierten Code zu bestätigen, beweist aber keine grundsätzliche Sicherheit. SHA-256-Prüfungen bestätigen ebenfalls erwartete Bytes, nicht deren Vertrauenswürdigkeit.
Zur Abhängigkeitskette gehören Electron, FFmpeg, ONNX Runtime, Tesseract, Whisper, Bildmodelle und optional llama.cpp. Offener Code erlaubt Entwicklern Netzwerkprüfungen und Komponentenaustausch, doch die meisten Nutzer auditieren nicht die gesamte Kette. Malware, geteilte Konten, unsichere Sicherungen und ein entsperrter Mac können eine lokale Bibliothek weiterhin offenlegen. Der Datenschutzgewinn ist weniger verpflichtende Cloud-Exposition, keine Immunität gegen Gerätekompromittierung.
Die verbleibende Prüfung ist eine dauerhafte Bibliothek
Hintergrundsteuerung und globale Pause erkennen an, dass Indexierung mit normaler Arbeit, Wärmebudget, Akku und Speicher konkurriert. Selbst schnelle Einzelbild-Inferenz bedeutet bei Hunderttausenden Samples dauerhafte Arbeit, zusätzlich zu separaten OCR- und Transkriptionswarteschlangen. Inhaltshashes, gecachte Pläne, Snapshots und Wiederholungen sind Grundlagen; unterbrochene Importe, getrennte Laufwerke, beschädigte Indizes und Modellmigrationen prüfen jedoch die Wiederherstellung im großen Maßstab.
SCM betritt eine bestehende Kategorie lokaler Mac-Foto- und professioneller Videowerkzeuge, keinen leeren Markt. Seine nützliche Kombination besteht aus offenem Code, ordnerdefiniertem Umfang, lokaler Verarbeitung und mehreren Suchmodi. Reproduzierbare Releases, Reaktion auf Probleme, Sicherheitsberichte, externe Beiträge und unabhängige Bewertungen werden wichtiger sein als Sterne oder eine aufwendige Chat-Oberfläche.
Ein kontrollierter repräsentativer Ordner kann die Zielkonflikte zeigen, bevor ein ganzes Archiv kopiert wird. Lange Videos, Screenshots, sichtbarer Text, Dialog und ähnlich aussehende Dateien zeigen verschiedene Fehler; Importzeit, zusätzlicher Speicher und Quellzeitstempel machen sie messbar. Originale und Sicherungen sollten außerhalb der verwalteten Kopie bleiben. Das substanzielle Versprechen ist, wiederholt die richtige Quelle nahe dem richtigen Moment zu finden – nicht bloß ein weiteres KI-Suchfeld auf dem Mac.