
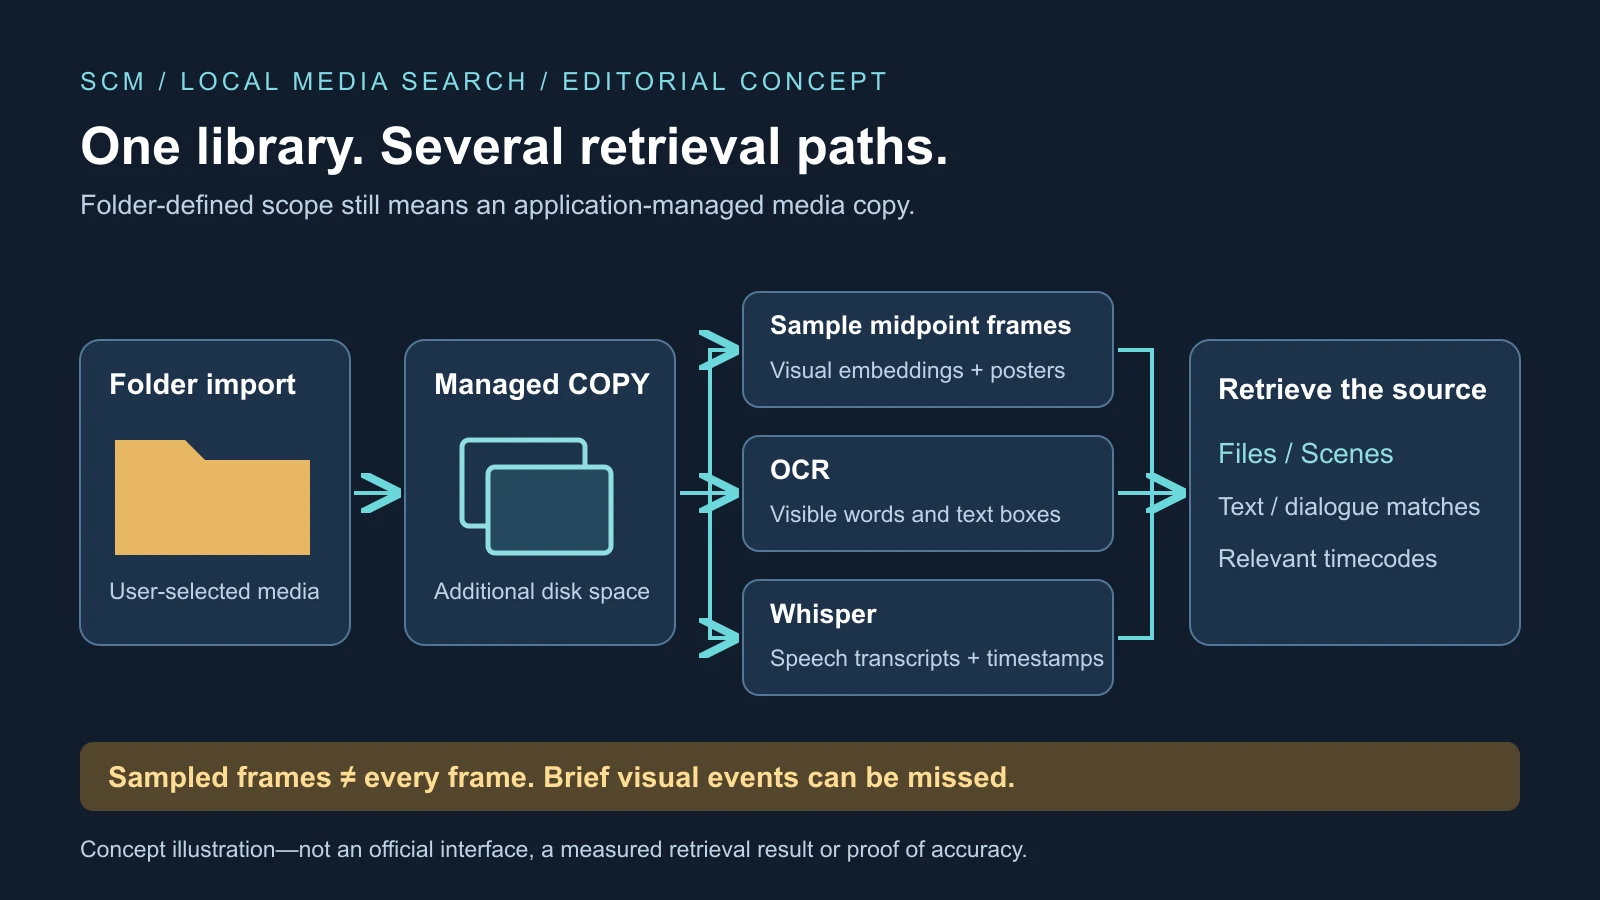
L’opportunità di SCM nei confronti di Apple Photos non è una nuova affermazione secondo cui le immagini si possono cercare con il linguaggio quotidiano. Apple lo offre già. L’applicazione open source per Mac combina invece ricerca visiva, di scene, testo e parlato sui contenuti selezionati dalle cartelle, comprese esportazioni di progetti e archivi su dischi esterni. Il debutto rende il processo ispezionabile, ma non ne dimostra precisione o adozione: la prima istantanea di Hacker News mostrava quattro punti e nessun commento.
C’è una precisazione per chi immagina un indice leggero su un disco esistente. SCM copia i contenuti importati nella propria libreria gestita. E, pur promettendo di trovare momenti lungo i video, la pipeline visiva documentata campiona fotogrammi rappresentativi anziché analizzare indipendentemente ogni fotogramma decodificato. Entrambe le scelte determinano possibilità e costi di funzionamento.
Più ricerche, non un modello onnisciente
Il repository SCM descrive Files, Scenes, OCR e Dialogue, oltre a un modello locale opzionale di domande e risposte. Files recupera intere foto o video per significato visivo; Scenes restituisce momenti con timecode. OCR cerca parole visibili. Dialogue utilizza trascrizioni Whisper per trovare parole esatte a timestamp precisi. Il livello opzionale Ask lavora sul testo già estratto, invece di comprendere autonomamente tutto il materiale originale.
Questi percorsi si completano. Un montatore di documentari potrebbe ricordare una frase di un’intervista, un’auto rossa nel B-roll o un indirizzo email su una liberatoria scansionata. Trascrizioni, embedding visivi e OCR rispondono a parti diverse del problema. Un’associazione come “cane accanto a un’auto rossa” non garantisce la lettura di un minuscolo numero di serie; una trascrizione non recupera una frase riconosciuta male dal sistema vocale.
SCM rende visibile parte di questa separazione nelle spiegazioni dei risultati. I badge distinguono corrispondenze visive e nomi file; i risultati dei dialoghi mostrano estratti coincidenti della trascrizione. Punteggi e tooltip chiariscono il percorso del risultato. Sono strumenti diagnostici, non prove che la graduatoria sia corretta. L’utente può distinguere una trascrizione sbagliata da una ricerca visiva senza esito, senza attribuire ogni omissione allo stesso misterioso errore dell’IA.
Le schede delle ricerche salvate conservano query e modalità mentre cambiano le cartelle monitorate. La vista screenshot combina nomi file, metadati, contesto delle cartelle e correzioni manuali, non soltanto l’aspetto. Una vista email specializzata tenta di ricostruire indirizzi divisi tra riquadri OCR o alterati da errori di punteggiatura. Questi dettagli ampliano il recupero oltre una galleria tradizionale, ma non rendono infallibile l’OCR.
Le raccolte definite dalle cartelle creano comunque un’altra copia
I contenuti entrano tramite importazione nell’app, trascinamento o cartelle monitorate. Il progetto dichiara aggiornamenti in tempo reale e nuove scansioni all’avvio. Prima di copiare, calcola un hash SHA-256 del contenuto per riconoscere duplicati rinominati e controlla il vero tipo multimediale anziché fidarsi dell’estensione. Anche i piani delle scene in cache possono evitare parte del lavoro ripetuto durante la reimportazione.
La copia finisce nella directory di supporto dell’applicazione. Un archivio esterno non resta quindi un semplice riferimento indicizzato: originali e copia SCM coesistono, insieme a embedding, miniature, anteprime delle scene, trascrizioni, riquadri OCR e file ausiliari. Diversi terabyte di filmati implicano un impegno di spazio molto diverso da una piccola raccolta di screenshot. Gli snapshot delle versioni degli embedding aggiungono costi, sebbene SCM li limiti a dieci.
La distribuzione descritta dal progetto si rivolge ai Mac Apple silicon con macOS 12 o successivo tramite Homebrew. Electron confeziona l’app, React fornisce l’interfaccia e worker separati gestiscono visione, OCR e voce. La licenza MIT consente ispezione e adattamento di codice, build e test. Ciò non dimostra che un rilascio o una dipendenza non esaminati siano sicuri, né che un solo manutentore possa sostenere ogni cambiamento dei componenti a monte.
Anche il confronto con Photos richiede precisione. La documentazione Apple Photos descrive già ricerca in linguaggio naturale di immagini e momenti chiave dei video, con filtri per foto, video, screenshot, preferiti e parole chiave. Photos integra persone, animali, album, modifiche, ricordi e iCloud. L’opportunità più circoscritta di SCM è un corpus definito dall’utente di cartelle di produzione, backup di schede e archivi clienti fuori da quella libreria, non la prova che sostituirà Photos per la maggioranza.
Che cosa campiona davvero la ricerca delle scene
FFmpeg analizza prima i confini delle inquadrature; SCM costruisce poi un piano di segmenti alla densità scelta. I preset vanno da un punto di ricerca ogni 60 secondi a uno ogni 2,5 secondi. L’impostazione bilanciata predefinita usa intervalli di 30 secondi con un budget dichiarato di 8–128 segmenti. Per ogni segmento viene creato l’embedding del fotogramma centrale e conservata un’anteprima. La query testuale diventa una rappresentazione numerica confrontabile con i fotogrammi memorizzati.
La ricerca dell’intero file video usa una sintesi diversa: fotogrammi al 20%, 50% e 80% della durata, con embedding mediati. Questo può rappresentare il carattere generale del file, ma non ogni scena insolita. Scenes è il percorso pertinente per un momento ricordato. Anche lì, un cartello di un secondo, una targa di passaggio o una breve apparizione in una lunga ripresa senza tagli possono cadere tra fotogrammi rappresentativi.
La ragione computazionale è evidente. Un video di 30 minuti a 30 fotogrammi al secondo contiene 54.000 fotogrammi; indicizzarli tutti moltiplicherebbe elaborazione e dimensioni dell’indice conservando molta ridondanza. Un campionamento più fitto riduce le lacune a costo di tempo e spazio aggiuntivi. Non trasforma un indice campionato in una garanzia di copertura completa fotogramma per fotogramma.
SCM applica un filtro del rumore, soglie calibrate per modello e filtri dei quasi duplicati, limitando ogni video a tre risultati di scena. Può favorire diversità e sopprimere corrispondenze deboli, ma anche nascondere diversi momenti validi nello stesso file. Colori, composizioni o associazioni apprese possono ottenere punteggi elevati senza identificare il soggetto richiesto. Una mappa delle scene è una descrizione più precisa della promessa di aver compreso ogni fotogramma.
I modelli cambiano velocità e comportamento
Il motore predefinito è CLIP ViT-L/14 con ingresso di 336 pixel e download di circa 435MB. La panoramica CLIP di OpenAI spiega l’apprendimento di associazioni tra immagini e testo che abilita il recupero senza etichettare ogni concetto a mano. SCM offre anche tre varianti SigLIP. La relativa ricerca SigLIP 2 sottolinea comprensione multilingue, recupero immagine-testo e localizzazione; queste proprietà non stabiliscono da sole la precisione su un archivio personale.
I tempi CPU dichiarati dal progetto vanno da circa 50–100 millisecondi per immagine per l’opzione più rapida a circa 200 o 480 millisecondi per quelle più lente. Non sono benchmark indipendenti su diversi Mac. Cambiare modello attiva la rigenerazione degli embedding in background, durante la quale SCM ripiega temporaneamente sui nomi file. Non è dunque un cambio gratuito di rilevanza su un indice invariato.
OCR comprende l’inglese e altre 35 opzioni linguistiche, ma i pacchetti non garantiscono il riconoscimento con ogni risoluzione, contrasto, carattere o orientamento. Whisper può fraintendere accenti, voci sovrapposte, rumore e termini specialistici. Gli embedding visivi possono ereditare bias sociali o culturali; la scheda CLIP richiede test approfonditi nel dominio d’uso. “Una riunione tesa” richiede interpretazione, mentre sapere chi ha approvato un contratto può richiedere informazioni assenti dai pixel.
Queste limitazioni rendono la valutazione per modalità più informativa di un tasso di successo aggregato. Momenti obiettivo noti e query scritte prima di vedere i risultati possono rivelare richiamo, falsi abbinamenti e tempo al risultato separatamente per Scenes, Files, OCR e Dialogue. SCM include test unitari, smoke test Electron e script di benchmark, ma i controlli di regressione software non sono un benchmark indipendente e rappresentativo del recupero.
La privacy locale non elimina la fiducia
SCM dichiara assenza di account, telemetria e caricamento di contenuti. Dopo aver scaricato pesi visivi, dati OCR e file Whisper necessari, l’elaborazione può avvenire localmente e l’indicizzazione visiva può funzionare offline. Il modello linguistico opzionale resta spento fino all’attivazione e riceve dialoghi, OCR e informazioni dai nomi file estratti. Il suo processo ausiliario usa l’interfaccia loopback, che normalmente limita le connessioni alla stessa macchina.
Secondo il progetto, Ask cita le prove locali e si ferma prima di generare se non trova prove. Riduce una via alle risposte non supportate, non tutti gli errori: un piccolo modello locale può comunque riassumere male una trascrizione reale. Le citazioni sono una strada verso il contenuto originale, non sostituiscono la verifica. L’idea ricorda una base di conoscenza personale multimediale, ma recupero e generazione restano problemi distinti di affidabilità.
La distribuzione aggiunge un altro confine di fiducia. Le istruzioni Homebrew richiedono fiducia nel tap o cask del progetto e influenzano la gestione della quarantena macOS; non equivalgono alla revisione del Mac App Store. Build locali non firmate possono causare avvisi. La firma identifica lo sviluppatore e aiuta a verificare che il codice non sia cambiato dalla firma, ma non dimostra sicurezza intrinseca. Anche SHA-256 conferma i byte previsti, non la loro affidabilità.
La catena delle dipendenze comprende Electron, FFmpeg, ONNX Runtime, Tesseract, Whisper, modelli visivi e llama.cpp opzionale. Il codice aperto permette di esaminare il comportamento di rete e sostituire componenti, ma la maggioranza non verificherà l’intera catena. Malware, account condivisi, backup insicuri e un Mac sbloccato possono ancora esporre la libreria locale. Il vantaggio è una minore esposizione obbligatoria al cloud, non l’immunità dalla compromissione del dispositivo.
Il test ancora aperto è una libreria duratura
Controlli in background e pausa globale riconoscono che l’indicizzazione compete con lavoro normale, calore, batteria e memoria. Anche un’inferenza rapida per immagine diventa lavoro prolungato su centinaia di migliaia di campioni, oltre alle code separate di OCR e trascrizione. Hash, piani in cache, snapshot e tentativi ripetuti sono basi utili, ma importazioni interrotte, dischi scollegati, indici danneggiati e migrazioni dei modelli metteranno alla prova il recupero su larga scala.
SCM entra in una categoria già esistente di strumenti fotografici locali per Mac e video professionale, non in un mercato vuoto. La sua combinazione utile è codice aperto, perimetro definito dalle cartelle, elaborazione locale e più modalità di ricerca. Rilasci riproducibili, risposta ai problemi, segnalazioni di sicurezza, contributi esterni e valutazioni indipendenti conteranno più delle stelle o di una chat elaborata.
Una cartella rappresentativa e controllata può mostrare i compromessi prima di copiare un intero archivio. Video lunghi, screenshot, testo visibile, dialoghi e file simili rivelano errori diversi; tempi d’importazione, spazio aggiunto e timestamp originali rendono misurabili i risultati. Originali e backup dovrebbero restare fuori dalla copia gestita. La promessa sostanziale è trovare ripetutamente la fonte giusta vicino al momento giusto, non soltanto aggiungere un’altra casella di ricerca IA al Mac.