
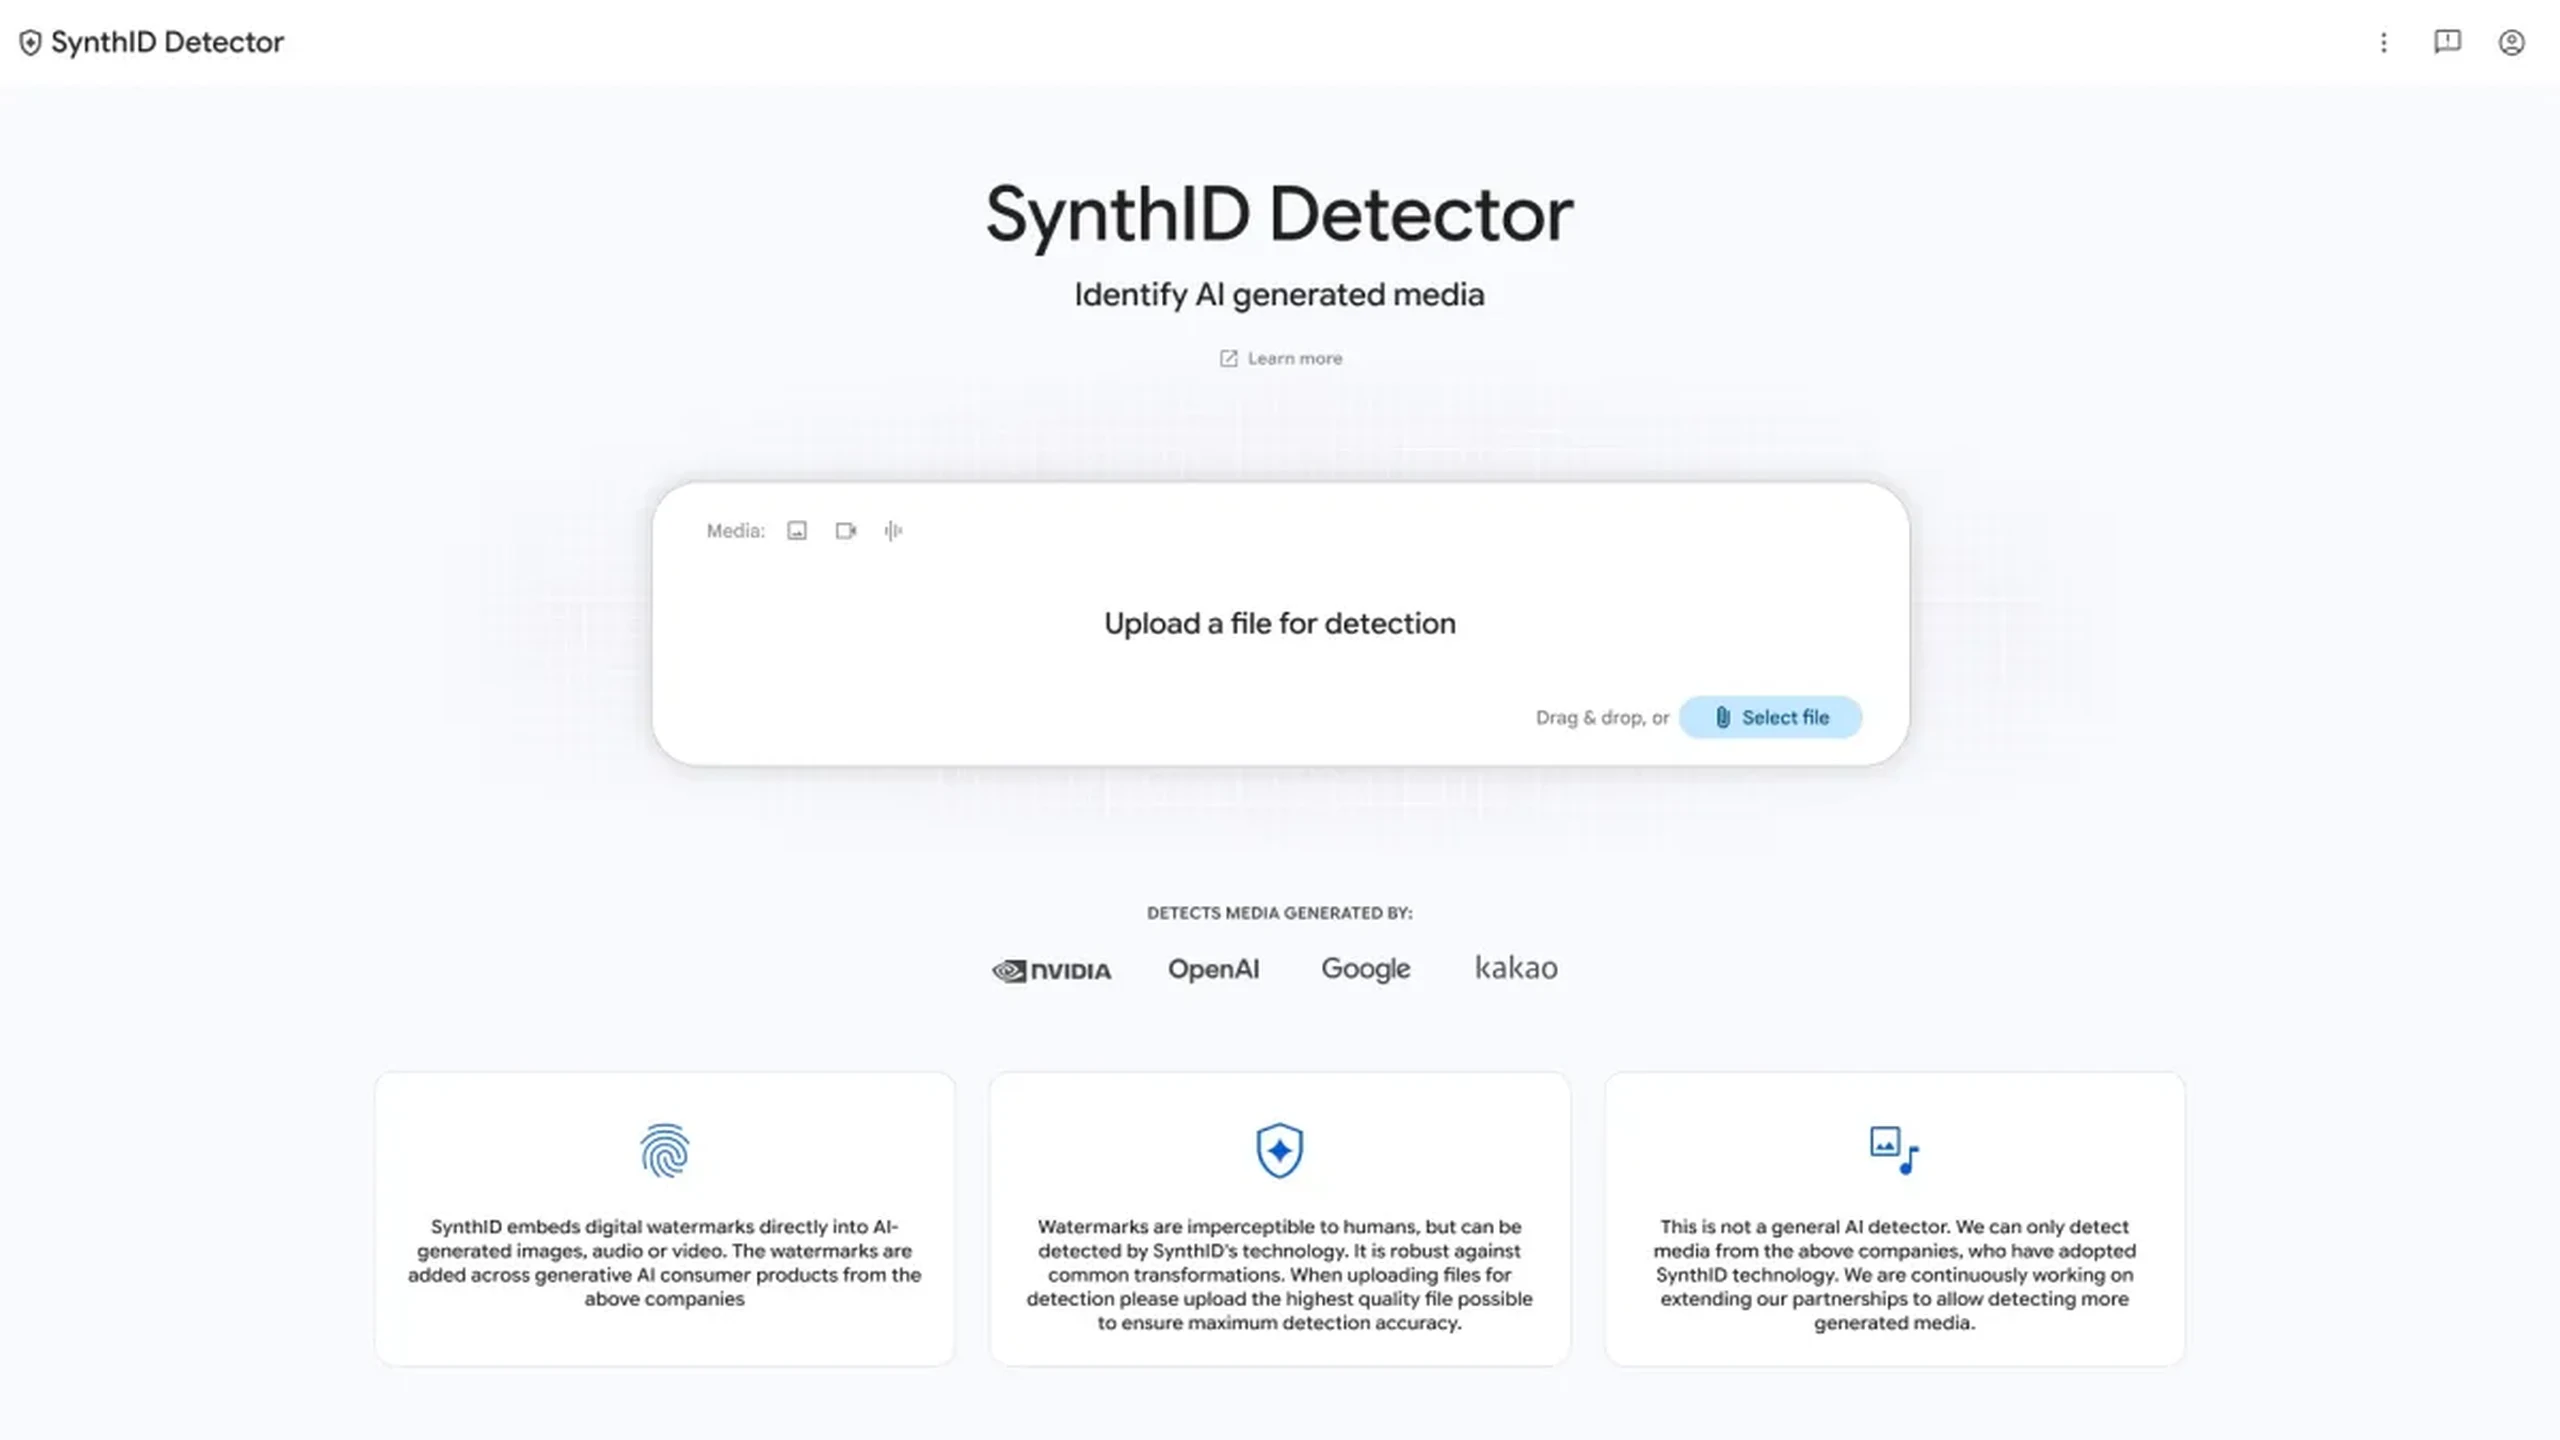
O SynthID Detector público da Google permite que qualquer pessoa verifique diretamente se uma imagem, vídeo ou ficheiro de áudio contém a marca de água invisível de um gerador participante. A principal mudança é o acesso: uma ferramenta antes limitada a determinados jornalistas, investigadores e profissionais dos media passa a ter um site em inglês disponível mundialmente.
Mesmo o resultado mais útil tem um limite. Recuperar uma marca é evidência de um processo compatível de geração ou edição, não um veredito de que a mensagem representada é falsa. A ausência da marca não prova autoria humana. O lançamento alarga uma rede útil de verificação sem a transformar num detetor universal.
De uma antevisão restrita ao envio de ficheiros
A Google apresentou o portal no I/O em maio de 2025. O fim da lista de espera oferece um percurso próprio, fora do Gemini, Search e Chrome, onde a verificação já está integrada. A empresa diz que estas ferramentas integradas processam mais de um milhão de pedidos diários. Um balanço anterior registou cinquenta milhões de utilizações antes da expansão do acesso no Search e Chrome.
O site aceita imagens JPG/JPEG, PNG, BMP, WEBP, AVIF, HEIC/HEIF, TIFF/TIF e GIF; vídeo MP4, MOV e WEBM; e áudio WAV, MP3, OGG, FLAC, AAC e M4A. Pode localizar áreas ou intervalos temporais marcados, em vez de atribuir apenas uma etiqueta indiferenciada ao ficheiro inteiro.
A distinção importa quando se misturam fontes. Um vídeo convencional pode receber voz gerada, enquanto uma imagem editada combina zonas marcadas e não marcadas. Encontrar SynthID num segmento sonoro não estabelece que a componente visual também foi gerada. Nenhum resultado prova o consentimento de quem fala, a correção da legenda ou que o acontecimento ocorreu.
O site verifica media; não é um detetor universal de escrita por IA. A Google possui também uma técnica de marcação de texto, mas isso não significa que o envio de imagens, vídeo e áudio permita avaliar qualquer escrito.
A escala e as parcerias explicam o momento
A Google afirma ter marcado mais de 180 mil milhões de imagens e vídeos e áudio equivalente a 240 mil anos. São números empresariais de implementação, não medições independentes de precisão, falsos positivos ou resistência a ataques.
Os produtos compatíveis incluem Gemini, Flow, Vids e ProducerAI, com famílias de modelos como Nano Banana, Veo e Lyria. O sistema inicial de imagem chegou em agosto de 2023 através do Imagen no Vertex AI, antes da expansão para outras modalidades.
Segundo a Google, OpenAI, Nvidia e Kakao suportam SynthID nas saídas relevantes. A participação da Apple é esperada mais tarde, não é uma capacidade já entregue. O nome de um parceiro não prova que todos os seus produtos, versões de modelos ou percursos de exportação estejam abrangidos.
A expansão segue também o anúncio de agosto que permitia remover marcas visíveis de algumas imagens, vídeos e canções geradas, preservando SynthID invisível e metadados C2PA. Resultados visualmente mais limpos transferem mais responsabilidade explicativa para provas legíveis por máquina. Um leitor público torna-se mais valioso quando não há uma etiqueta evidente.
A participação de várias empresas aumenta o alcance, mas a adoção continua a ser condição. Geradores incompatíveis, processos modificados de modelos abertos e ferramentas de exportação que perdem sinais deixam lacunas significativas. O número de ficheiros marcados não se converte numa percentagem de todos os media sintéticos.
Um sinal integrado é diferente de adivinhar pela aparência
SynthID insere ativamente um padrão planeado durante a geração ou edição e procura-o mais tarde. A implementação inicial para imagem utilizava duas redes neuronais treinadas em conjunto: uma incorporava o sinal impercetível e a outra aprendia a recuperá-lo e classificá-lo. Era necessário equilibrar persistência e qualidade da imagem.
O vídeo estende a marcação aos fotogramas, em vez de acrescentar uma etiqueta removível num canto. O áudio utiliza padrões inaudíveis, incluindo nas saídas do Lyria e das funções áudio do NotebookLM. A Google diz que compressão normal, ruído acrescentado e alterações de velocidade podem deixar as marcas sonoras detetáveis.
Para imagens, a empresa descreve resistência a recortes habituais, ajustes de cor ou luminosidade, filtros e compressão com perdas. Não garante sobrevivência a todas as transformações. Gravar o ecrã ou filmar novamente pode substituir as estruturas originais de píxeis, som e metadados por um novo ficheiro.
O texto usa outro mecanismo: pequenas alterações nas probabilidades de escolha dos tokens criam um padrão estatístico. A investigação da Google indica melhor deteção em passagens longas e variadas do que em textos curtos ou muito reescritos. Este contexto explica o nome partilhado, mas não alarga o âmbito do portal público.
Um classificador forense, em contraste, estima origem sintética a partir de características estatísticas ou visuais sem exigir uma marca prévia. Pode tentar avaliar fontes desconhecidas, mas as conclusões são probabilísticas. Edições convencionais podem causar falsos positivos; mudanças nos geradores podem produzir falsos negativos. SynthID faz uma afirmação mais estreita: se é possível recuperar o seu sinal compatível.
Resistir à edição comum não garante proteção contra ataques
Uma resposta negativa deixa em aberto geração incompatível, processamento intenso, remoção deliberada e criação humana normal. Responde a uma pergunta sobre recuperação de sinal, não sobre qualquer intervenção de IA no ficheiro.
Um estudo NeurIPS revisto por pares encontrou que a reconstrução generativa podia reduzir a deteção em vários sistemas de marcação ao nível do píxel, preservando qualidade utilizável. Não estabeleceu que cada ataque desse género derrota a implementação atual da Google. A evidência não justifica rejeitar todas as marcas nem chamar ao sistema atual invulnerável.
Os falsos positivos merecem análise separada quando o resultado influencia decisões jornalísticas, processos disciplinares ou investigações de fraude. A Google não publicou uma precisão única que cubra todos os parceiros, formatos, transformações e percursos reais de envio. Os totais de implementação e os pedidos diários não preenchem essa lacuna de evidência.
Testes independentes devem separar redimensionamento, recompressão, transcodificação e tratamento normal das plataformas das tentativas deliberadas de remoção. Misturar ameaças diferentes num único número esconderia aquilo que o detetor consegue fazer com fiabilidade. As implementações e produtos abrangidos em cada parceiro também precisam de documentação.
A proveniência complementa a marca, sem certificar a verdade
As Content Credentials C2PA oferecem outra camada: declarações assinadas sobre captura, geração, edições e entidades signatárias, sujeitas a controlos de identidade e confiança. A marca viaja nos dados do media; uma credencial pode descrever o historial. Nenhuma tem sobrevivência garantida a capturas de ecrã, exportações incompatíveis ou transformações das plataformas.
A rotulagem da Meta combina informação C2PA e IPTC legível por máquina com sinais próprios. Microsoft e Adobe também apoiam sistemas de proveniência. Estas abordagens podem complementar marcas integradas, em vez de disputar um único veredito completo de autenticidade.
Preservar originais, URL de origem, momentos de publicação, credenciais e contexto da verificação facilita a interpretação posterior. Investigar a fonte, pesquisar imagens inversamente e obter confirmação de testemunhas aborda perguntas que a marca não resolve. Uma fotografia verdadeira pode ter data ou local falsos; uma simulação educativa gerada pode estar identificada e ser inteiramente benigna.
O lançamento melhora o acesso a evidência de origem, não a uma máquina que decide a verdade. O valor prático dependerá de registos claros de compatibilidade, avaliação externa e plataformas que preservem sinais. Um resultado positivo restringe a questão da origem; um negativo mantém-na em aberto.