
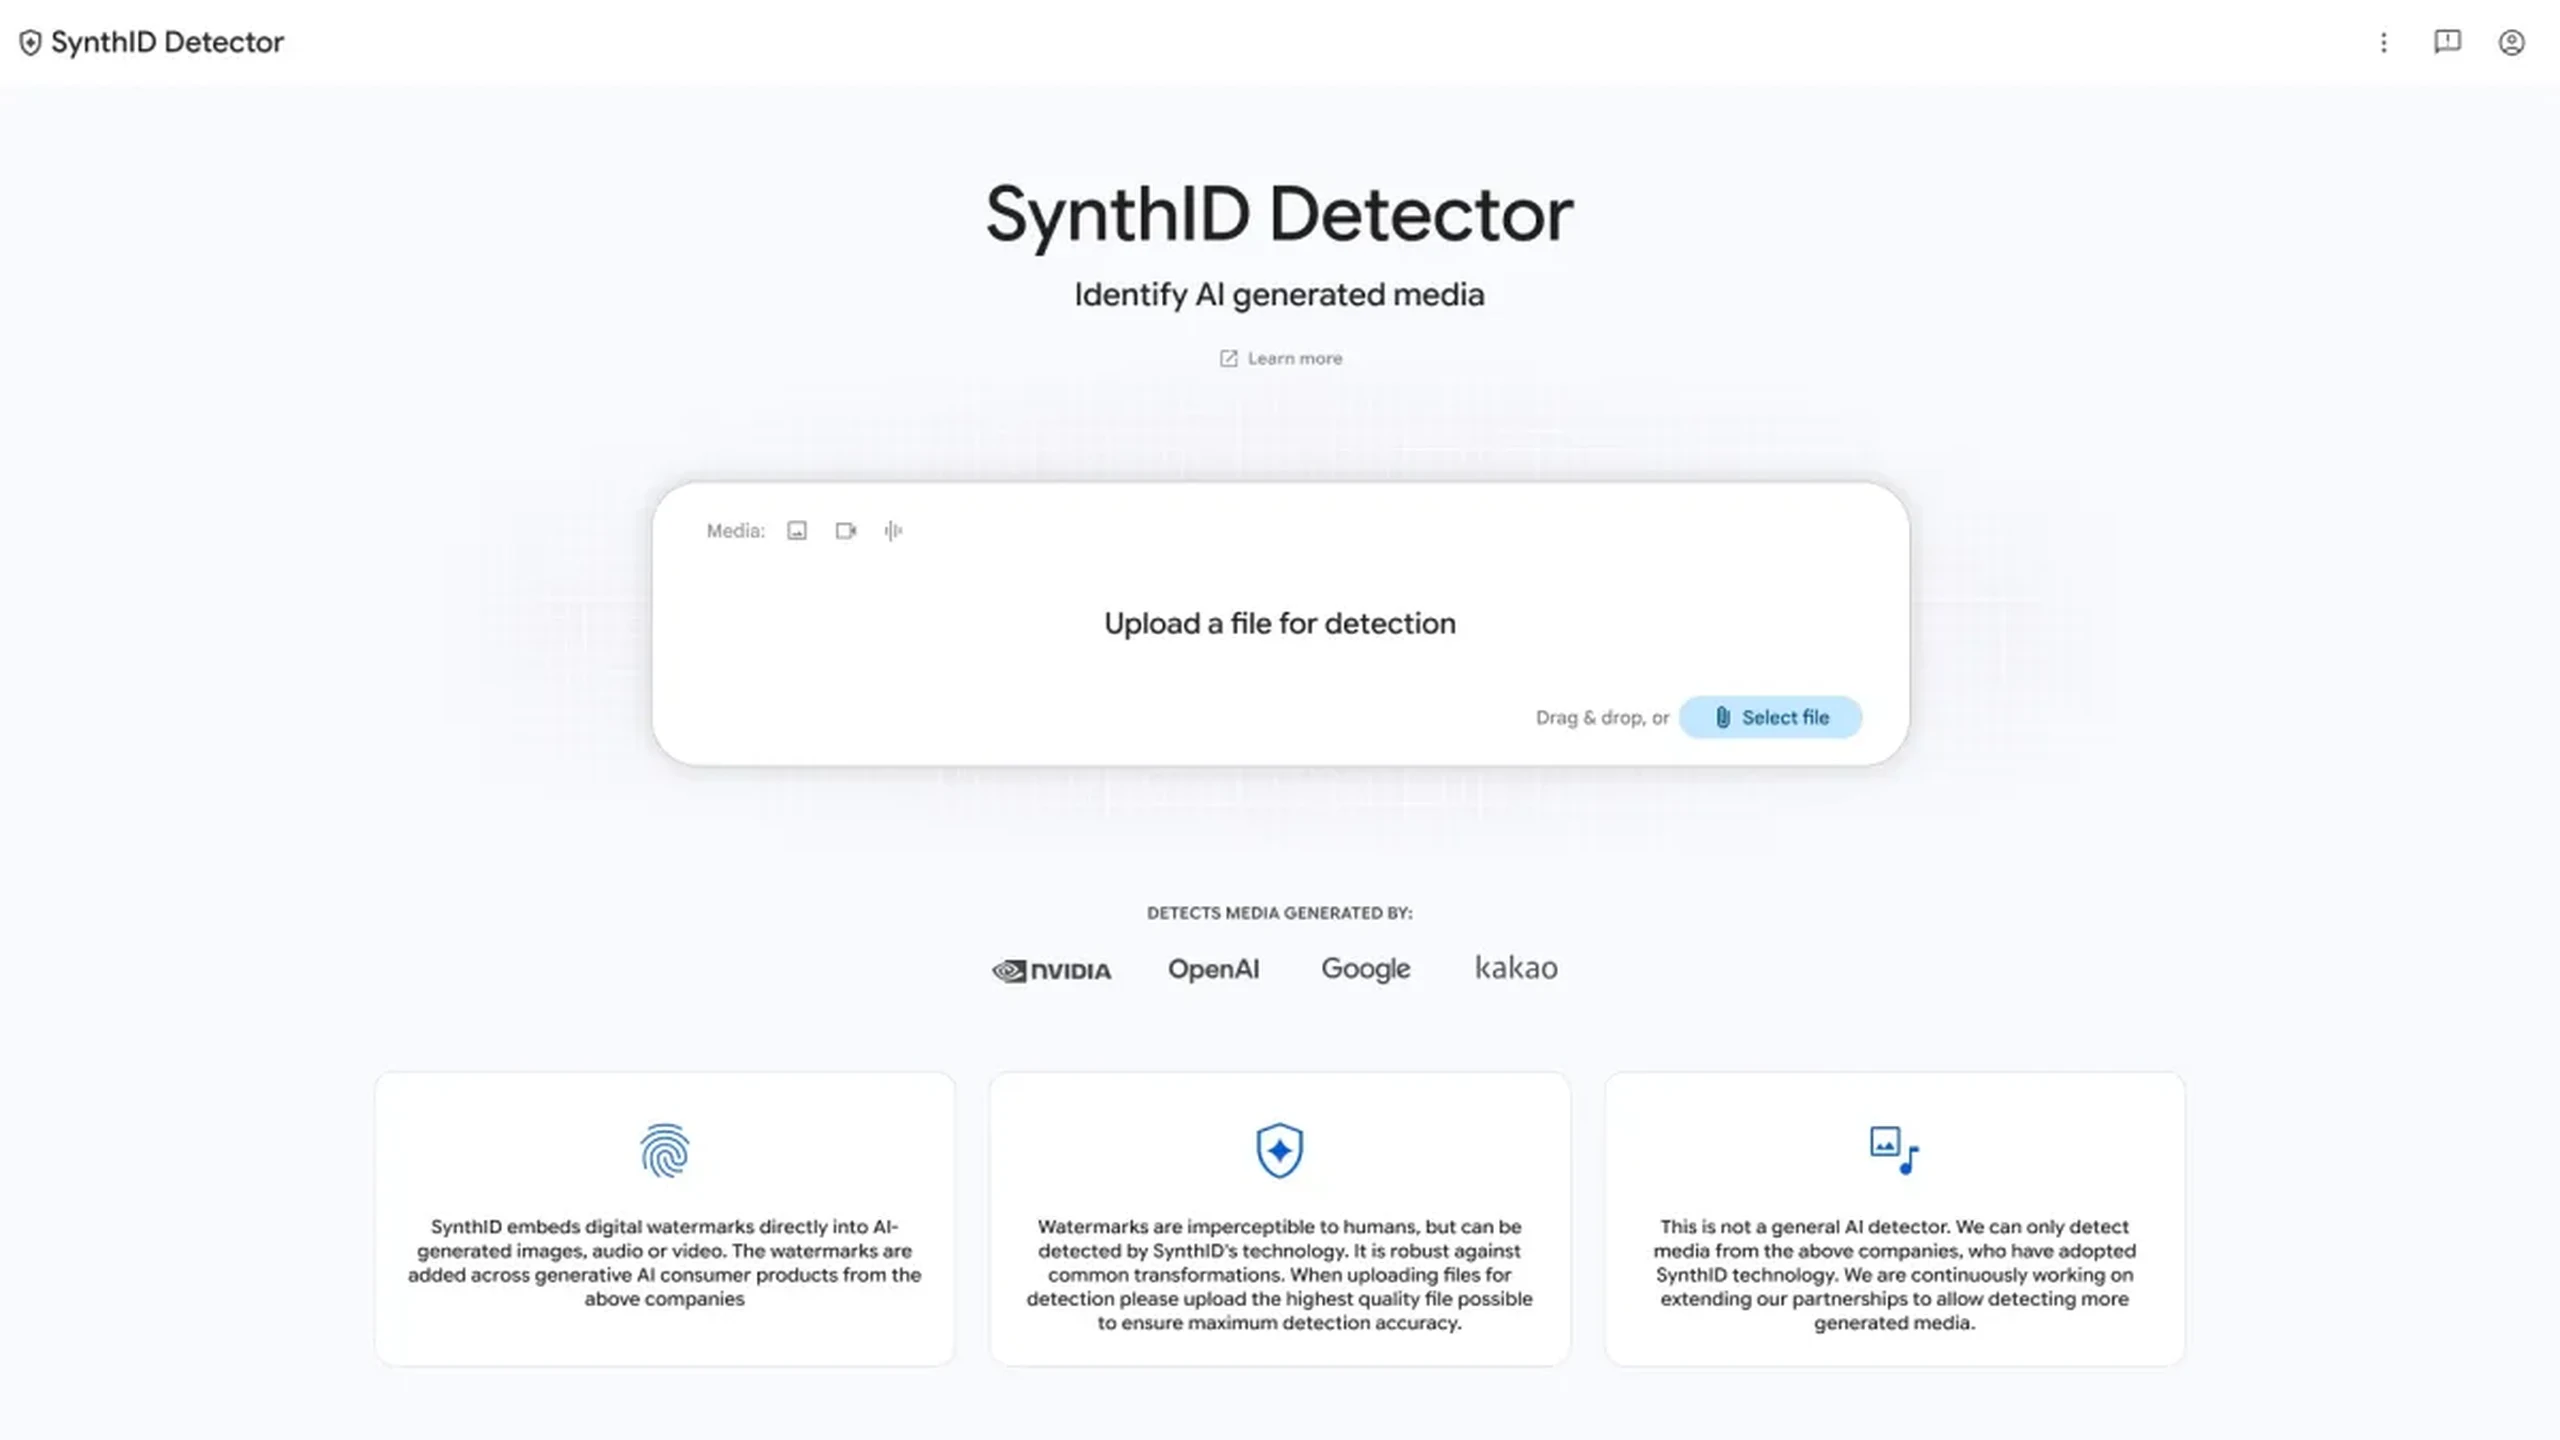
Le SynthID Detector public de Google permet à chacun de vérifier directement si une image, une vidéo ou un fichier audio contient le filigrane invisible d'un générateur participant. Le changement important concerne l'accès : réservé jusqu'ici à certains journalistes, chercheurs et professionnels des médias, l'outil dispose désormais d'un site en anglais accessible mondialement.
Son résultat le plus utile comporte aussi une limite. Retrouver une marque constitue une preuve d'un processus de génération ou de modification compatible, pas un verdict sur la fausseté du message représenté. L'absence de marque ne prouve pas une création humaine. Le lancement élargit un réseau de vérification utile sans en faire un détecteur universel.
D'un aperçu restreint à un service de dépôt de fichiers
Google a présenté le portail à I/O en mai 2025. La suppression de la liste d'attente fournit un parcours autonome, hors de Gemini, Search et Chrome, qui intègrent déjà la vérification. Google indique que ces outils intégrés traitent plus d'un million de demandes quotidiennes. Un précédent bilan comptait cinquante millions d'utilisations avant l'élargissement de l'accès dans Search et Chrome.
Le site accepte les images JPG/JPEG, PNG, BMP, WEBP, AVIF, HEIC/HEIF, TIFF/TIF et GIF ; les vidéos MP4, MOV et WEBM ; les fichiers audio WAV, MP3, OGG, FLAC, AAC et M4A. Il peut localiser les zones ou intervalles marqués dans un fichier plutôt que lui attribuer une étiquette globale indifférenciée.
Cette distinction importe pour les contenus composites. Une vidéo filmée peut recevoir une voix générée, tandis qu'une image modifiée associe des zones marquées et non marquées. Trouver SynthID dans un passage sonore n'établit pas que la piste visuelle a été générée. Aucun résultat ne prouve non plus le consentement d'un locuteur, l'exactitude d'une légende ou la réalité d'un événement.
Le site vérifie des médias ; ce n'est pas un détecteur universel de textes produits par IA. Google possède aussi une technique de filigranage du texte, mais cela ne signifie pas que ce parcours d'importation d'images, de vidéos et d'audio analyse n'importe quel écrit.
L'échelle et les partenariats expliquent le calendrier
Google affirme avoir marqué plus de 180 milliards d'images et de vidéos et l'équivalent de 240 000 années d'audio. Ces chiffres décrivent son déploiement, pas une mesure indépendante de précision, de faux positifs ou de résistance aux attaques.
Les produits concernés comprennent Gemini, Flow, Vids et ProducerAI, avec les familles Nano Banana, Veo et Lyria. Le système d'image initial est arrivé en août 2023 dans Imagen sur Vertex AI, avant son extension à d'autres modalités.
Selon Google, OpenAI, Nvidia et Kakao prennent en charge SynthID pour les sorties concernées. La participation d'Apple est attendue ultérieurement, et non déjà livrée. Le nom d'un partenaire ne suffit pas à établir que tous ses produits, versions de modèles ou circuits d'exportation sont couverts.
L'expansion suit aussi l'annonce d'août autorisant le retrait de marques visibles sur certaines images, vidéos et chansons générées, tout en conservant SynthID invisible et les métadonnées C2PA. Des sorties plus épurées font porter davantage l'explication sur des preuves lisibles par machine. Un lecteur public devient plus utile lorsqu'aucune étiquette évidente n'est visible.
La coopération entre entreprises étend la portée, mais suppose l'adoption. Des générateurs non compatibles, des chaînes de modèles ouverts modifiées et des outils d'exportation qui perdent les signaux laissent des lacunes importantes. Le nombre de fichiers marqués ne se convertit pas en pourcentage de tous les médias synthétiques.
Un signal intégré n'est pas une supposition fondée sur l'apparence
SynthID insère activement un motif prévu pendant la génération ou la modification, puis le recherche. L'implémentation initiale pour l'image employait deux réseaux neuronaux entraînés ensemble : l'un intégrait un signal imperceptible, l'autre apprenait à le récupérer et à le classer. Il fallait concilier persistance et qualité de l'image.
La vidéo étend le filigranage aux images successives, au lieu d'ajouter une étiquette amovible dans un coin. L'audio utilise des motifs inaudibles, notamment dans les sorties de Lyria et des fonctions audio de NotebookLM. Google dit que la compression ordinaire, le bruit ajouté et les variations de vitesse peuvent laisser les marques détectables.
Pour les images, l'entreprise décrit une résistance aux recadrages courants, aux changements de couleur ou de luminosité, aux filtres et à la compression avec perte. Cela ne garantit pas la survie à toute transformation. Un enregistrement d'écran ou une nouvelle prise de vue peuvent remplacer les structures originales de pixels, de son et de métadonnées par un nouveau fichier.
Le texte fonctionne autrement : les probabilités de sélection des jetons sont légèrement modifiées pour créer un motif statistique. Les recherches de Google indiquent une meilleure détection sur des passages longs et variés que sur des textes courts ou fortement réécrits. Ce contexte explique le nom commun, sans élargir le périmètre du portail public.
Un classificateur forensique, à l'inverse, estime l'origine synthétique à partir de caractéristiques statistiques ou visuelles sans marque préalable. Il peut tenter d'analyser des sources inconnues, mais ses conclusions restent probabilistes : des retouches ordinaires peuvent produire des faux positifs, et les progrès des générateurs des faux négatifs. La proposition de SynthID est plus étroite : récupérer ou non son signal compatible.
La résistance ordinaire ne garantit pas la sécurité face aux attaques
Un résultat négatif laisse ouvertes plusieurs possibilités : génération non compatible, traitement lourd, suppression délibérée ou création humaine. Il répond à une question de récupération du signal, non à celle de toute intervention possible d'une IA.
Une étude évaluée par les pairs à NeurIPS a montré que la reconstruction générative pouvait réduire la détection de plusieurs filigranes au niveau des pixels tout en préservant une qualité exploitable. Elle n'a pas établi que chaque attaque de ce type vainc l'implémentation actuelle de Google. Elle ne justifie ni de rejeter tout filigranage, ni de qualifier le système d'inattaquable.
Les faux positifs méritent un examen distinct lorsque le résultat influence une décision rédactionnelle, disciplinaire ou une enquête pour fraude. Google n'a pas publié une précision unique couvrant tous les partenaires, formats, transformations et parcours réels de dépôt. Les volumes de déploiement et les requêtes quotidiennes ne comblent pas ce manque de preuve.
Les tests indépendants doivent séparer redimensionnement, recompression, transcodage et traitement de plateforme ordinaires des tentatives de suppression. Mélanger ces menaces dans un seul chiffre masquerait ce que l'outil accomplit de manière fiable. Les implémentations et produits couverts chez chaque partenaire nécessitent aussi une documentation.
La provenance complète le filigrane, sans certifier la vérité
Les Content Credentials C2PA apportent une autre couche : des déclarations signées concernant capture, génération, modifications et signataires, sous réserve des contrôles d'identité et de confiance. Le filigrane voyage dans les données ; le justificatif décrit une histoire. Aucun n'est assuré de survivre aux captures d'écran, aux exportations non compatibles ou aux transformations des plateformes.
L'étiquetage de Meta combine les informations C2PA et IPTC lisibles par machine avec ses propres signaux. Microsoft et Adobe soutiennent aussi des systèmes de provenance. Ces approches peuvent compléter les marques intégrées plutôt que prétendre chacune fournir un verdict total d'authenticité.
Conserver les originaux, URL sources, dates de publication, justificatifs et contexte d'une vérification facilite son interprétation ultérieure. L'enquête sur la source, la recherche inversée et les témoignages répondent à des questions que le filigrane ne tranche pas. Une vraie photographie peut porter une date ou un lieu mensongers ; une simulation pédagogique générée peut être clairement signalée et parfaitement bénigne.
Le lancement améliore donc l'accès aux preuves d'origine, pas à une machine qui décide du vrai. Sa valeur dépendra de relevés de compatibilité clairs, d'évaluations externes et de plateformes préservant les signaux. Un résultat positif réduit le champ de la question d'origine ; un résultat négatif la laisse ouverte.