
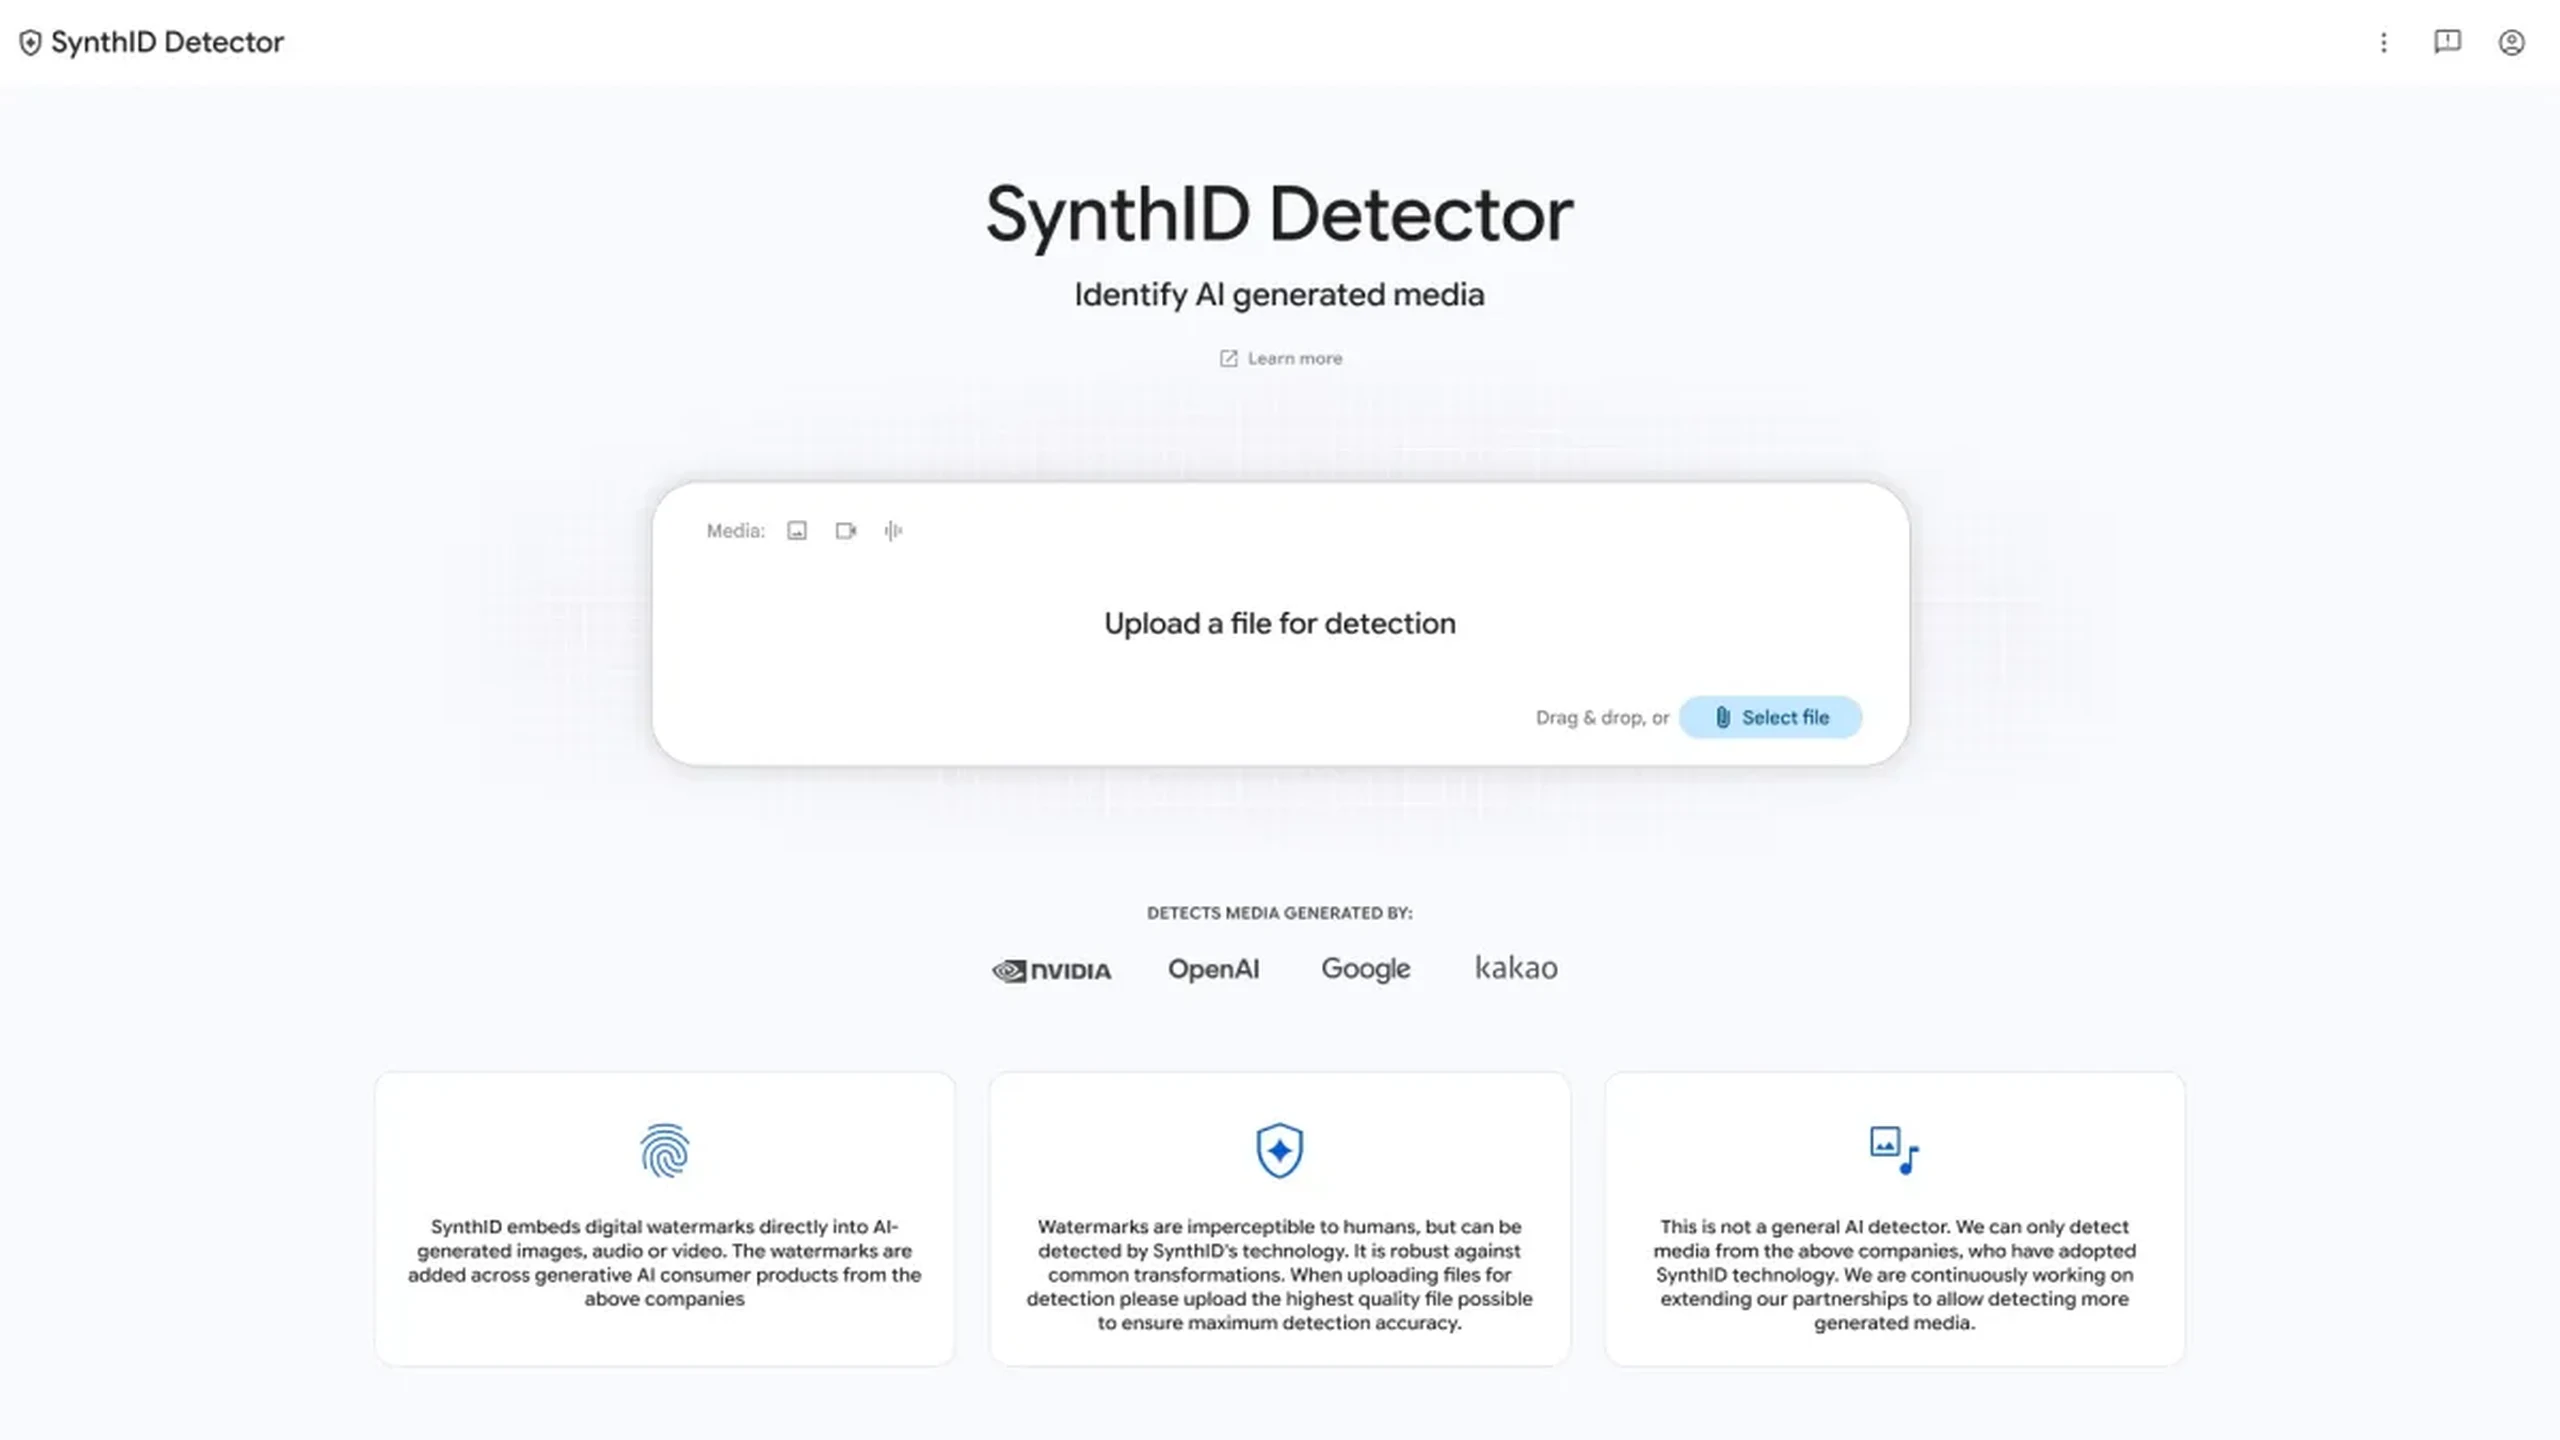
Publiczny SynthID Detector Google pozwala każdemu bezpośrednio sprawdzić, czy obraz, film lub plik dźwiękowy zawiera niewidoczny znak wodny uczestniczącego generatora. Najważniejszą zmianą jest dostępność: narzędzie ograniczone wcześniej do wybranych dziennikarzy, badaczy i specjalistów od mediów ma teraz anglojęzyczną witrynę dostępną na całym świecie.
Nawet najbardziej użyteczny wynik ma jednak granice. Odzyskanie znaku świadczy o zgodnym procesie generowania lub edycji, a nie o tym, że przedstawiona treść jest fałszywa. Brak znaku nie dowodzi ludzkiego autorstwa. Udostępnienie rozszerza przydatną sieć weryfikacji, ale nie zmienia jej w uniwersalny detektor.
Od ograniczonego podglądu do przesyłania plików
Google zaprezentowało portal na I/O w maju 2025 roku. Usunięcie listy oczekujących zapewnia osobny sposób pracy poza Gemini, Search i Chrome, gdzie weryfikacja jest już zintegrowana. Według firmy te zintegrowane narzędzia obsługują ponad milion zapytań dziennie. Wcześniejszy bilans wskazywał pięćdziesiąt milionów użyć przed rozszerzeniem dostępu w Search i Chrome.
Witryna przyjmuje obrazy JPG/JPEG, PNG, BMP, WEBP, AVIF, HEIC/HEIF, TIFF/TIF i GIF; filmy MP4, MOV i WEBM; oraz dźwięk WAV, MP3, OGG, FLAC, AAC i M4A. Potrafi wskazać oznaczone obszary lub odcinki czasu, zamiast nadawać całemu plikowi jedną nierozróżniającą etykietę.
To ważne w materiałach łączących różne źródła. Zwykły film może zawierać wygenerowaną mowę, a edytowany obraz obszary ze znakiem i bez niego. Wykrycie SynthID we fragmencie dźwięku nie oznacza, że wygenerowano również obraz. Wynik nie dowodzi też zgody mówiącej osoby, poprawności podpisu ani tego, że wydarzenie rzeczywiście miało miejsce.
Witryna sprawdza media, nie jest uniwersalnym wykrywaczem tekstów AI. Google ma także technikę znakowania tekstu, ale jej istnienie nie oznacza, że ten proces przesyłania obrazów, filmów i dźwięku analizuje dowolne pisma.
Skala i partnerstwa wyjaśniają moment udostępnienia
Google twierdzi, że oznaczyło ponad 180 miliardów obrazów i filmów oraz dźwięk odpowiadający 240 tysiącom lat. Są to firmowe dane o wdrożeniu, nie niezależne pomiary trafności, fałszywych alarmów czy odporności na ataki.
Obsługiwane produkty obejmują Gemini, Flow, Vids i ProducerAI, a rodziny modeli to między innymi Nano Banana, Veo i Lyria. Pierwszy system obrazowy pojawił się w sierpniu 2023 roku poprzez Imagen w Vertex AI, a potem rozszerzono go na inne rodzaje danych.
Według Google OpenAI, Nvidia i Kakao obsługują SynthID dla odpowiednich wyników. Udział Apple jest oczekiwany później, nie stanowi już dostarczonej funkcji. Sama nazwa partnera nie dowodzi objęcia wszystkich jego produktów, wersji modeli i dróg eksportu.
Rozszerzenie następuje też po sierpniowej zapowiedzi możliwości usuwania widocznych oznaczeń z niektórych generowanych obrazów, filmów i piosenek, przy zachowaniu niewidocznego SynthID oraz metadanych C2PA. Czystszy wygląd przenosi ciężar wyjaśniania pochodzenia na dowody czytelne maszynowo. Publiczny czytnik staje się cenniejszy, gdy nie ma oczywistej etykiety.
Udział różnych firm zwiększa zasięg, lecz warunkiem pozostaje przyjęcie technologii. Nieobsługiwane generatory, zmodyfikowane procesy otwartych modeli i eksporty nieutrzymujące sygnałów pozostawiają poważne luki. Liczby oznaczonych plików nie można przeliczyć na odsetek wszystkich mediów syntetycznych.
Wbudowany sygnał różni się od zgadywania na podstawie wyglądu
SynthID aktywnie umieszcza zaplanowany wzór podczas generowania lub edycji, a później go szuka. Pierwotne rozwiązanie obrazowe korzystało z dwóch wspólnie trenowanych sieci neuronowych: jedna osadzała niewidoczny sygnał, druga uczyła się go odzyskiwać i klasyfikować. Trzeba było pogodzić trwałość z jakością obrazu.
W filmie znakowanie obejmuje kolejne klatki, zamiast dodawać usuwalną etykietę w rogu. Dźwięk wykorzystuje niesłyszalne wzorce, również w wynikach Lyria i funkcji dźwiękowych NotebookLM. Google mówi, że zwykła kompresja, dodany szum i zmiana szybkości odtwarzania mogą pozostawić znaki wykrywalne.
W obrazach firma opisuje odporność na typowe kadrowanie, zmianę koloru lub jasności, filtry i kompresję stratną. Nie gwarantuje to przetrwania każdej transformacji. Nagranie ekranu albo ponowne sfotografowanie może zastąpić pierwotną strukturę pikseli, dźwięku i metadanych nowym plikiem.
Tekst działa inaczej: drobne zmiany prawdopodobieństwa wyboru tokenów tworzą wzór statystyczny. Według badań Google wykrywanie działa lepiej na dłuższych, zróżnicowanych fragmentach niż na tekstach krótkich lub mocno przeredagowanych. Wyjaśnia to wspólną nazwę, ale nie rozszerza zakresu publicznego portalu.
Klasyfikator kryminalistyczny natomiast szacuje syntetyczne pochodzenie z cech statystycznych lub wizualnych bez uprzednio osadzonego znaku. Może próbować badać nieznane źródła, lecz wnioski są probabilistyczne. Zwykła edycja może powodować fałszywe alarmy, a zmieniające się generatory przeoczenia. SynthID stawia węższe pytanie: czy da się odzyskać zgodny sygnał?
Odporność na zwykłe zmiany nie jest gwarancją przeciw atakom
Wynik negatywny pozostawia możliwość nieobsługiwanego generowania, silnego przetwarzania, celowego usunięcia lub stworzenia przez człowieka. Odpowiada na pytanie o odzyskanie sygnału, a nie o jakikolwiek udział AI w pliku.
Recenzowane badanie NeurIPS wykazało, że rekonstrukcja generatywna mogła obniżać wykrywanie kilku pikselowych systemów znakowania przy zachowaniu użytecznej jakości obrazu. Nie wykazało, że każdy taki atak pokonuje obecną implementację Google. Nie uzasadnia to ani odrzucenia wszystkich znaków wodnych, ani nazywania obecnego systemu odpornym na każdy atak.
Fałszywe alarmy wymagają osobnej analizy, jeśli wynik wpływa na decyzję redakcji, postępowanie dyscyplinarne lub dochodzenie dotyczące oszustwa. Google nie opublikowało jednej miary trafności obejmującej każdego partnera, format, transformację i rzeczywistą drogę przesyłania. Skala wdrożenia i dzienne zapytania nie wypełniają tej luki dowodowej.
Niezależne testy powinny oddzielać zwykłe skalowanie, ponowną kompresję, transkodowanie i przetwarzanie przez platformy od prób celowego usuwania. Połączenie różnych zagrożeń w jednym wskaźniku ukryłoby rzeczywistą niezawodność. Również implementacje partnerów i zakres produktów wymagają dokumentacji, nie założeń.
Pochodzenie uzupełnia znak, ale nie poświadcza prawdy
Content Credentials C2PA zapewniają kolejną warstwę: podpisane twierdzenia o rejestracji, generowaniu, edycji i podmiotach podpisujących, zależne od kontroli tożsamości i zaufania. Znak podróżuje wewnątrz danych, a poświadczenie opisuje historię. Żadne nie ma gwarancji przetrwania zrzutów ekranu, nieobsługiwanego eksportu i zmian platformowych.
Etykietowanie Meta łączy czytelne maszynowo dane C2PA i IPTC z własnymi sygnałami. Microsoft i Adobe również wspierają systemy pochodzenia. Mogą one uzupełniać osadzone znaki, zamiast rywalizować o jeden pełny werdykt autentyczności.
Zachowanie oryginałów, źródłowych adresów URL, dat publikacji, poświadczeń i kontekstu kontroli ułatwia późniejszą interpretację. Badanie źródła, odwrotne wyszukiwanie obrazów i potwierdzenia świadków odpowiadają na pytania, których znak nie rozstrzyga. Prawdziwe zdjęcie może mieć fałszywą datę lub lokalizację; oznaczona symulacja edukacyjna AI może być nieszkodliwa.
Premiera poprawia dostęp do dowodów pochodzenia, nie do maszyny rozstrzygającej prawdę. Wartość zależy od jasnych zapisów kompatybilności, zewnętrznej oceny i zachowywania sygnałów w dystrybucji. Wynik pozytywny zawęża pytanie o pochodzenie, negatywny pozostawia je otwarte.