
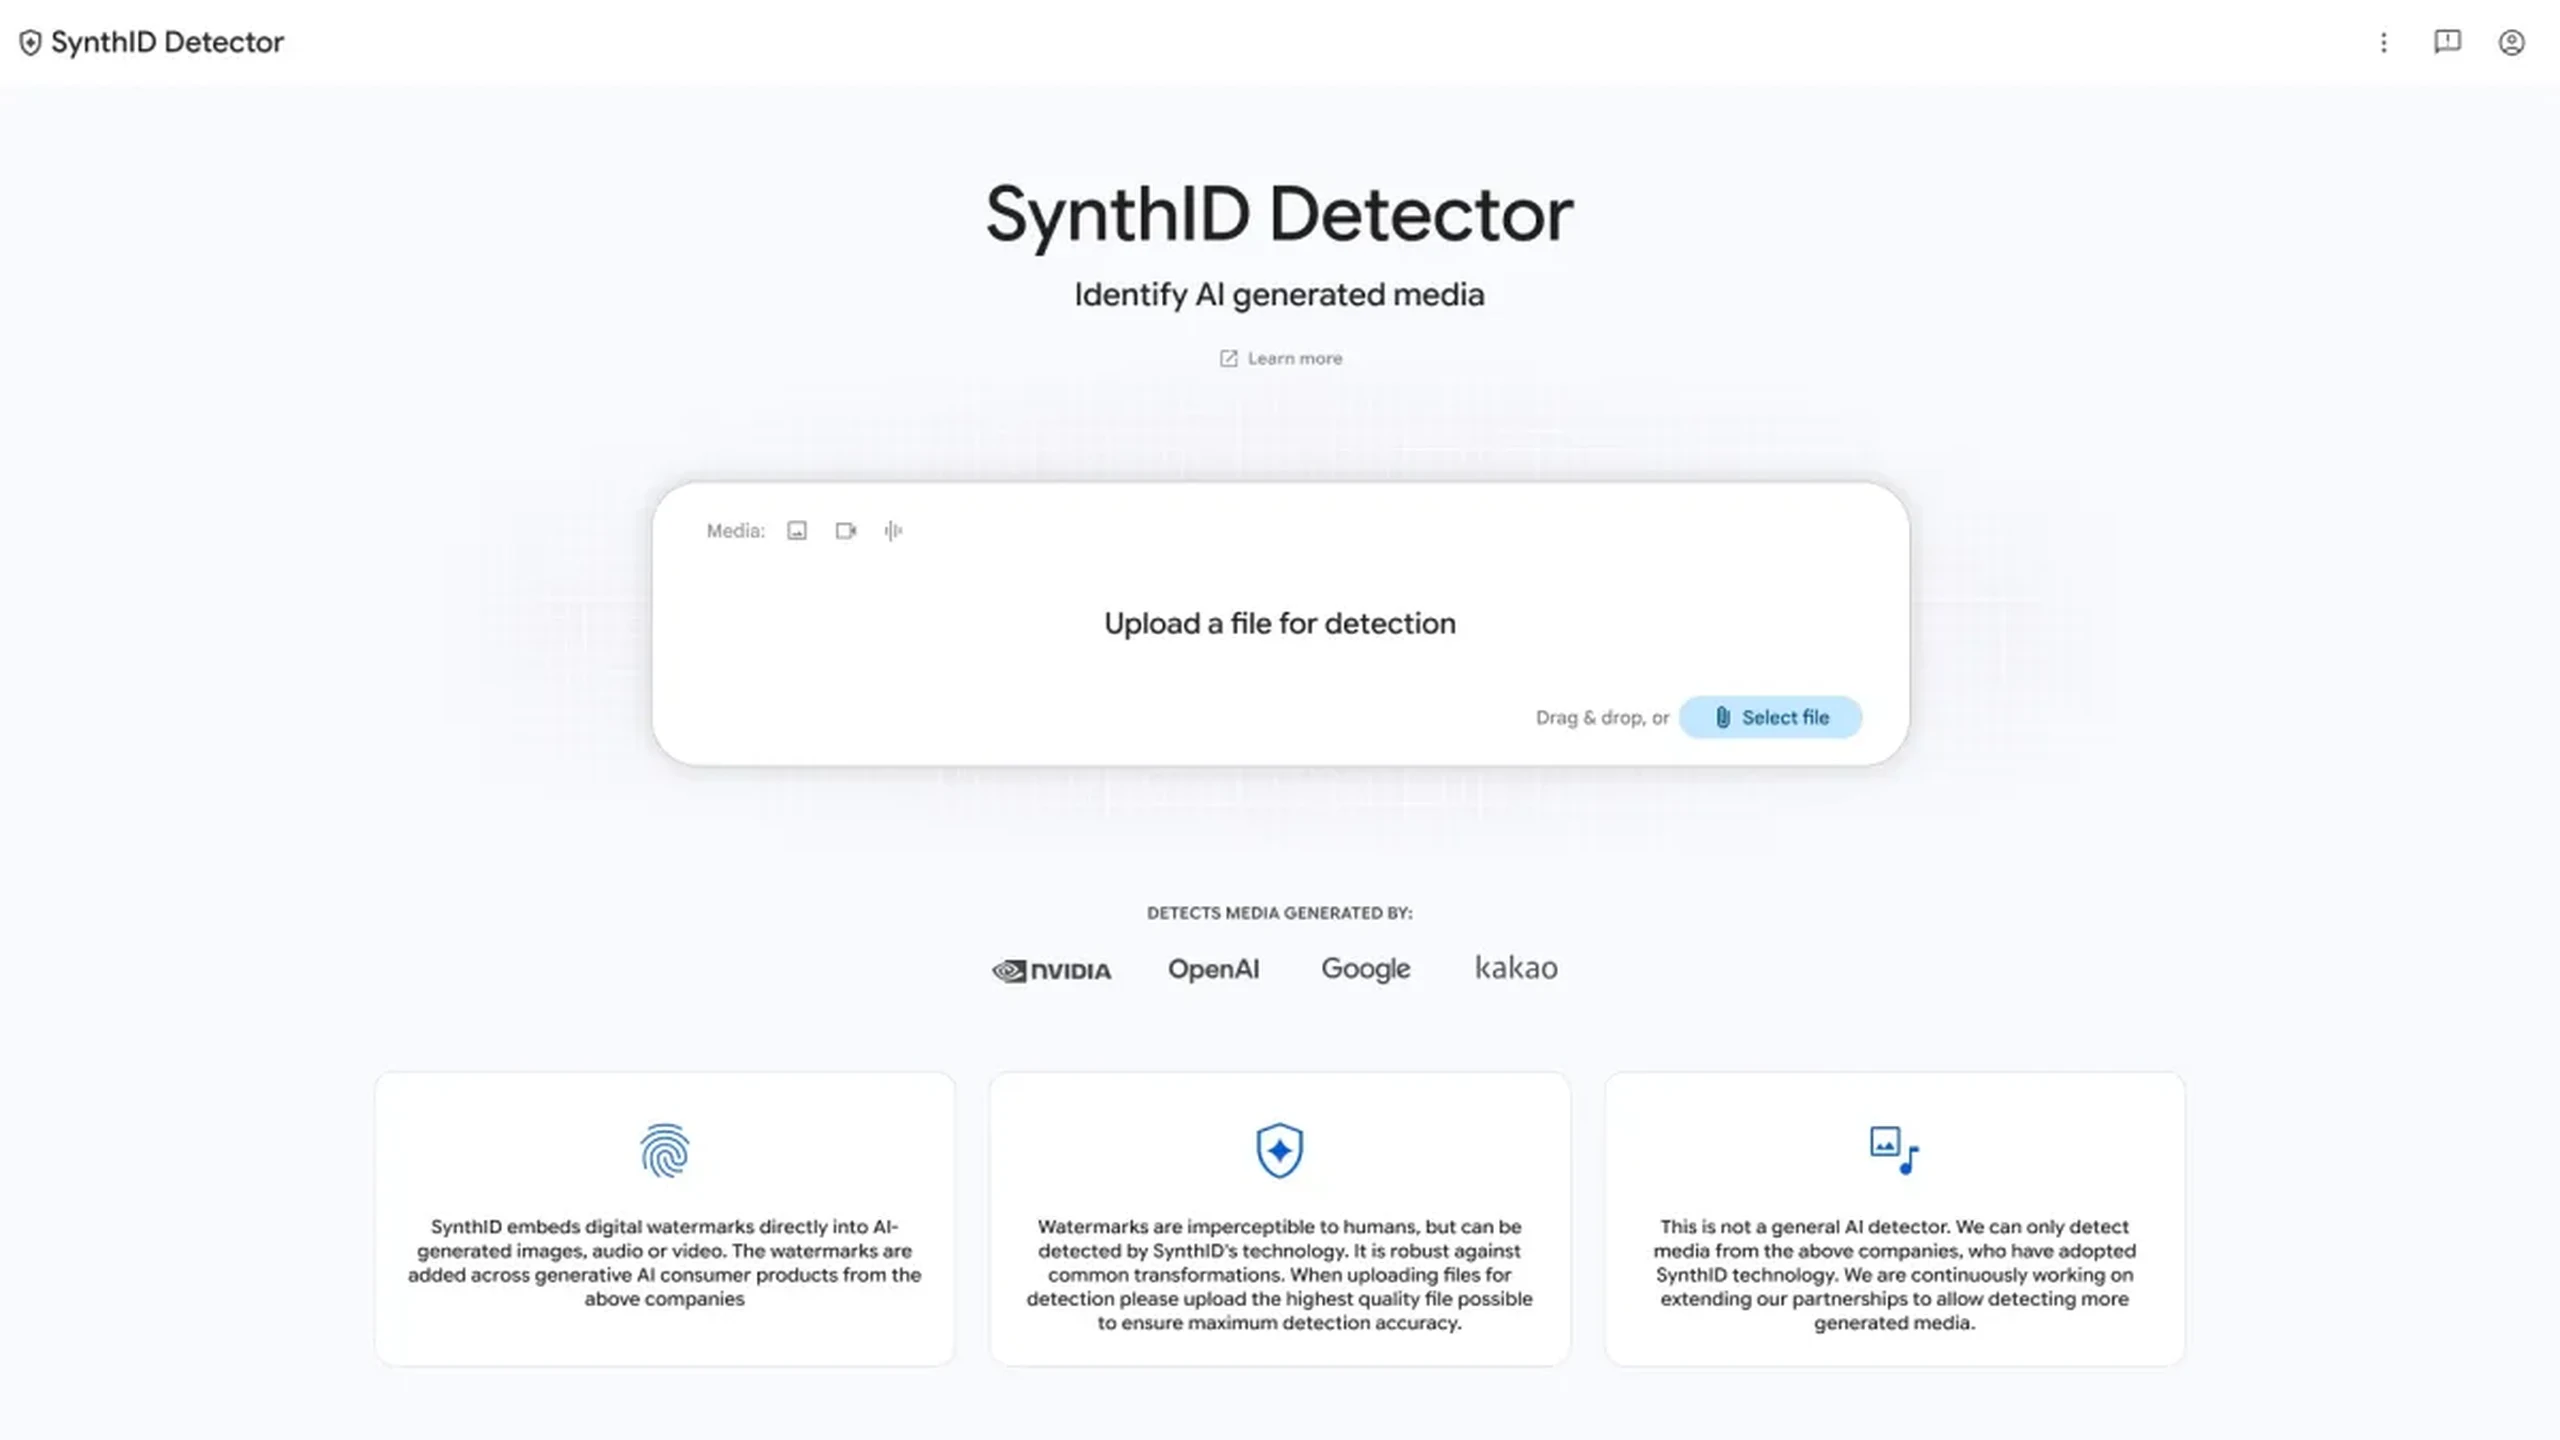
Googleが一般公開したSynthID Detectorでは、画像、動画、音声に参加する生成システムの不可視透かしがあるかを、誰でも直接調べられる。今回の大きな変化はアクセスだ。特定の記者、研究者、メディア関係者に限られていたツールが、世界から利用できる英語サイトになった。
ただし、最も有用な結果にも境界がある。透かしの検出は対応する生成・編集過程の証拠であり、描かれた主張が虚偽だという判定ではない。検出されないことも、人間による制作の証明にはならない。公開によって検証ネットワークは広がるが、万能な検出器になるわけではない。
限定プレビューからファイルのアップロードへ
Googleは2025年5月のI/Oで検出ポータルを発表した。待機リストの撤廃により、検証機能をすでに備えるGemini、Search、Chromeを使わずに、専用サイトで確認できる。同社によると統合ツールへの検証依頼は一日100万件以上だ。SearchとChromeでアクセスを拡大する前の説明では、累計利用は5,000万回だった。
画像はJPG/JPEG、PNG、BMP、WEBP、AVIF、HEIC/HEIF、TIFF/TIF、GIFに対応する。動画はMP4、MOV、WEBM、音声はWAV、MP3、OGG、FLAC、AAC、M4Aを受け付ける。単にファイル全体へ一つのラベルを付けるのではなく、透かしのある領域や時間区間を示せる。
複数の素材が混ざる場合には、この区別が重要になる。実写動画に生成音声を重ねたり、編集画像の一部だけを生成したりすることがある。音声区間からSynthIDが見つかっても、映像まで生成されたとはいえない。話者の同意、説明文の正確さ、出来事の実在も、結果だけでは証明できない。
これはメディア用の確認サイトであり、汎用的なAI文章判定器ではない。Googleには文章の透かし技術もあるが、同じ名称だからといって、画像・動画・音声のアップロードで任意の文章を分析できるわけではない。
規模と提携が公開の背景にある
Googleは1,800億点を超える画像・動画と、24万年分に相当する音声に透かしを付けたとしている。これは同社が示した導入規模であり、精度、誤検出率、攻撃への耐性を独立に測った数字ではない。
対応製品にはGemini、Flow、Vids、ProducerAI、モデル系列にはNano Banana、Veo、Lyriaが含まれる。画像版は2023年8月、Vertex AIのImagenで始まり、その後ほかのモダリティに広がった。
Googleによると、OpenAI、Nvidia、Kakaoも関連する出力でSynthIDに対応する。Appleの参加は今後の予定であり、実装済みと扱ってはいけない。企業名が提携一覧にあるだけで、全製品、モデルの全版、すべての書き出し経路に対応するとはいえない。
今回の拡大は、生成画像・動画・楽曲の一部で可視の印を削除できるようにしつつ、不可視のSynthIDとC2PAメタデータを残すという8月の発表にも続く。見た目がすっきりした出力ほど、機械が読める証拠が出自の説明を担う。目立つラベルがなくなると、その証拠を読む公開ツールの価値が増す。
企業をまたぐ採用は範囲を広げるが、採用していることが条件だ。非対応の生成器、改変されたオープンモデルの処理系、信号を保持しない書き出しツールには穴が残る。透かし付き素材の総数を、全合成メディアのカバー率へ換算することはできない。
埋め込んだ信号と外見による推測は異なる
SynthIDは生成・編集時に設計したパターンを入れ、後でその信号を探す。初期の画像方式は共同学習する二つのニューラルネットワークを使用した。一つが目に見えない信号を埋め、もう一つが復元と分類を学ぶ。信号の持続性と画質維持を両立する必要がある。
動画では消せる隅のラベルではなく、フレーム全体に透かしを広げる。音声では耳に聞こえないパターンを使い、LyriaやNotebookLMの音声機能の出力も対象となる。Googleは通常の圧縮、雑音の追加、再生速度の変更後も音声の印を検出できる場合があるとしている。
画像については、一般的な切り抜き、色・明るさ調整、フィルター、非可逆圧縮への耐性を説明する。それはあらゆる変換に耐える保証ではない。画面録画やカメラによる再撮影は、元の画素、音声、メタデータの構造を別ファイルで置き換える可能性がある。
文章は別の方式で、トークンの選択確率をわずかに変え、統計的パターンを作る。Googleの研究では、短文や大幅に書き換えた文章より、長く多様な文章で検出しやすい。この背景は名称を理解する助けになるが、公開ポータルの対象範囲を広げるものではない。
一方、鑑識型の分類器は印を必要とせず、統計・視覚的特徴から合成由来を推測する。未知の生成元にも適用を試みられるが、結果は確率的だ。通常編集で誤検出が起き、生成器の変化で見逃すこともある。SynthIDの主張は、対応信号を復元できるかという、より狭いものだ。
通常編集への耐性は攻撃への保証ではない
未検出でも、非対応の生成、激しい加工、意図的な除去、人による制作の可能性が残る。これは信号復元についての回答であり、何らかのAIがファイルに関わったかという広い問いへの回答ではない。
査読付きのNeurIPS研究は、生成的な再構成により、有用な画質を残しながら複数の画素レベル透かし方式で検出を減らせると報告した。ただし、それらの攻撃すべてが現在のGoogle実装を破ると証明したわけではない。すべての透かしが無意味だとも、現行方式が攻撃不能だとも結論できない。
報道判断、懲戒、詐欺調査に影響するなら、誤検出は別途慎重に調べる必要がある。Googleは全提携先、形式、変換、実際のアップロード経路を網羅する一つの精度値を公開していない。導入総数や日々の依頼数は、その証拠不足を補えない。
独立試験では、通常の拡大縮小、再圧縮、変換、プラットフォーム処理と、意図的な除去を区別すべきだ。異なる脅威を一つの精度見出しにまとめると、何を確実に行えるかが見えなくなる。提携先ごとの実装や製品対象も、推測ではなく資料が必要だ。
来歴は透かしを補えても真実を保証しない
C2PAのContent Credentialsは別の層を提供する。撮影、生成、編集、署名者についての署名付き主張であり、価値は身元と信頼の管理に左右される。透かしはメディアデータ内を移動し、資格情報は履歴を説明できる。どちらもスクリーンショット、非対応の書き出し、配信側の変換で失われうる。
Metaのラベル方式はC2PAとIPTCの機械可読情報に独自信号を組み合わせる。MicrosoftとAdobeも来歴方式を支援する。これは唯一の完全な真偽判定を競うのではなく、埋め込み型の印を補完できる方法だ。
原本、出典URL、公開時刻、資格情報、確認時の文脈を残せば、後日の結果解釈が容易になる。出典調査、画像の逆検索、目撃者の確認は、透かしでは解けない問いに答えられる。実写写真にも偽の日付や場所を添えられる一方、AIの教育用シミュレーションは適切に明示され、無害な場合がある。
今回改善されるのは出自の証拠へのアクセスであり、真実を判定する機械へのアクセスではない。実用性は明確な対応記録、外部評価、流通中に信号を残す仕組みに左右される。SynthIDの検出は出自の問いを絞り込み、未検出はその問いを未解決のまま残す。