
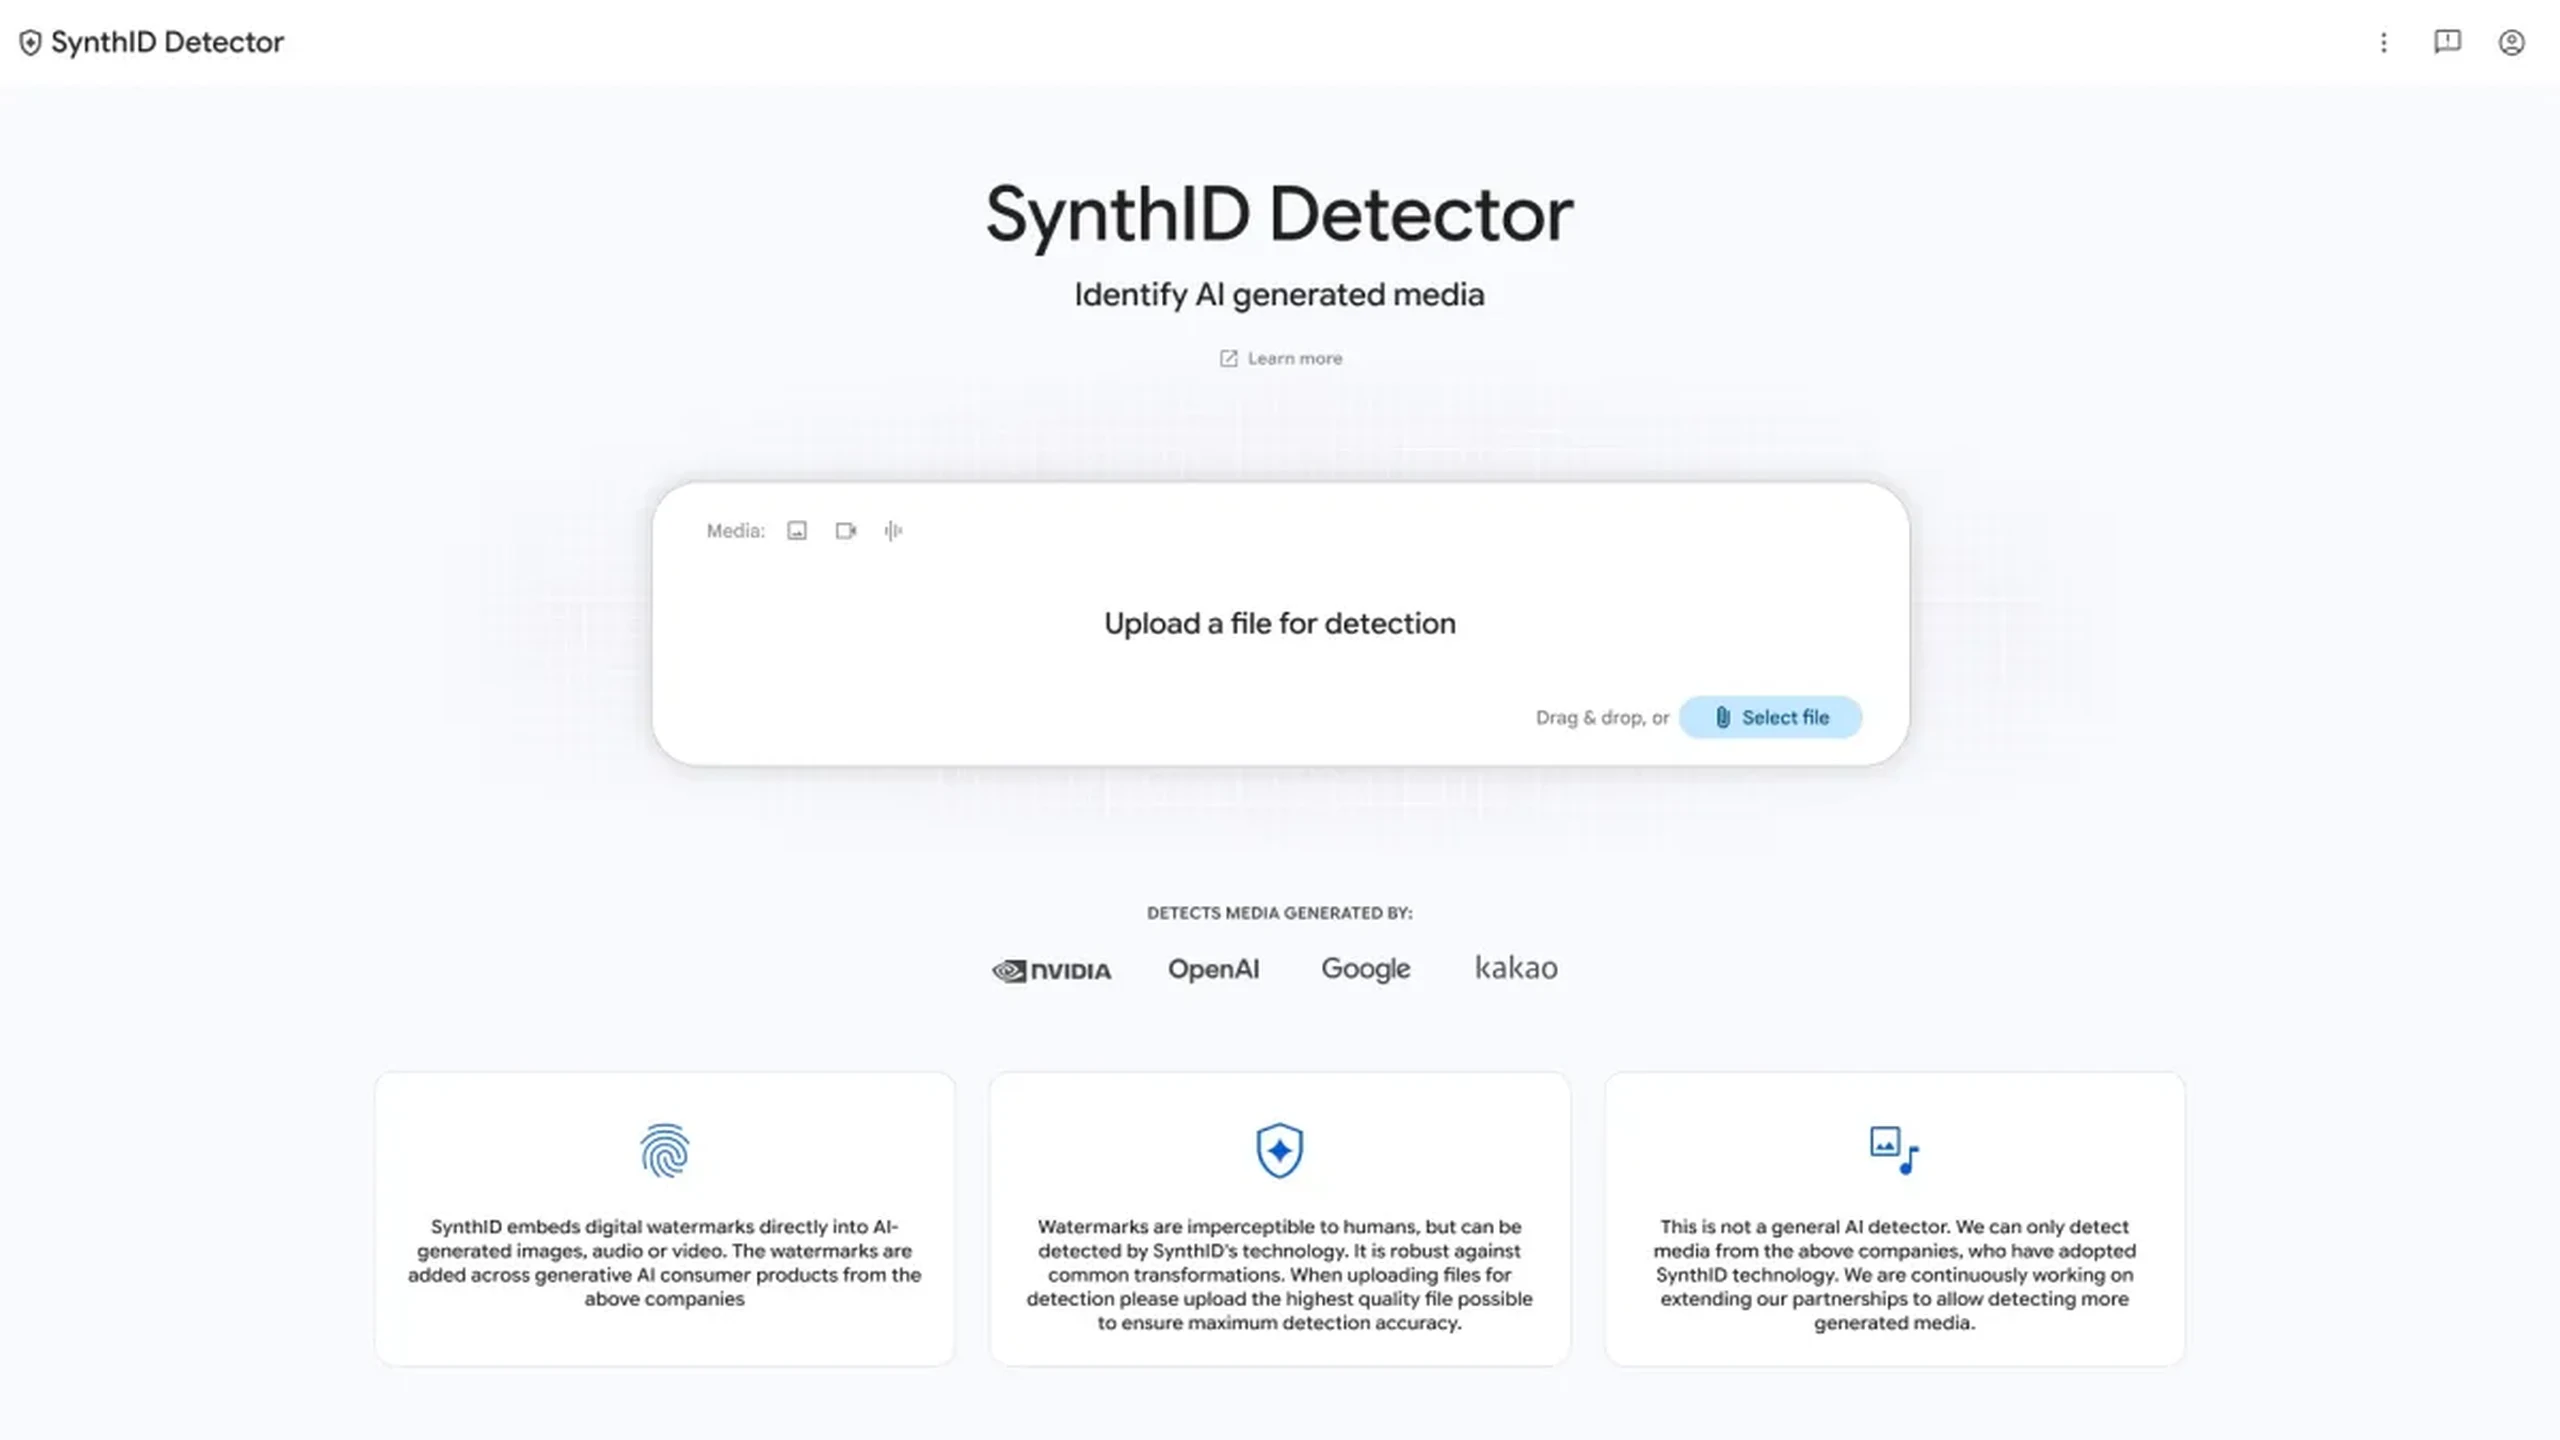
Googles öffentlicher SynthID Detector ermöglicht es allen, direkt zu prüfen, ob ein Bild, Video oder eine Audiodatei das unsichtbare Wasserzeichen eines teilnehmenden Generators enthält. Neu ist vor allem der Zugang: Das zuvor ausgewählten Journalisten, Forschern und Medienfachleuten vorbehaltene Werkzeug hat nun eine weltweit erreichbare englischsprachige Website.
Auch das aussagekräftigste Ergebnis hat eine Grenze. Ein wiedergefundenes Zeichen belegt einen kompatiblen Erzeugungs- oder Bearbeitungsprozess, nicht die Unwahrheit der dargestellten Behauptung. Ein fehlendes Zeichen beweist keine menschliche Urheberschaft. Die Freigabe erweitert ein nützliches Prüfnetz, macht es aber nicht zum universellen Detektor.
Von der begrenzten Vorschau zum Datei-Upload
Google stellte das Portal im Mai 2025 auf der I/O vor. Ohne Warteliste gibt es jetzt einen eigenständigen Ablauf außerhalb von Gemini, Search und Chrome, die Prüfungen bereits integrieren. Nach Unternehmensangaben bearbeiten diese integrierten Werkzeuge täglich mehr als eine Million Prüfanfragen. Ein früherer Bericht nannte fünfzig Millionen Nutzungen vor der Zugangserweiterung in Search und Chrome.
Die Website akzeptiert Bilder als JPG/JPEG, PNG, BMP, WEBP, AVIF, HEIC/HEIF, TIFF/TIF und GIF; Videos als MP4, MOV und WEBM; Audio als WAV, MP3, OGG, FLAC, AAC und M4A. Sie kann markierte Bereiche oder Zeitabschnitte lokalisieren, statt nur der ganzen Datei ein undifferenziertes Etikett zu geben.
Das ist bei gemischten Medien wichtig. Ein konventionell aufgenommenes Video kann erzeugte Sprache enthalten, ein bearbeitetes Bild markierte und unmarkierte Bereiche. SynthID in einem Audioabschnitt beweist nicht, dass auch die Bildspur generiert wurde. Ebenso wenig belegt das Ergebnis die Zustimmung eines Sprechers, eine korrekte Bildunterschrift oder das tatsächliche Geschehen.
Die Website prüft Medien und ist kein universeller Detektor für KI-Texte. Google verfügt auch über eine Textwasserzeichen-Technik. Daraus folgt aber nicht, dass dieser Upload-Ablauf für Bilder, Videos und Audio beliebige Texte bewertet.
Größenordnung und Partnerschaften erklären den Zeitpunkt
Google zufolge wurden mehr als 180 Milliarden Bilder und Videos sowie Audio im Umfang von 240.000 Jahren markiert. Das sind Unternehmenszahlen zur Verbreitung, keine unabhängigen Messungen von Genauigkeit, Fehlalarmen oder Angriffsfestigkeit.
Unterstützte Produkte sind Gemini, Flow, Vids und ProducerAI; zu den Modellfamilien gehören Nano Banana, Veo und Lyria. Das ursprüngliche Bildsystem erschien im August 2023 über Imagen auf Vertex AI und wurde anschließend auf weitere Modalitäten ausgeweitet.
Laut Google unterstützen OpenAI, Nvidia und Kakao SynthID für relevante Ausgaben. Apple soll später folgen; diese Teilnahme ist noch keine ausgelieferte Fähigkeit. Ein Partnername allein belegt nicht, dass jedes Produkt, jede Modellversion und jeder Exportweg abgedeckt ist.
Die Erweiterung folgt auch Googles Ankündigung vom August: Nutzer können bei einigen generierten Bildern, Videos und Liedern sichtbare Zeichen entfernen, während unsichtbares SynthID und C2PA-Metadaten erhalten bleiben. Optisch sauberere Ausgaben verlagern die Herkunftserklärung auf maschinenlesbare Belege. Ein öffentlicher Leser dafür wird wichtiger, wenn kein auffälliges Etikett vorhanden ist.
Unternehmensübergreifende Beteiligung erhöht die Reichweite, doch die Übernahme der Technik bleibt Voraussetzung. Nicht unterstützte Generatoren, veränderte Pipelines offener Modelle und Exporte ohne Signalerhalt hinterlassen erhebliche Lücken. Die Zahl markierter Dateien lässt sich nicht in einen Anteil aller synthetischen Medien umrechnen.
Ein eingebettetes Signal ist keine Vermutung nach Aussehen
SynthID fügt bei Erzeugung oder Bearbeitung ein geplantes Muster ein und sucht später danach. Die ursprüngliche Bildimplementierung verwendete zwei gemeinsam trainierte neuronale Netze: Eines bettete das unmerkliche Signal ein, das andere lernte Wiedergewinnung und Klassifizierung. Beständigkeit und Bildqualität mussten miteinander vereinbart werden.
Bei Video erstreckt sich das Wasserzeichen über Frames, statt als entfernbares Ecketikett zu dienen. Audio verwendet unhörbare Muster, etwa in Ausgaben von Lyria und den Audiofunktionen von NotebookLM. Google zufolge können normale Kompression, zusätzliches Rauschen und verändertes Abspieltempo die Audiomarkierung erkennbar lassen.
Für Bilder beschreibt das Unternehmen Widerstandsfähigkeit gegen üblichen Zuschnitt, Farb- und Helligkeitsänderungen, Filter und verlustbehaftete Kompression. Das garantiert kein Überleben jeder Transformation. Bildschirmaufnahmen oder erneutes Abfilmen können ursprüngliche Pixel-, Ton- und Metadatenstrukturen durch eine neue Datei ersetzen.
Text nutzt ein anderes Verfahren: leicht veränderte Wahrscheinlichkeiten bei der Tokenauswahl erzeugen ein statistisches Muster. Googles Forschung zufolge funktioniert die Erkennung bei längeren, abwechslungsreichen Passagen besser als bei kurzen oder stark umgeschriebenen Texten. Das erklärt den gemeinsamen Namen, erweitert aber nicht den Umfang des öffentlichen Portals.
Ein forensischer Klassifikator schätzt dagegen anhand statistischer oder visueller Merkmale eine synthetische Herkunft, ohne ein vorher eingefügtes Zeichen zu benötigen. Er kann unbekannte Quellen untersuchen, doch seine Schlüsse sind probabilistisch. Normale Bearbeitung kann Fehlalarme erzeugen, veränderte Generatoren können unerkannt bleiben. SynthIDs Aussage ist enger: Lässt sich sein kompatibles Signal wiedergewinnen?
Alltagsfestigkeit ist keine Garantie gegen Angriffe
Ein negatives Ergebnis lässt nicht unterstützte Erzeugung, starke Verarbeitung, absichtliche Entfernung und menschliche Erstellung offen. Es beantwortet eine Frage zur Signalwiedergewinnung, nicht die umfassendere Frage nach irgendeiner KI-Beteiligung.
Eine begutachtete NeurIPS-Studie zeigte, dass generative Rekonstruktion die Erkennung mehrerer pixelbasierter Wasserzeichensysteme bei brauchbarer Bildqualität verringern konnte. Sie bewies nicht, dass jeder solche Angriff Googles aktuelle Implementierung überwindet. Daraus folgt weder die Wertlosigkeit aller Wasserzeichen noch die Unangreifbarkeit des heutigen Systems.
Fehlalarme verdienen eine gesonderte Prüfung, wenn ein Ergebnis redaktionelle Entscheidungen, Disziplinarverfahren oder Betrugsermittlungen beeinflusst. Google hat keinen einzelnen öffentlichen Genauigkeitswert für sämtliche Partner, Formate, Transformationen und realen Upload-Wege veröffentlicht. Verbreitungszahlen und tägliche Anfragen schließen diese Beweislücke nicht.
Unabhängige Tests sollten gewöhnliche Größenänderung, Neukompression, Transkodierung und Plattformverarbeitung von gezielten Entfernungsversuchen trennen. Ein gemeinsamer Genauigkeitswert für verschiedene Bedrohungen würde verdecken, was zuverlässig funktioniert. Auch partnerspezifische Implementierungen und Produktabdeckung brauchen Dokumentation statt Annahmen.
Herkunftsbelege ergänzen Wasserzeichen, zertifizieren aber keine Wahrheit
C2PA Content Credentials liefern eine weitere Ebene: signierte Aussagen zu Aufnahme, Erzeugung, Bearbeitung und Unterzeichnern, abhängig von Identitäts- und Vertrauenskontrollen. Das Wasserzeichen reist in den Mediendaten; ein Nachweis kann die Geschichte beschreiben. Beide können durch Screenshots, nicht unterstützte Exporte oder Plattformtransformationen verloren gehen.
Metas Kennzeichnung kombiniert maschinenlesbare C2PA- und IPTC-Informationen mit eigenen Signalen. Microsoft und Adobe unterstützen ebenfalls Herkunftssysteme. Diese Ansätze können eingebettete Zeichen ergänzen, statt um ein einziges vollständiges Echtheitsurteil zu konkurrieren.
Originaldateien, Quell-URLs, Veröffentlichungszeitpunkte, Nachweise und der Kontext einer Prüfung erleichtern die spätere Interpretation. Quellenrecherche, umgekehrte Bildsuche und Augenzeugenbestätigung beantworten Fragen, die das Wasserzeichen nicht klärt. Ein echtes Foto kann mit falschem Datum oder Ort versehen werden; eine gekennzeichnete KI-Lernsimulation kann harmlos sein.
Die Freigabe verbessert somit den Zugang zu Herkunftsbelegen, nicht zu einer Maschine, die Wahrheit entscheidet. Ihr Wert hängt von klaren Kompatibilitätsunterlagen, externen Tests und signalerhaltenden Plattformen ab. Ein positives Ergebnis grenzt die Herkunftsfrage ein; ein negatives hält sie offen.