
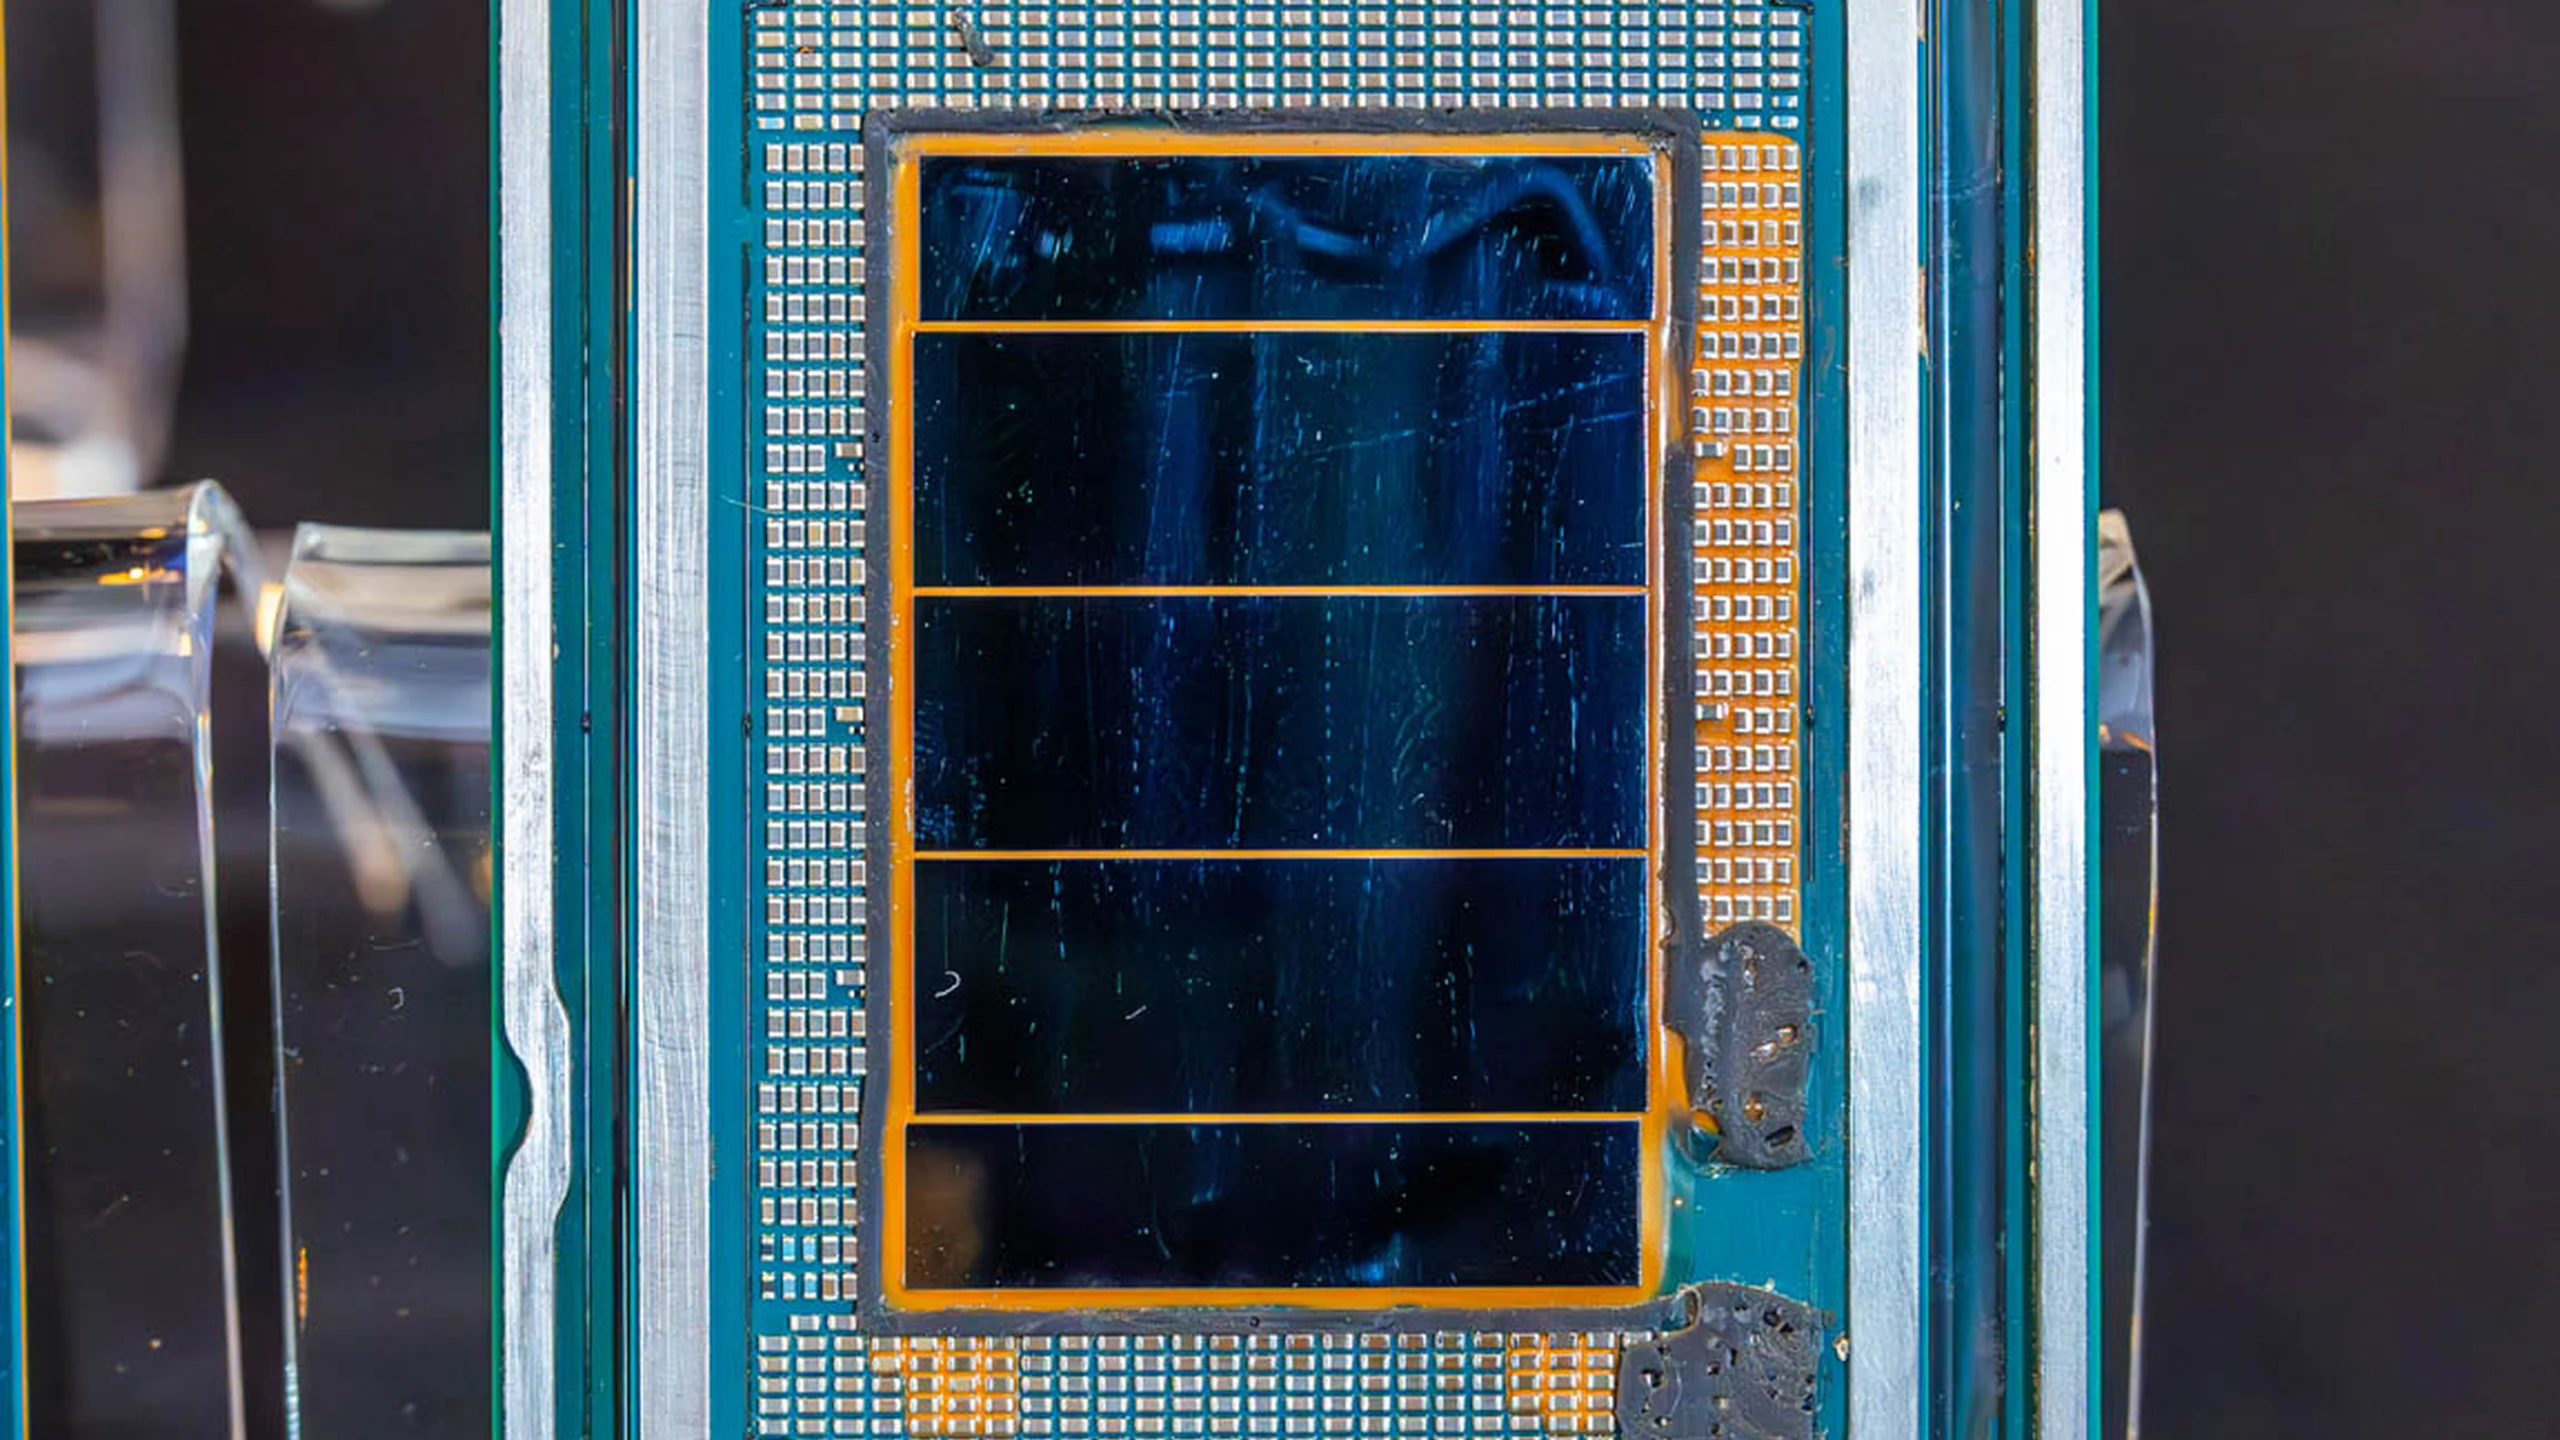
Intels breiterer Rollout von Xeon 6+ Clearwater Forest bringt einen Fertigungsmeilenstein zu mehr Serverkäufern. Die Familie startete im zweiten Quartal 2026; ServeTheHome berichtet von anschließendem Produktionswachstum über die ersten Hyperscale-Kunden hinaus. Vier Modelle decken 144–288 Effizienzkerne ab, doch das Flaggschiff ist nicht automatisch der beste Kauf. Gemeinsame Plattformressourcen bedeuten, dass zusätzliche Kerne auch Bandbreite, Cache und Leistungsbudget je Kern verändern.
Die SKU-Analyse von ServeTheHome stellt deshalb eine nützlichere Frage als die nach der größten Zahl: Skaliert die Anwendung über Hunderte unabhängige Kerne, oder enden Speicherbandbreite, Lizenzbudget und Latenzspielraum früher? Davon hängt ab, ob Intels Dichte- und Fertigungsargument zu einem Betriebskostenvorteil wird.
Eine Plattform, vier Ressourcenverteilungen
Intels Clearwater-Forest-Katalog nennt für den 6990E+ 288 Kerne, 576MB Cache und 450W TDP; für den 6980E+ 264 Kerne, 528MB und 400W; für den 6970E+ 192 Kerne, 480MB und 400W; für den 6960E+ 144 Kerne, 432MB und 330W. Das sind ausgewiesene Prozessorbudgets, keine Steckdosenmessungen eines ausgelasteten Servers.
Alle Modelle nutzen E-Cores und priorisieren Durchsatzdichte und Effizienz gegenüber maximaler Single-Thread-Geschwindigkeit. Sämtliche unterstützen zwei Sockel, zwölf DDR5-Kanäle und 96 PCIe-Lanes. MRDIMM kombiniert Daten zweier Speicherranks für höhere Transferraten, bis DDR5-8000 bei geeigneter Konfiguration. Käufer brauchen das Spitzenmodell nicht allein für diese Kanäle, Sockelunterstützung, Beschleuniger oder Energieberichte.
Application Energy Telemetry ist ebenfalls durchgängig verfügbar. Intel beschreibt hardwarebasierte Energiezuordnung zu Workloads, Containern, VMs, Anwendungen und einzelnen Softwarethreads. Das könnte Platzierung und die Erkennung von Energieverbrauch während Speicher- oder I/O-Wartezeiten unterstützen. Eine feinere Zuordnung ersetzt aber keine Messung der Gesamtenergie.
Das Fertigungsdesign ist eigenständig bedeutsam. Clearwater Forest ist Intels erster Rechenzentrumsprozessor mit 18A-Compute-Tiles, RibbonFET und rückseitiger Stromversorgung. Foveros Direct verbindet gestapeltes Silizium dicht. Das Paket enthält zwölf Compute-Tiles, drei aktive Basistiles, zwei I/O-Tiles und zwölf eingebettete Verbindungsbrücken. Volumenerfahrung kann spätere Designs stützen; kontinuierliche Verfügbarkeit statt Prozessname belegt die Fertigungsumsetzung.
Weniger Kerne können mehr Ressourcen je Thread bedeuten
Der 6990E+ hat 2MB Last-Level-Cache je Kern, der 6970E+ 2,5MB und der 6960E+ 3MB. Der 6980E+ behält bei 264 statt 288 Kernen 2MB. Die unteren Modelle unterscheiden sich daher nicht nur in Gesamtrechenleistung: Software, die nicht sauber auf 288 Kerne skaliert, erhält mehr unterstützende Ressourcen pro Kern.
Unter der Annahme von zwölf DDR5-8000-MRDIMM-Kanälen beträgt die theoretische Bandbreite je Kern ungefähr 2,67GB/s beim Flaggschiff und 5,34GB/s beim 144-Kerner. Halbierte Kernzahl verdoppelt die rechnerische Zuteilung ohne anderes Speichersystem. Sie verspricht keine doppelte Anwendungsgeschwindigkeit. Zugriffsmuster, Compiler, Datenplatzierung und nichtuniformer Zugriff verändern nutzbare Bandbreite und Konkurrenz.
Auch der Takt unterscheidet sich. Das obere Paar hat maximal 3,2GHz Turbo; der 6970E+ beginnt bei 2,3GHz, der 6960E+ bei 2,4GHz. ServeTheHome berichtet 3,0GHz All-Core-Turbo des 144-Kerners bei ausgewiesener Leistung. Maximaler Turbo bei wenigen Kernen ist nicht der Dauerwert Hunderter ausgelasteter Kerne. Der 6960E+ übernimmt die 144 Kerne des vorherigen Sierra-Forest-Spitzenmodells, erhöht aber den Cache auf 432MB.
Das sind Ansatzpunkte, keine bewiesenen Gewinner jeder Anwendung. Zustandslose Webdienste, Content Delivery, Microservices, leichte Container und dichte VMs können den Parallelpool oben nutzen. Speicherempfindliche Datenbanken, Analysen, Netzverarbeitung und unvollständig skalierende Dienste könnten den 6960E+ bevorzugen. Der 192-Kern-6970E+ bietet ein Drittel mehr Kerne als 144 und mehr Cache je Kern als das Flaggschiff. Der 264-Kern-6980E+ hängt stärker von oberen Leistungsgrenzen, Verfügbarkeit und Workload-Verhalten ab.
Leistungsprofile ändern den Vergleich, nicht die Energiefrage
Intel Speed Select Technology ermöglicht unterstützten Teilen definierte Leistungsprofile. Beide oberen Modelle haben reduzierte Konfigurationen. Der 6990E+ kann von 450W auf 330W wechseln; der berichtete All-Core-Turbo fällt von 2,8 auf 2,4GHz, ungefähr 14% weniger Frequenz und 27% weniger TDP. Derselbe Chip kann ohne Neukauf maximalen Durchsatz oder ein engeres Sockelbudget bedienen.
Bei 330W ergibt das ungefähr 1,15 ausgewiesene Watt je Kern für 288 Kerne, beim reduzierten 6980E+ etwa 1,14W. Der 144-Kern-6960E+ verteilt seine 330W dagegen auf halb so viele Kerne und lässt mehr Taktspielraum. Niedrige Watt/Kern fördern Dichte, höhere Taktraten können schlecht skalierende Arbeit früher beenden. Keiner der Werte misst erledigte Arbeit je Kilowattstunde.
Speicher, Laufwerke, Netzwerk, Kühlung, Spannungsregelung und Leerlauf tragen zum Verbrauch bei. Langsamere Aufgaben können insgesamt mehr Energie kosten, wenn längere Laufzeit die geringere Momentanleistung überwiegt. Strom- oder kühlungsbegrenzte Standorte brauchen deshalb Gesamtmessungen. Mehr Kerne helfen nicht, wenn Rack-Strom und Kühlung die produktive Nutzung nicht ermöglichen.
Intels von ServeTheHome besprochene Startangaben umfassten durchschnittlich 2,26-fache Leistung und 55% mehr Leistung/W gegenüber dem 144-Kern-Xeon 6780E. Das neue Flaggschiff verdoppelt Kerne und erhöht die Leistungsgrenze; der Gesamtgewinn ist kein gleicher Sprung je Kern. Ausgewählte Telekomvergleiche nannten bis 38% weniger Rack-Leistung und über 60% mehr Leistung/W. Alles sind Intel-ausgewählte Workloads und Konfigurationen, keine unabhängigen Belege für jeden Einsatz.
Dichteprämien treffen auf Lizenzen und Fehlerdomänen
Weniger physische Systeme für ein Durchsatzziel können doppelte Netzwerk-, Verwaltungs- und Rackkosten senken. Gleichzeitig konzentrieren sie Ausfallrisiken: Ein dichter Knoten nimmt bei Ausfall mehr Kapazität mit. Planung, Redundanz und Wiederherstellung müssen dazu passen. Latenzanforderungen können reduzierte Frequenz unattraktiv machen, selbst wenn der mittlere Durchsatz reicht.
Der 6960E+ hat in Intels öffentlicher Listenpositionierung den niedrigsten CPU-Anschaffungspreis und den besten Kernwert, die oberen Varianten verlangen eine Dichteprämie. Ein konkreter Marktpreisvorteil folgt daraus nicht. Prozessoren sind nur ein Teil: RAM, Gehäuse, Mainboard, Netzwerkkarten, Speicher, Netzteile, Kühlung, Software, Support und Betriebspersonal können den teureren Chip wirtschaftlich machen, wenn er doppelte Systeme vermeidet.
Softwarelizenzen können das umkehren. Sockelverträge belohnen Dichte; Kernlizenzen zählen möglicherweise jeden aktivierten Kern, produktiv oder ungenutzt. Virtualisierungs- und Datenbankverträge brauchen Einzelprüfung. Rechenleistung, Bandbreite, Kapazität, Storage, Netzwerk oder Lizenzen können begrenzen; eine Kernrangliste bestimmt keinen Gesamtwert.
Repräsentative Tests sollten erledigte Arbeit, Dauertakt und Tail-Latenz bei mehreren Auslastungen sowie Package-, Speicher- und Gesamtenergie messen. Bei Cloud-Reserven für Spitzen und Serviceziele kann 40% Auslastung wichtiger als der Spitzenwert sein. AET hilft womöglich bei der Zuordnung, doch günstige Thread- oder Kernstatistiken bleiben nur ein Teil der Entscheidung.
AMD und Arm zeigen Benchmark-Lücken
Gegenüber AMD EPYC 9965 beansprucht Intel etwa 30% höhere durchschnittliche Thread-Leistung und einen ähnlichen Vorteil je Thread und Watt. AMD nutzt 192 Zen-5-Kerne mit SMT für 384 Threads; Clearwater Forest hat 288 physische E-Cores und 288 Threads ohne SMT. Der Thread ist folglich nicht dieselbe Ressourceneinheit beider Designs.
Tom’s Hardwares Startbericht verwies auf den fehlenden breiten Gesamtsockelvergleich. Thread-Ergebnisse können VM-Größe, Lizenzierung und Latenz informieren, beweisen aber nicht mehr Arbeit je Sockel. SMT kann Auslastung verbessern und teilt dabei Kernressourcen. Getrennte E-Cores könnten bei manchen vCPU-zu-physischem-Kern-Zuordnungen berechenbarer arbeiten. Keines gewinnt überall.
Xeon 6+ unterstützt AVX2, nicht AVX-512 oder AVX10; wissenschaftliche Simulation, HPC und manche vektorlastige Medien- oder Analysejobs passen daher weniger natürlich. Intel bietet stattdessen Beschleuniger für Kompression, Kryptografie, Datenbewegung, Lastverteilung und In-Memory-Analyse. Software muss sie verwenden. Große ausgewählte SHA- oder SM3-Gewinne lassen sich nicht auf gewöhnlichen Code übertragen.
AWS Graviton, Google Axion, Microsoft Cobalt und das kommerzielle AmpereOne bilden eine weitere Effizienz- und Dichtefront. Intel will Cloud-native-Arbeit auf vertrautem x86 halten, doch Hyperscaler kontrollieren genug Software für andere Befehlssätze und verbinden eigenes Arm mit Beschaffung und Gebäudedesign. Intel erklärt sich für wettbewerbsfähig; breite direkte Arm-Benchmarks fehlten zum Start. Vertrautheit ist ein Vorteil, kein Nachweis niedriger Betriebskosten.
Verfügbarkeit muss Kompatibilität in Belege verwandeln
Die Prozessoren teilen LGA 7529 mit Xeon 6900P. Vorhandene Systeme sollen Xeon 6+ nach Herstellerprüfung per Firmware unterstützen können. Praktische Ersparnisse hängen von Qualifizierung, Kühlung, Stromversorgung, Speichertopologie und Management ab, nicht allein vom Sockelnamen. Mehr OEM-Systeme würden den Schritt über frühe Hyperscale-Installationen bestätigen.
Reproduzierbare unabhängige Tests aller vier Modelle und Profile bleiben der nächste Leistungsnachweis. Dauerhafter Durchsatz, Gesamtleistung, Speicherbestückung und Tail-Latenz gehören zu Cloud-, Datenbank-, Telekom-, VM-, Storage-, Kompressions- und Kryptografieergebnissen. Wie viel Durchsatz das 330W-Flaggschiff behält, ist aussagekräftiger als identische Verluste von Frequenz und Durchsatz zu unterstellen.
Stabile 18A-Lieferung und größere Installationsbasis prüfen außerdem Intels Fertigungserholung und zeigen, welche Software 288 Kerne tatsächlich nutzt. Vorerst gibt es verschiedene Ziele: maximale Sockeldichte oben, 192 Kerne als Mitte und bei 144 mehr Bandbreite, Cache und Takt je Kern. Wert ergibt sich erst gemeinsam aus Anwendungsengpass, Gesamtkosten und unabhängigen Messungen.