
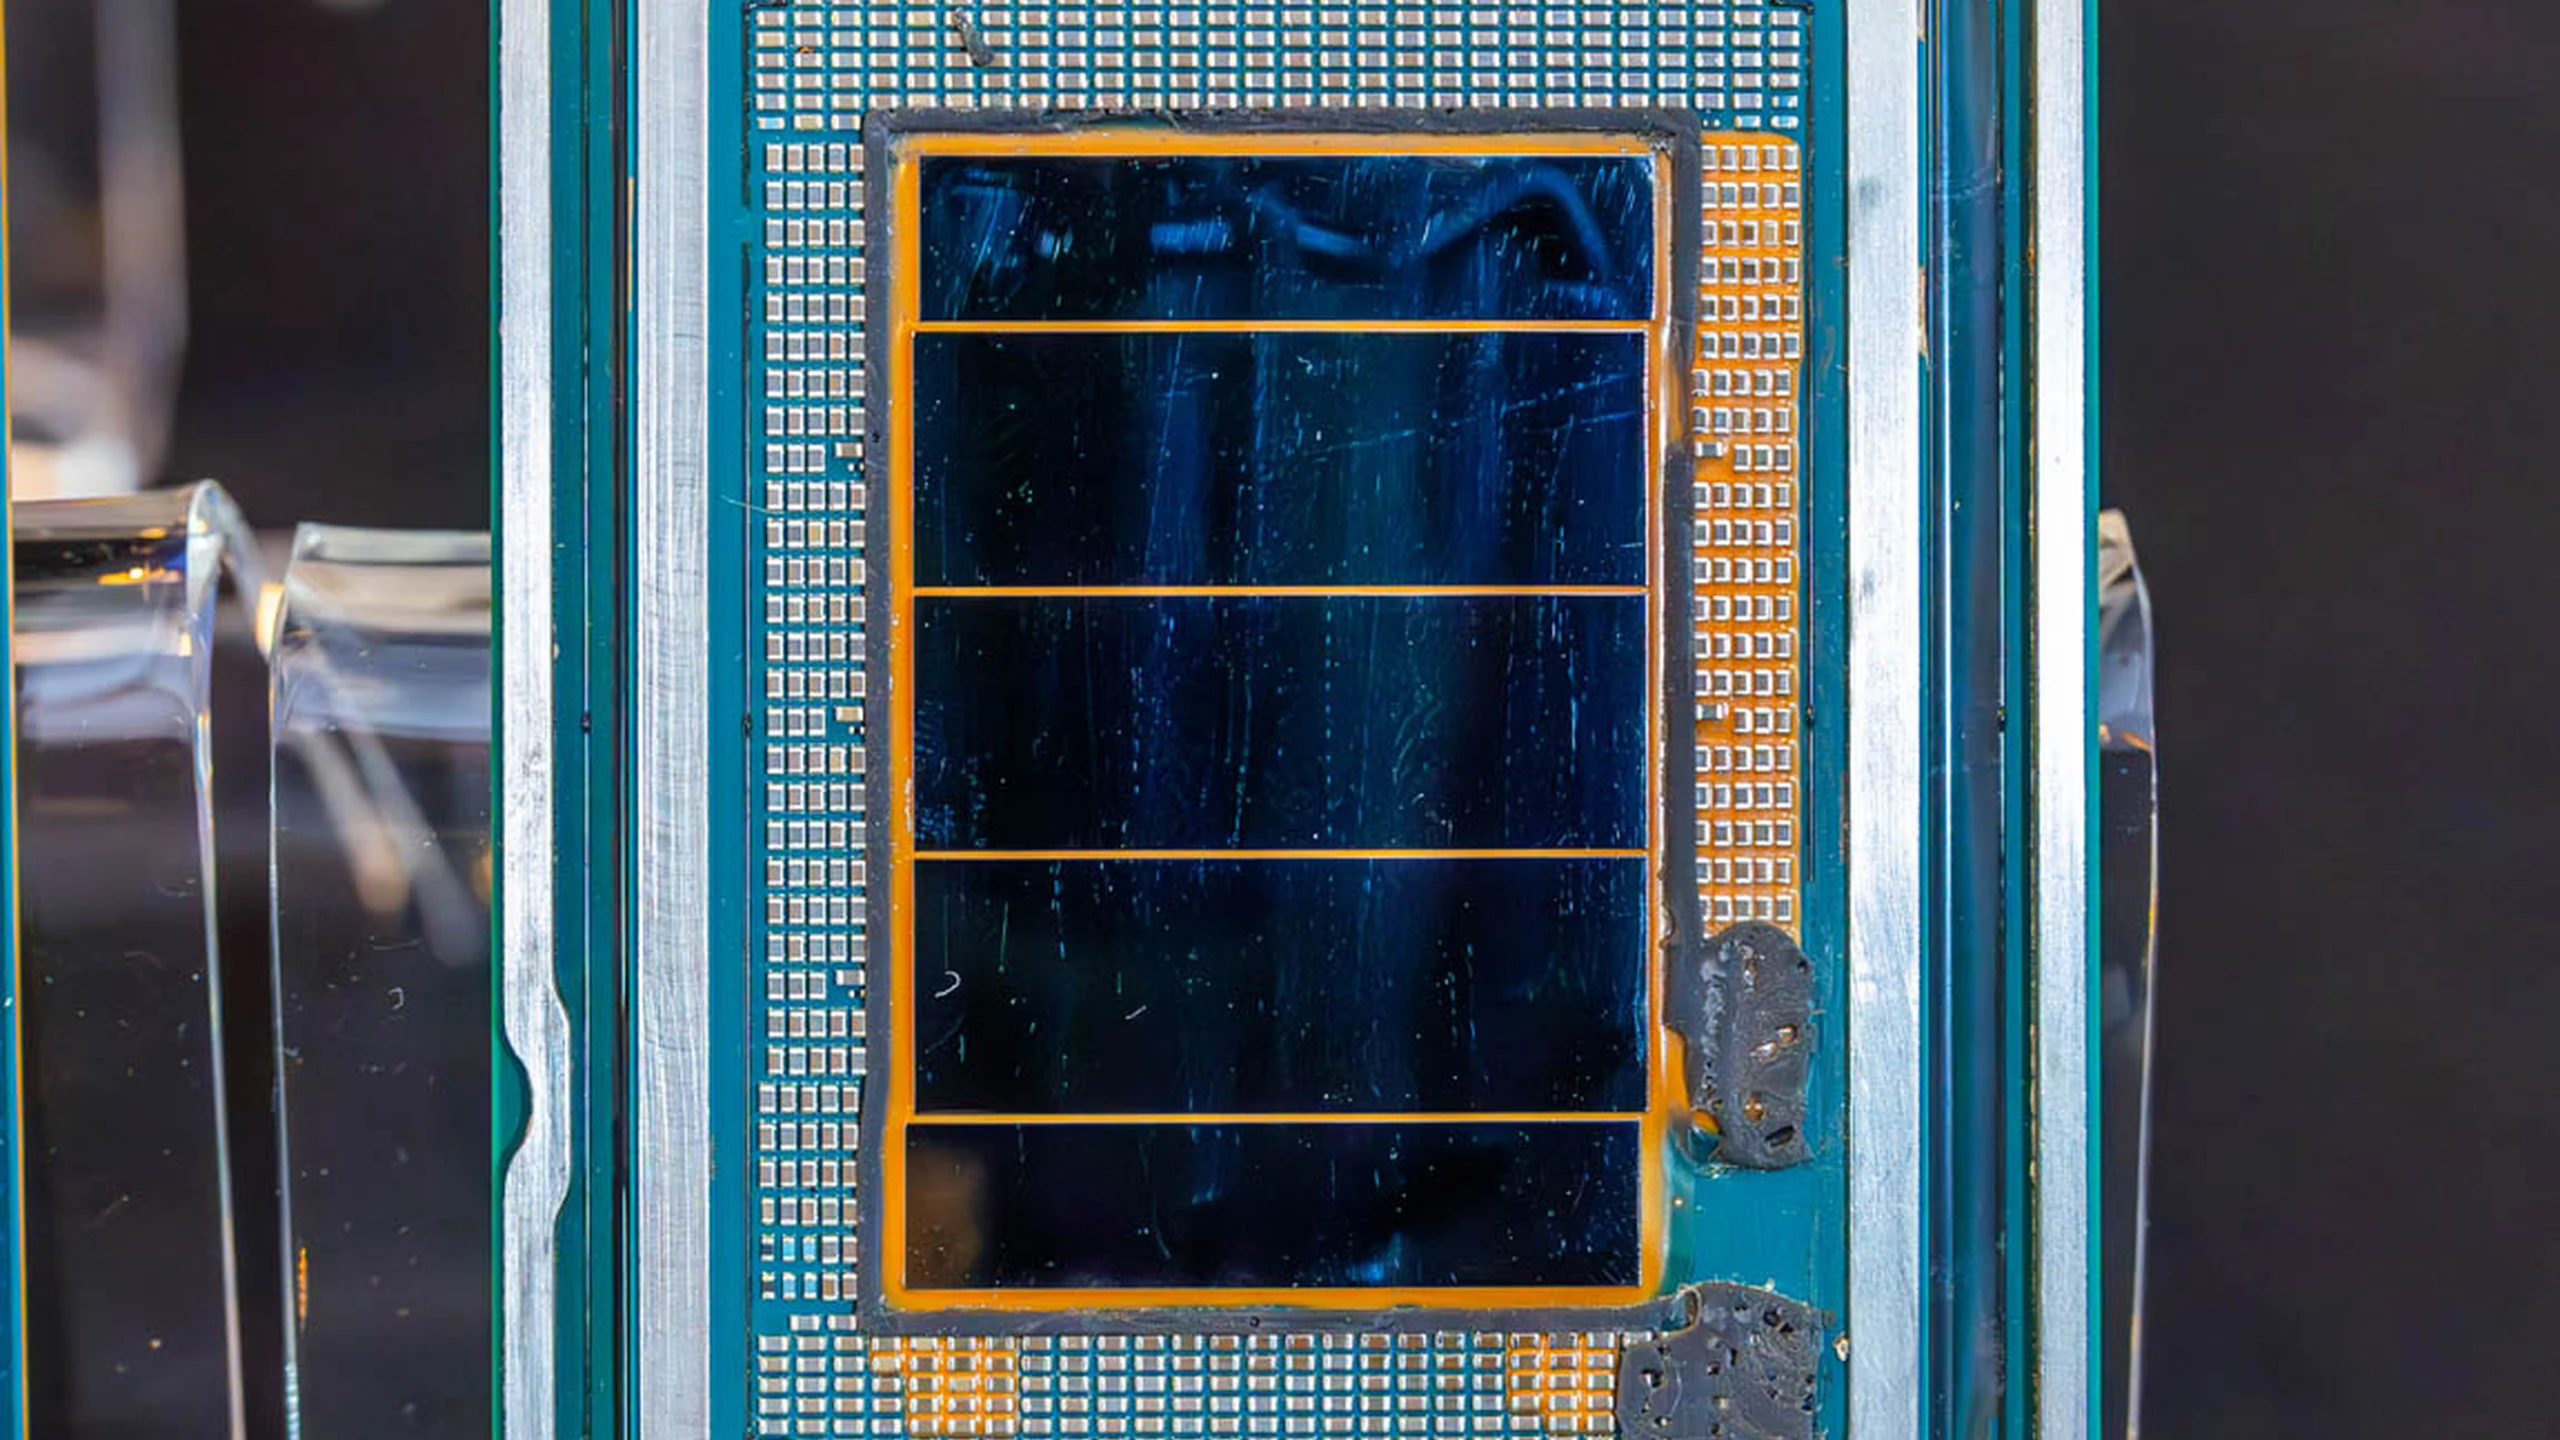
La distribuzione più ampia di Intel Xeon 6+ Clearwater Forest porta un traguardo produttivo a più acquirenti di server. La famiglia è stata lanciata nel secondo trimestre 2026; ServeTheHome riferisce una successiva crescita della produzione oltre i primi clienti hyperscale. Quattro modelli coprono 144–288 core di efficienza, ma il vertice non è automaticamente il miglior acquisto. Risorse condivise della piattaforma significano che aggiungere core cambia anche banda, cache e potenza disponibili per ciascuno.
L’analisi SKU di ServeTheHome pone quindi una domanda più utile del numero maggiore: l’applicazione scala su centinaia di core indipendenti o esaurisce prima banda di memoria, budget di licenze e margine di latenza? La risposta decide anche se la storia di densità e produzione diventa vantaggio operativo.
Una piattaforma, quattro equilibri di risorse
Il catalogo Clearwater Forest Intel indica 6990E+ con 288 core, 576MB cache e TDP 450W; 6980E+ con 264, 528MB e 400W; 6970E+ con 192, 480MB e 400W; 6960E+ con 144, 432MB e 330W. Sono valori dichiarati del processore, non misure alla presa di un server sotto carico.
Tutti usano E-core privilegiando densità di throughput ed efficienza sulla massima velocità single-thread. Tutti supportano due socket, 12 canali DDR5 e 96 linee PCIe. MRDIMM combina dati di due rank per aumentare i trasferimenti, fino a DDR5-8000 in configurazioni appropriate. Il modello più alto non serve solo a sbloccare canali, socket, acceleratori o rapporti energetici.
Application Energy Telemetry è disponibile nell’intera famiglia. Intel descrive attribuzione hardware dell’energia a carichi, container, VM, applicazioni e singoli thread. Può aiutare il posizionamento e rivelare lavori che consumano aspettando memoria o I/O. È attribuzione più dettagliata, non sostituzione della misura energetica totale.
La produzione conta autonomamente. Clearwater Forest è il primo processore da data center Intel con tile di calcolo 18A, RibbonFET e alimentazione posteriore. Foveros Direct collega densamente silicio impilato. Il package impiega 12 tile di calcolo, tre basi attive, due I/O e 12 ponti incorporati. L’esperienza di volume può aiutare i progetti successivi; disponibilità costante, non il nome del processo, dimostrerà l’esecuzione industriale.
Meno core possono offrire più risorse per thread
6990E+ dà 2MB di cache di ultimo livello per core, 6970E+ 2,5MB e 6960E+ 3MB. 6980E+ mantiene 2MB passando da 288 a 264 core. I due inferiori differiscono dunque in più della capacità aggregata: software che non scala bene fino a 288 riceve più risorse di supporto per core.
Assumendo dodici canali DDR5-8000 MRDIMM, la banda teorica per core è circa 2,67GB/s al vertice e 5,34GB/s a 144 core. Dimezzare i core raddoppia l’allocazione aritmetica senza cambiare memoria. Non promette applicazioni due volte più veloci. Accessi, compilatore, posizione dei dati e accesso non uniforme cambiano banda reale e contesa.
Anche la frequenza distingue. La coppia superiore ha turbo massimo 3,2GHz, 6970E+ base 2,3GHz e 6960E+ 2,4GHz. ServeTheHome riporta turbo all-core 3,0GHz per 144 core alla potenza dichiarata. Il massimo con pochi core non è la velocità sostenuta di centinaia occupati. 6960E+ torna ai 144 del precedente vertice Sierra Forest ma porta la cache a 432MB.
Sono punti di partenza, non vincitori di ogni applicazione. Web stateless, distribuzione di contenuti, microservizi, container leggeri e VM dense possono usare il parallelismo del vertice. Database sensibili alla memoria, analisi, rete e servizi con scala imperfetta possono preferire 6960E+. Il 6970E+ da 192 offre un terzo di core in più di 144 e più cache per core del vertice. Il 6980E+ da 264 dipende maggiormente da limiti di potenza superiori, disponibilità e carico.
I profili cambiano il confronto, non rispondono sull’energia
Intel Speed Select Technology offre profili definiti ai modelli compatibili; entrambi i superiori hanno impostazioni ridotte. 6990E+ passa da 450W a 330W, con turbo all-core riportato da 2,8 a 2,4GHz: circa 14% meno frequenza e 27% meno TDP. Senza comprare un’altra CPU, lo stesso chip può privilegiare throughput o un budget socket più stretto.
A 330W, 288 core danno circa 1,15 watt dichiarati per core, il 6980E+ ridotto circa 1,14W. Il 6960E+ da 144 divide 330W su metà dei core, lasciando più margine di clock. Bassi watt per core favoriscono densità; frequenze alte possono finire prima lavori poco scalabili. Nessun rapporto misura lavoro completato per chilowattora.
Memoria, dischi, rete, raffreddamento, regolazione e inattività contribuiscono al consumo reale. Un compito più lento può consumare più energia se la durata aggiuntiva supera la riduzione istantanea di potenza. Impianti limitati da elettricità o calore devono misurare l’intero server. Più core non servono se il rack non sostiene l’utilizzo produttivo con alimentazione e raffreddamento.
Le dichiarazioni di lancio analizzate da ServeTheHome includevano prestazioni medie 2,26 volte maggiori e prestazioni/W migliorate del 55% contro Xeon 6780E da 144 core. Il nuovo vertice raddoppia i core e alza la potenza, dunque il guadagno aggregato non è un salto equivalente per core. Confronti telecom selezionati dichiaravano fino al 38% meno potenza rack e oltre il 60% più prestazioni/W. Sono carichi e configurazioni scelti da Intel, non prove indipendenti per ogni uso.
Il premio di densità incontra licenze e domini di guasto
Consolidare un obiettivo di throughput su meno macchine può ridurre duplicazioni di rete, gestione e spazio. Concentra però i guasti: un nodo denso indisponibile elimina più capacità. Scheduling, ridondanza e ripristino devono corrispondere al dominio maggiore. La latenza richiesta può rendere inadatti profili a basso clock anche se il throughput medio basta.
6960E+ ha il costo CPU più basso e il miglior valore per core nel posizionamento pubblico di listino Intel; i superiori chiedono un premio di densità. Non deriva automaticamente un vantaggio su prezzi reali specifici. La CPU è solo una parte: memoria, chassis, scheda, rete, storage, alimentatori, raffreddamento, software, supporto e personale possono rendere razionale un chip più caro che evita sistemi duplicati.
Le licenze possono capovolgere il risultato. Contratti per socket premiano la densità; quelli per core possono conteggiare tutti gli abilitati, usati o inattivi. VM e database richiedono esami individuali. Calcolo, banda, capacità, storage, rete o licenze possono essere il vincolo; una classifica di core non stabilisce il valore totale.
Test rappresentativi devono misurare lavoro, frequenza sostenuta e latenza di coda a vari utilizzi, insieme a energia di package, memoria e server. Con riserve cloud per picchi e obiettivi di servizio, il 40% d’uso può contare più del massimo. AET può attribuire i modelli operativi, ma statistiche favorevoli per thread o core restano una parte della scelta.
AMD e Arm mostrano lacune dei benchmark
Contro AMD EPYC 9965, Intel dichiara prestazioni medie per thread circa 30% superiori e un vantaggio analogo per thread per watt. AMD ha 192 Zen 5 con SMT per 384 thread; Clearwater Forest ha 288 E-core fisici e 288 thread senza SMT. Il thread non è quindi la stessa unità di risorse nei due design.
La copertura di lancio Tom’s Hardware segnalava l’assenza di un ampio confronto aggregato per socket. I risultati per thread aiutano dimensionamento VM, licenze e latenza, ma non provano quale socket completi più lavoro. SMT migliora l’utilizzo condividendo risorse; E-core separati possono essere più prevedibili in certi abbinamenti vCPU–core fisico. Nessuno vince ogni carico.
Xeon 6+ supporta AVX2, non AVX-512 o AVX10, limitando la naturale adozione in simulazione, HPC e alcuni media o analisi vettoriali. Intel offre acceleratori di compressione, crittografia, movimento dati, bilanciamento e analisi in memoria. Il software deve usarli. Grandi guadagni selezionati SHA o SM3 non si generalizzano al normale codice.
AWS Graviton, Google Axion, Microsoft Cobalt e il commerciale AmpereOne creano un altro fronte di efficienza e densità. Intel vuole conservare cloud-native sul familiare x86, ma gli hyperscaler controllano abbastanza software per altri set di istruzioni e integrano Arm proprio con acquisti e strutture. Intel afferma di essere competitiva, ma al lancio mancavano ampi confronti diretti Arm. Familiarità è un vantaggio, non prova di costi inferiori.
La disponibilità deve trasformare compatibilità in evidenza
I processori condividono LGA 7529 con Xeon 6900P. I sistemi esistenti possono, secondo i resoconti, supportare Xeon 6+ via firmware dopo validazione del fornitore. Il risparmio dipende da qualifica, raffreddamento, alimentazione, topologia di memoria e gestione, non solo dal socket. Più sistemi OEM confermerebbero l’espansione oltre i primi hyperscaler.
Restano necessari test indipendenti riproducibili dei quattro modelli e dei profili. Throughput sostenuto, potenza totale, memoria installata e latenza di coda devono accompagnare risultati cloud, database, telecom, VM, storage, compressione e crittografia. Quanto lavoro conserva il vertice 330W conta più che supporre cali uguali di frequenza e throughput.
Fornitura 18A stabile e base installata ampia verificheranno anche la ripresa industriale e mostreranno il software che usa davvero 288 core. Per ora la gamma offre obiettivi diversi: massima densità in alto, compromesso da 192 e più banda, cache e clock per core con 144. Il valore emerge soltanto unendo vincolo applicativo, costi completi e misure indipendenti.