
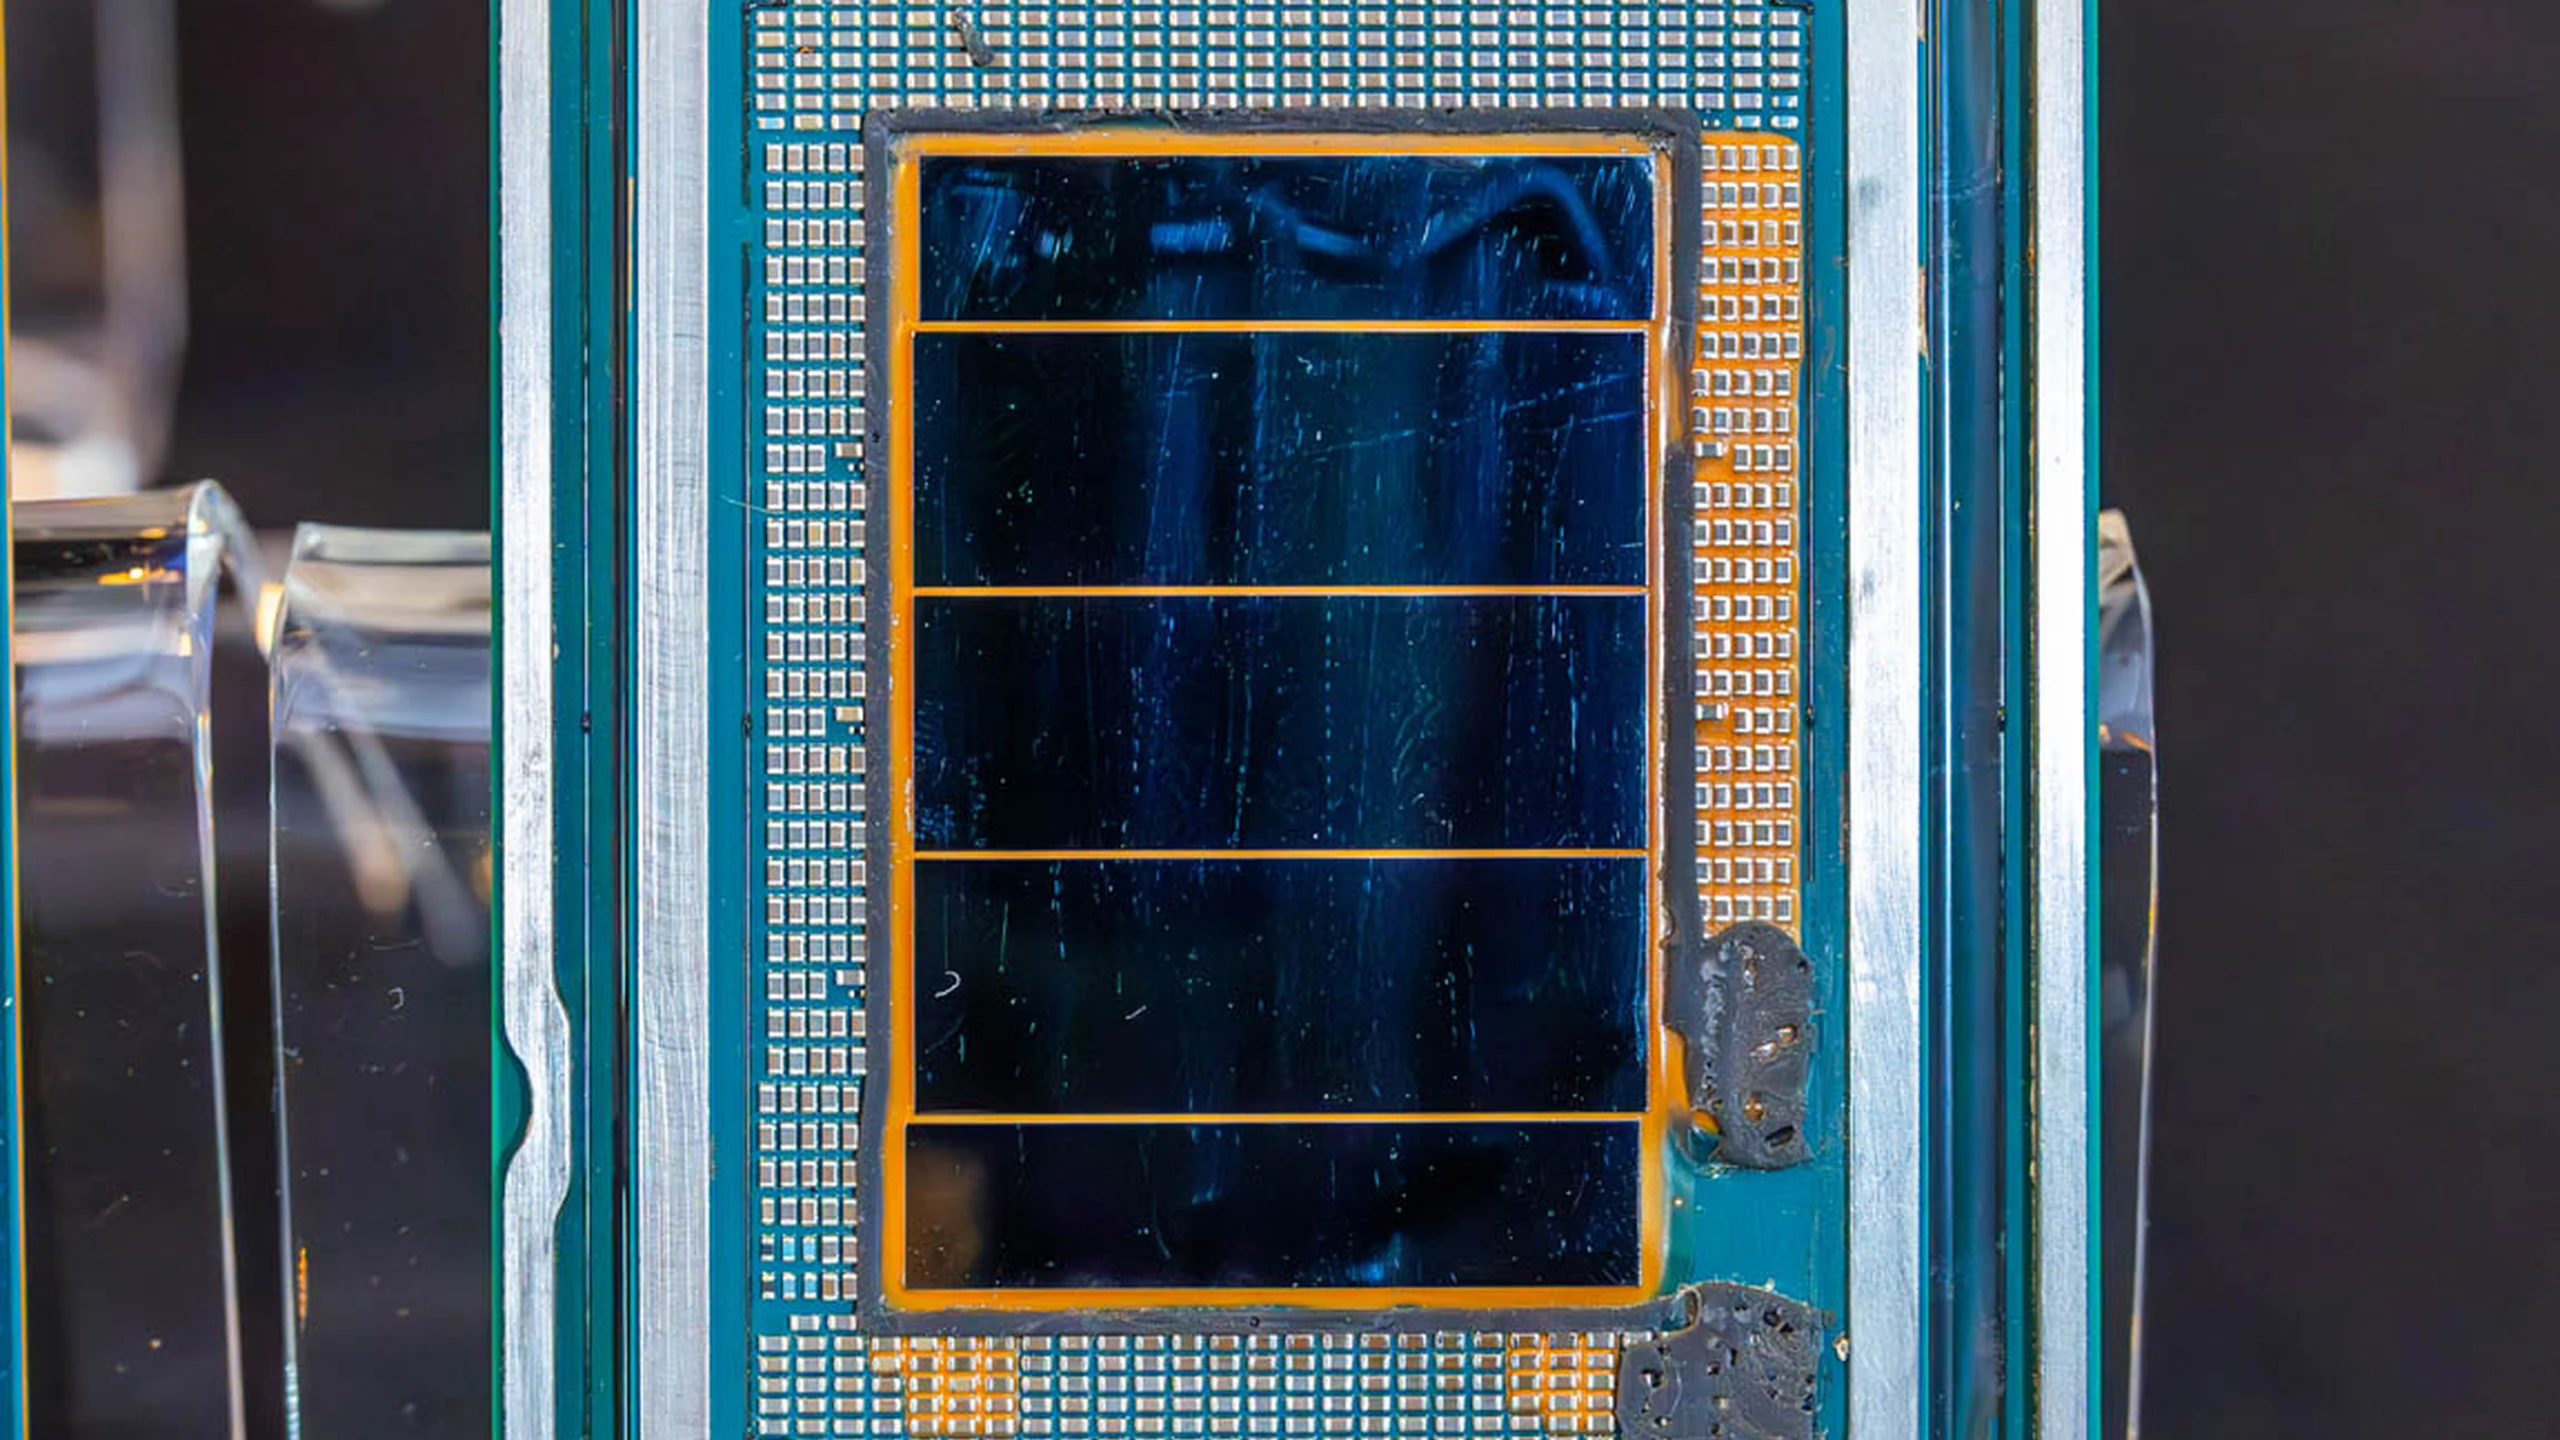
La disponibilité élargie des Xeon 6+ Clearwater Forest d’Intel met un jalon industriel à la portée de davantage d’acheteurs de serveurs. La famille a été lancée au deuxième trimestre 2026 ; ServeTheHome rapporte ensuite une production dépassant les premiers clients hyperscale. Quatre modèles couvrent 144–288 cœurs efficaces, mais le fleuron n’est pas automatiquement le meilleur achat. Des ressources de plateforme communes signifient que l’ajout de cœurs change aussi bande passante, cache et puissance par cœur.
L’analyse des modèles par ServeTheHome pose donc une question plus utile que celle du plus gros chiffre : l’application utilise-t-elle des centaines de cœurs indépendants, ou épuise-t-elle d’abord mémoire, licences ou marge de latence ? La réponse détermine aussi si le récit industriel et de densité devient un avantage d’exploitation.
Une plateforme, quatre équilibres
Le catalogue Clearwater Forest d’Intel donne le 6990E+ à 288 cœurs, 576MB de cache et 450W de TDP ; le 6980E+ à 264, 528MB et 400W ; le 6970E+ à 192, 480MB et 400W ; le 6960E+ à 144, 432MB et 330W. Ce sont des enveloppes nominales de processeur, pas des mesures à la prise d’un serveur chargé.
Tous utilisent des E-cores privilégiant densité de débit et efficacité plutôt que vitesse maximale d’un thread. Tous prennent en charge deux sockets, douze canaux DDR5 et 96 lignes PCIe. MRDIMM combine les données de deux rangs pour augmenter les transferts, jusqu’à DDR5-8000 en configuration adaptée. Il n’est pas nécessaire de choisir le sommet pour débloquer canaux, sockets, accélérateurs ou rapports énergétiques.
Application Energy Telemetry est également généralisée. Intel décrit une attribution matérielle aux charges, conteneurs, VM, applications et threads individuels, pouvant aider au placement et révéler les tâches qui consomment en attendant mémoire ou I/O. Cette attribution fine ne remplace pas la mesure de l’énergie totale.
La fabrication compte en elle-même. Clearwater Forest est le premier processeur de centre de données Intel avec tuiles de calcul 18A, RibbonFET et alimentation arrière. Foveros Direct relie densément du silicium empilé. Le boîtier utilise douze tuiles de calcul, trois bases actives, deux I/O et douze ponts intégrés. L’expérience en volume peut servir aux conceptions suivantes ; la disponibilité durable, pas le nom du procédé, montrera l’exécution industrielle.
Moins de cœurs peuvent mieux alimenter chaque thread
Le 6990E+ dispose de 2MB de cache de dernier niveau par cœur, le 6970E+ de 2,5MB et le 6960E+ de 3MB. Le 6980E+ conserve 2MB en passant de 288 à 264 cœurs. Les deux petits modèles ne diffèrent donc pas seulement en capacité totale : un logiciel ne montant pas proprement à 288 reçoit davantage de ressources de soutien par cœur.
Avec l’hypothèse de douze canaux DDR5-8000 MRDIMM, la bande théorique par cœur est d’environ 2,67GB/s au sommet et 5,34GB/s à 144 cœurs. Réduire de moitié les cœurs double l’allocation arithmétique sans changer la mémoire. Cela ne promet pas une application deux fois plus rapide. Accès, compilateur, placement et mémoire non uniforme modifient bande réelle et contention.
La fréquence varie aussi. Les deux grands modèles ont un turbo maximal de 3,2GHz ; le 6970E+ une base de 2,3GHz et le 6960E+ de 2,4GHz. ServeTheHome rapporte 3,0GHz tous cœurs pour le modèle 144 à sa puissance nominale. Le turbo de quelques cœurs n’est pas la fréquence soutenue de centaines actifs. Le 6960E+ reprend les 144 cœurs du précédent sommet Sierra Forest, mais porte le cache à 432MB.
Ce sont des pistes, pas des vainqueurs prouvés pour toute application. Web sans état, diffusion, microservices, conteneurs légers et VM denses peuvent utiliser le parallélisme supérieur. Bases sensibles à la mémoire, analyses, réseau et services moins extensibles peuvent préférer le 6960E+. Le 6970E+ à 192 offre un tiers de cœurs de plus que 144 et plus de cache par cœur que le fleuron. Le 6980E+ à 264 dépend davantage des plafonds de puissance, de l’offre et du comportement de la charge.
Les profils ne résolvent pas la question énergétique
Intel Speed Select Technology propose des profils définis sur les pièces compatibles ; les deux grands modèles ont des configurations réduites. Le 6990E+ peut passer de 450W à 330W, avec un turbo tous cœurs rapporté de 2,8 à 2,4GHz : environ 14 % de fréquence et 27 % de TDP en moins. Une même puce peut viser le débit maximal ou un budget de socket serré sans nouvel achat.
À 330W, les 288 cœurs donnent environ 1,15 watt nominal par cœur ; le 6980E+ réduit environ 1,14W. Le 6960E+ à 144 répartit ses 330W sur deux fois moins de cœurs, offrant plus de marge de fréquence. Peu de watts par cœur favorisent la densité ; une fréquence haute peut terminer plus vite un travail peu extensible. Aucun rapport ne mesure le travail achevé par kilowattheure.
Mémoire, stockage, réseau, refroidissement, régulation et repos contribuent à la consommation réelle. Une tâche ralentie peut utiliser plus d’énergie si la durée compense la baisse de puissance instantanée. Des sites contraints par électricité ou chaleur doivent mesurer le serveur entier. Plus de cœurs ne servent pas si l’alimentation et le refroidissement ne soutiennent pas leur utilisation productive.
Les déclarations de lancement examinées par ServeTheHome comprenaient 2,26 fois les performances moyennes et 55 % de performances/W supplémentaires face au Xeon 6780E à 144 cœurs. Le nouveau sommet double les cœurs et augmente la puissance ; le gain total n’est pas un saut identique par cœur. Certaines comparaisons télécom annonçaient jusqu’à 38 % de puissance de baie en moins et plus de 60 % de performances/W en plus. Il s’agit de charges et configurations choisies par Intel, pas de preuves indépendantes universelles.
Prime de densité, licences et domaines de panne
Consolider un objectif de débit sur moins de machines peut réduire duplication de réseau, gestion et espace. Cela concentre aussi les pannes : perdre un nœud dense enlève plus de capacité. Ordonnancement, redondance et reprise doivent correspondre au domaine accru. La latence peut rendre les fréquences réduites inadéquates, même si le débit moyen suffit.
Le 6960E+ a le coût CPU le plus faible et la meilleure valeur par cœur dans le positionnement public de liste d’Intel ; le haut de gamme facture une prime de densité. Cela ne détermine pas automatiquement un avantage précis de prix réel. CPU, mémoire, châssis, carte, réseau, stockage, alimentations, refroidissement, logiciels, assistance et personnel composent le coût : une puce chère peut être rationnelle si elle évite des systèmes supplémentaires.
Les licences peuvent inverser le calcul. Les contrats par socket favorisent la densité ; ceux par cœur peuvent facturer tous les cœurs activés, occupés ou non. VM et bases nécessitent un examen individuel. Calcul, bande, capacité, stockage, réseau ou licences peuvent limiter ; un classement de cœurs n’établit pas la valeur totale.
Des tests représentatifs doivent mesurer travail terminé, fréquence soutenue et latence de fin de distribution à plusieurs utilisations, avec énergie du boîtier, de la mémoire et du serveur. Avec des réserves cloud pour pics et objectifs de service, 40 % d’utilisation peut importer plus que le maximum. AET peut attribuer ces profils, mais un bon chiffre par thread ou cœur reste une partie de la décision.
AMD et Arm exposent des lacunes de comparaison
Face à AMD EPYC 9965, Intel revendique environ 30 % de performances moyennes par thread en plus et un avantage similaire par thread et watt. AMD a 192 cœurs Zen 5 avec SMT exposant 384 threads ; Clearwater Forest a 288 E-cores physiques et 288 threads sans SMT. Le thread n’est donc pas la même unité de ressources.
La couverture de lancement de Tom’s Hardware relevait l’absence de comparaison globale large par socket. Les résultats par thread aident taille des VM, licences et latence, mais ne montrent pas quel socket termine davantage. SMT améliore l’utilisation en partageant les ressources ; des E-cores séparés peuvent être plus prévisibles pour certains mappages vCPU–cœur physique. Aucun ne gagne partout.
Xeon 6+ prend en charge AVX2, pas AVX-512 ni AVX10, limitant son adéquation naturelle aux simulations, au HPC et à certains médias ou traitements vectoriels. Intel fournit des accélérateurs de compression, cryptographie, déplacement, équilibrage et analyse en mémoire. Le logiciel doit les employer. D’importants gains SHA ou SM3 sélectionnés ne se généralisent pas au code courant.
AWS Graviton, Google Axion, Microsoft Cobalt et AmpereOne commercial créent un autre front d’efficacité et de densité. Intel veut garder le cloud-native sur x86 familier, mais les hyperscalers contrôlent assez de logiciels pour d’autres instructions et intègrent Arm propre, achats et installations. Intel se dit compétitif, pourtant de larges tests directs Arm manquaient au lancement. La familiarité est un atout, pas une preuve de coût moindre.
La disponibilité doit concrétiser la compatibilité
Les processeurs partagent LGA 7529 avec Xeon 6900P. Les systèmes existants pourraient, selon les informations, prendre en charge Xeon 6+ par firmware après validation du fournisseur. Les économies dépendent de qualification, refroidissement, alimentation, topologie mémoire et gestion, pas seulement du nom du socket. Davantage de systèmes OEM confirmeraient la sortie du déploiement hyperscale initial.
Les prochaines preuves restent des tests indépendants reproductibles des quatre modèles et profils. Débit soutenu, puissance totale, configuration mémoire et latence extrême doivent accompagner les résultats cloud, bases, télécom, VM, stockage, compression et cryptographie. Le débit conservé à 330W importe davantage que supposer des pertes égales de fréquence et de débit.
Une offre 18A stable et un parc plus grand éprouveront aussi le redressement industriel et montreront les logiciels utilisant vraiment 288 cœurs. Pour l’instant, plusieurs objectifs coexistent : densité maximale en haut, milieu à 192, davantage de bande, cache et fréquence par cœur à 144. La valeur émerge seulement avec le goulot applicatif, le coût complet et les mesures indépendantes.