
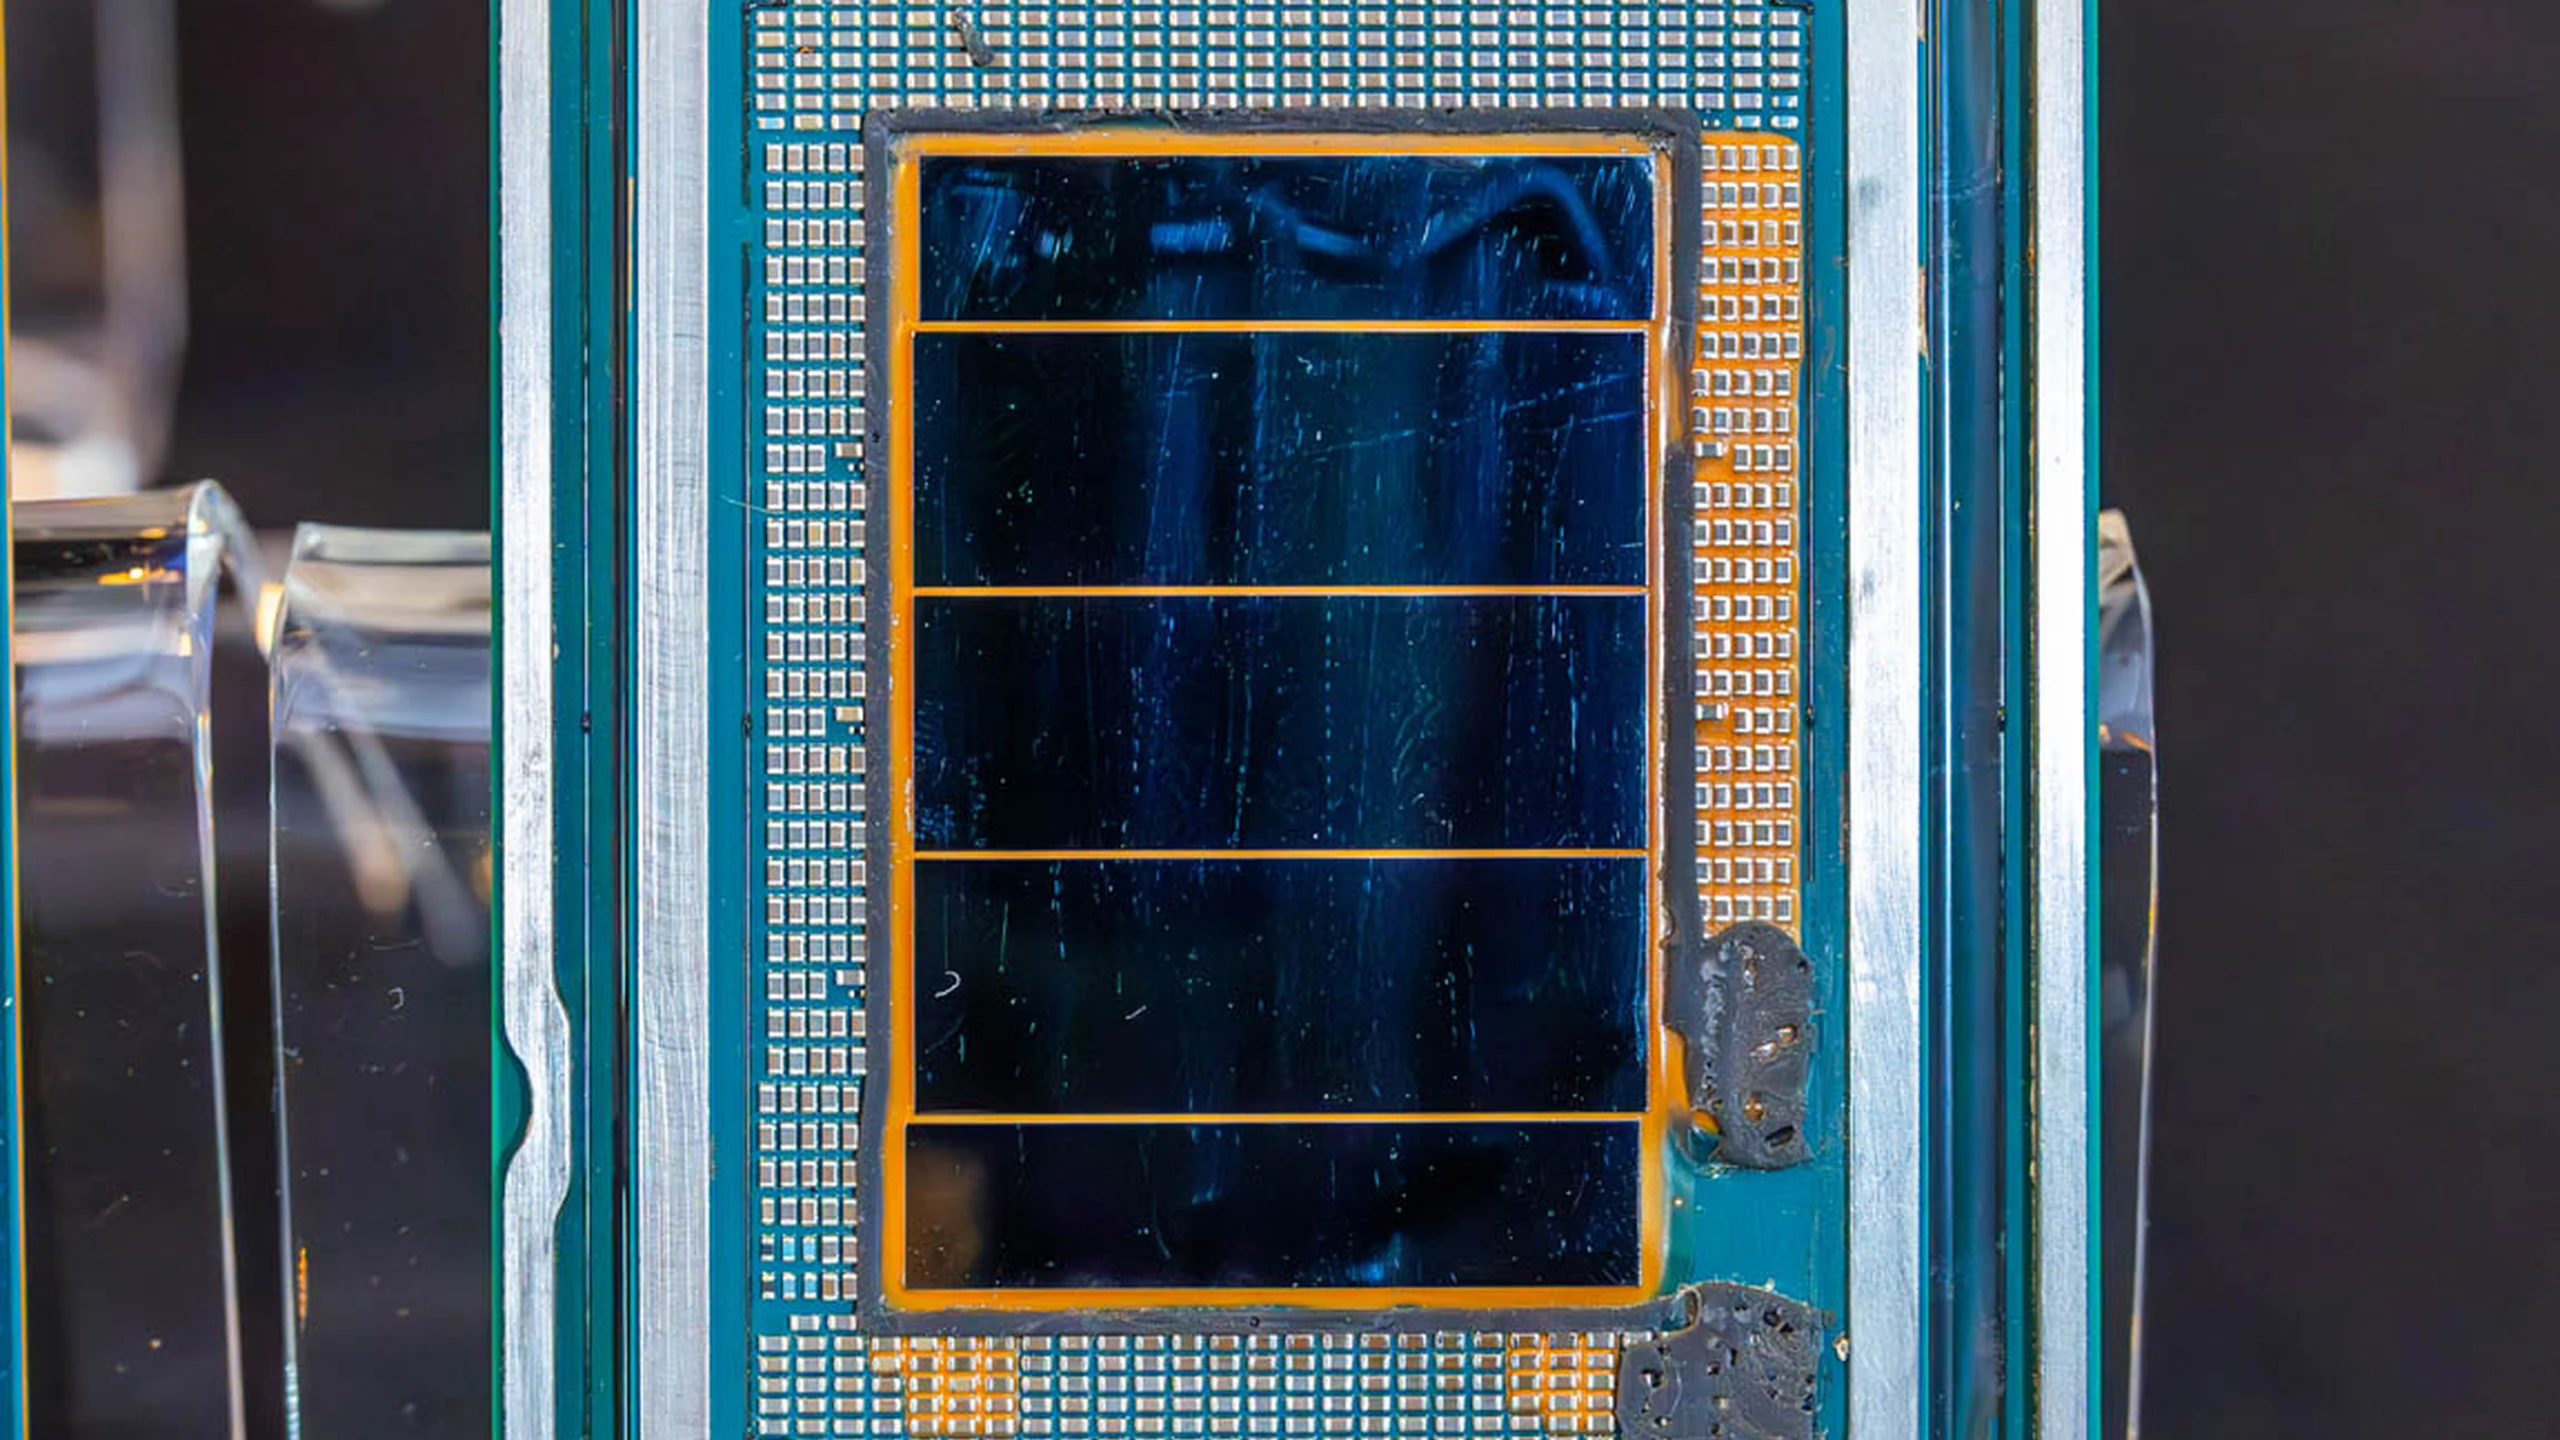
A distribuição mais ampla do Intel Xeon 6+ Clearwater Forest leva um marco de fabricação a mais compradores de servidores. A família foi lançada no segundo trimestre de 2026; a ServeTheHome relata expansão posterior da produção além dos primeiros clientes hyperscale. Quatro modelos cobrem 144–288 núcleos de eficiência, mas o topo não é automaticamente a melhor compra. Recursos comuns da plataforma significam que adicionar núcleos também muda a largura de banda, cache e potência disponíveis para cada um.
A análise de SKUs da ServeTheHome faz uma pergunta mais útil do que qual número é maior: a aplicação escala entre centenas de núcleos independentes ou esgota antes a memória, o orçamento de licenças e a margem de latência? A resposta também determina se a história de densidade e fabricação vira vantagem operacional.
Uma plataforma, quatro equilíbrios de recursos
O catálogo Clearwater Forest da Intel lista o 6990E+ com 288 núcleos, 576MB de cache e TDP de 450W; o 6980E+ com 264, 528MB e 400W; o 6970E+ com 192, 480MB e 400W; e o 6960E+ com 144, 432MB e 330W. São envelopes declarados do processador, não medições de um servidor carregado na tomada.
Todos usam E-cores, priorizando densidade de throughput e eficiência, não velocidade máxima de uma thread. Todos oferecem dois soquetes, 12 canais DDR5 e 96 pistas PCIe. MRDIMM combina dados de dois ranks para aumentar transferências, até DDR5-8000 com a configuração adequada. Não é preciso comprar o topo apenas para liberar canais, soquetes, aceleradores ou relatórios de energia.
Application Energy Telemetry também está em toda a família. A Intel descreve atribuição por hardware a cargas, contêineres, VMs, aplicações e threads individuais. Pode ajudar no posicionamento e revelar tarefas que gastam energia esperando memória ou I/O. Atribuição mais detalhada não substitui medir energia total.
A fabricação tem significado próprio. É o primeiro processador de data center Intel com tiles de computação 18A, RibbonFET e alimentação traseira. Foveros Direct conecta silício empilhado densamente. O pacote usa 12 tiles de computação, três bases ativas, dois I/O e 12 pontes incorporadas. Experiência em volume pode orientar projetos posteriores; disponibilidade sustentada, não o nome do processo, demonstrará execução.
Menos núcleos podem oferecer mais recursos por thread
O 6990E+ oferece 2MB de cache de último nível por núcleo, o 6970E+ 2,5MB e o 6960E+ 3MB. O 6980E+ mantém 2MB ao reduzir de 288 para 264 núcleos. Os modelos inferiores diferem, portanto, em mais que computação agregada: software que não escala até 288 recebe mais apoio por núcleo.
Com a premissa de 12 canais DDR5-8000 MRDIMM, a largura de banda teórica por núcleo é cerca de 2,67GB/s no topo e 5,34GB/s no modelo de 144. Metade dos núcleos dobra a divisão aritmética sem mudar a memória. Não promete aplicação duas vezes mais rápida. Acessos, compilador, posição dos dados e acesso não uniforme mudam a banda efetiva e a contenção.
As frequências também variam. O par superior tem turbo máximo de 3,2GHz; o 6970E+ tem base de 2,3GHz e o 6960E+ de 2,4GHz. A ServeTheHome informa turbo all-core de 3,0GHz para 144 núcleos na potência declarada. Turbo máximo com poucos núcleos não é a velocidade sustentada de centenas ocupados. O 6960E+ volta aos 144 núcleos do topo Sierra Forest anterior, mas eleva o cache a 432MB.
São pontos de partida, não vencedores de todas as aplicações. Web sem estado, distribuição de conteúdo, microsserviços, contêineres leves e VMs densas podem usar o paralelismo máximo. Bancos sensíveis à memória, análise, rede e serviços que escalam mal podem valorizar o 6960E+. O 6970E+ de 192 oferece um terço mais núcleos que 144 e mais cache por núcleo que o topo. O 6980E+ de 264 depende mais de limites superiores de potência, oferta e comportamento da carga.
Perfis mudam a comparação, não respondem sobre energia
Intel Speed Select Technology oferece perfis definidos em peças compatíveis, com opções reduzidas nos dois modelos superiores. O 6990E+ passa de 450W para 330W, com turbo all-core informado de 2,8GHz para 2,4GHz: aproximadamente 14% menos frequência e 27% menos TDP. O mesmo chip pode priorizar throughput ou um orçamento mais apertado sem nova compra.
A 330W, o processador de 288 resulta em cerca de 1,15 watts declarados por núcleo; o 6980E+ reduzido, aproximadamente 1,14W. O 6960E+ de 144 divide seus 330W entre metade dos núcleos, liberando margem de frequência. Baixos watts por núcleo favorecem densidade, clocks maiores podem terminar trabalho mal escalável antes. Nenhum índice mede trabalho concluído por quilowatt-hora.
Memória, armazenamento, rede, refrigeração, regulação e ociosidade contribuem para o consumo. Uma tarefa mais lenta pode gastar mais energia total se a duração extra superar a queda de potência instantânea. Instalações limitadas por eletricidade ou dissipação precisam medir o servidor inteiro. Mais núcleos não ajudam se o rack não sustenta utilização produtiva com energia e refrigeração.
As alegações de lançamento discutidas pela ServeTheHome incluíam 2,26 vezes o desempenho médio e 55% mais desempenho/W contra o Xeon 6780E de 144 núcleos. O novo topo dobra núcleos e aumenta o teto de potência, logo o ganho agregado não é salto equivalente por núcleo. Comparações selecionadas de telecomunicações alegavam até 38% menos potência de rack e mais de 60% melhor desempenho/W. São cargas e configurações escolhidas pela Intel, não evidência independente universal.
Prêmios de densidade encontram licenças e domínios de falha
Consolidar uma meta de throughput em menos máquinas reduz potencialmente duplicação de rede, gestão e racks. Também concentra falhas: perder um nó denso remove mais capacidade. Agendamento, redundância e recuperação precisam corresponder ao domínio maior. Requisitos de latência podem tornar perfis de menor clock inadequados mesmo com throughput médio suficiente.
O 6960E+ tem o menor custo de CPU e melhor valor por núcleo no posicionamento de lista público da Intel; o topo cobra prêmio de densidade. Isso não determina vantagem específica no preço de mercado. CPU é apenas parte do servidor: memória, chassi, placa, interfaces, discos, fontes, refrigeração, software, suporte e pessoal podem tornar racional o chip mais caro quando evita sistemas duplicados.
Licenças podem inverter a conta. Contratos por soquete recompensam densidade; por núcleo podem cobrar todos os habilitados, produtivos ou ociosos. Virtualização e banco de dados exigem análise individual. Computação, banda, capacidade, armazenamento, rede ou licenciamento podem limitar o sistema, portanto contagem de núcleos não estabelece valor total.
Testes representativos devem medir trabalho concluído, frequência sustentada e latência de cauda em várias utilizações, com energia de pacote, memória e servidor. Em nuvens com reservas para picos e objetivos de serviço, 40% de uso pode importar mais que o máximo. AET pode atribuir padrões, mas estatísticas favoráveis por thread ou núcleo são só parte da decisão.
AMD e Arm expõem lacunas dos benchmarks
Contra AMD EPYC 9965, Intel alega desempenho médio por thread aproximadamente 30% maior e vantagem semelhante por thread por watt. A AMD tem 192 Zen 5 com SMT para 384 threads; Clearwater Forest tem 288 E-cores físicos e 288 threads sem SMT. Thread não é, portanto, unidade igual de recursos nos dois projetos.
A cobertura de lançamento da Tom’s Hardware notou ausência de comparação ampla agregada por soquete. Resultados por thread ajudam dimensionar VMs, licenças e latência, mas não mostram qual soquete faz mais trabalho. SMT melhora utilização compartilhando recursos; E-cores separados podem ser mais previsíveis em alguns mapeamentos vCPU–núcleo físico. Nenhum vence todas as cargas.
Xeon 6+ suporta AVX2, não AVX-512 ou AVX10, limitando sua adequação natural a simulações, HPC e algumas mídias ou análises vetoriais. A Intel oferece aceleradores de compressão, criptografia, movimentação, balanceamento e análise em memória. O software deve usá-los. Grandes ganhos selecionados de SHA ou SM3 não podem ser generalizados para código comum.
AWS Graviton, Google Axion, Microsoft Cobalt e o comercial AmpereOne formam outra frente de densidade e eficiência. A Intel quer manter cloud-native no x86 familiar, mas hyperscalers controlam software suficiente para outra arquitetura e integram Arm próprio a compras e instalações. A Intel afirma comparar-se favoravelmente; faltava, porém, ampla comparação direta Arm no lançamento. Familiaridade é vantagem, não prova de custo menor.
Oferta precisa transformar compatibilidade em evidência
Os processadores compartilham a família LGA 7529 com Xeon 6900P. Sistemas existentes podem, segundo relatos, suportar Xeon 6+ por firmware após validação do fornecedor. A economia prática depende de qualificação, refrigeração, energia, topologia de memória e gestão, não só do nome do soquete. Mais sistemas OEM confirmariam a expansão além dos primeiros hyperscalers.
Testes independentes reproduzíveis dos quatro modelos e perfis continuam sendo a próxima evidência. Throughput sustentado, potência total, memória instalada e latência de cauda devem acompanhar resultados de nuvem, bancos, telecom, VMs, armazenamento, compressão e criptografia. Quanto throughput o topo de 330W conserva importa mais do que supor que frequência e desempenho caem na mesma proporção.
Oferta 18A estável e base instalada maior também testarão a recuperação fabril e revelarão software que realmente usa 288 núcleos. Por enquanto, a linha oferece metas distintas: máxima densidade no topo, meio-termo de 192 e mais banda, cache e clock por núcleo com 144. O valor surge ao combinar gargalo da aplicação, custos completos e medições independentes.