
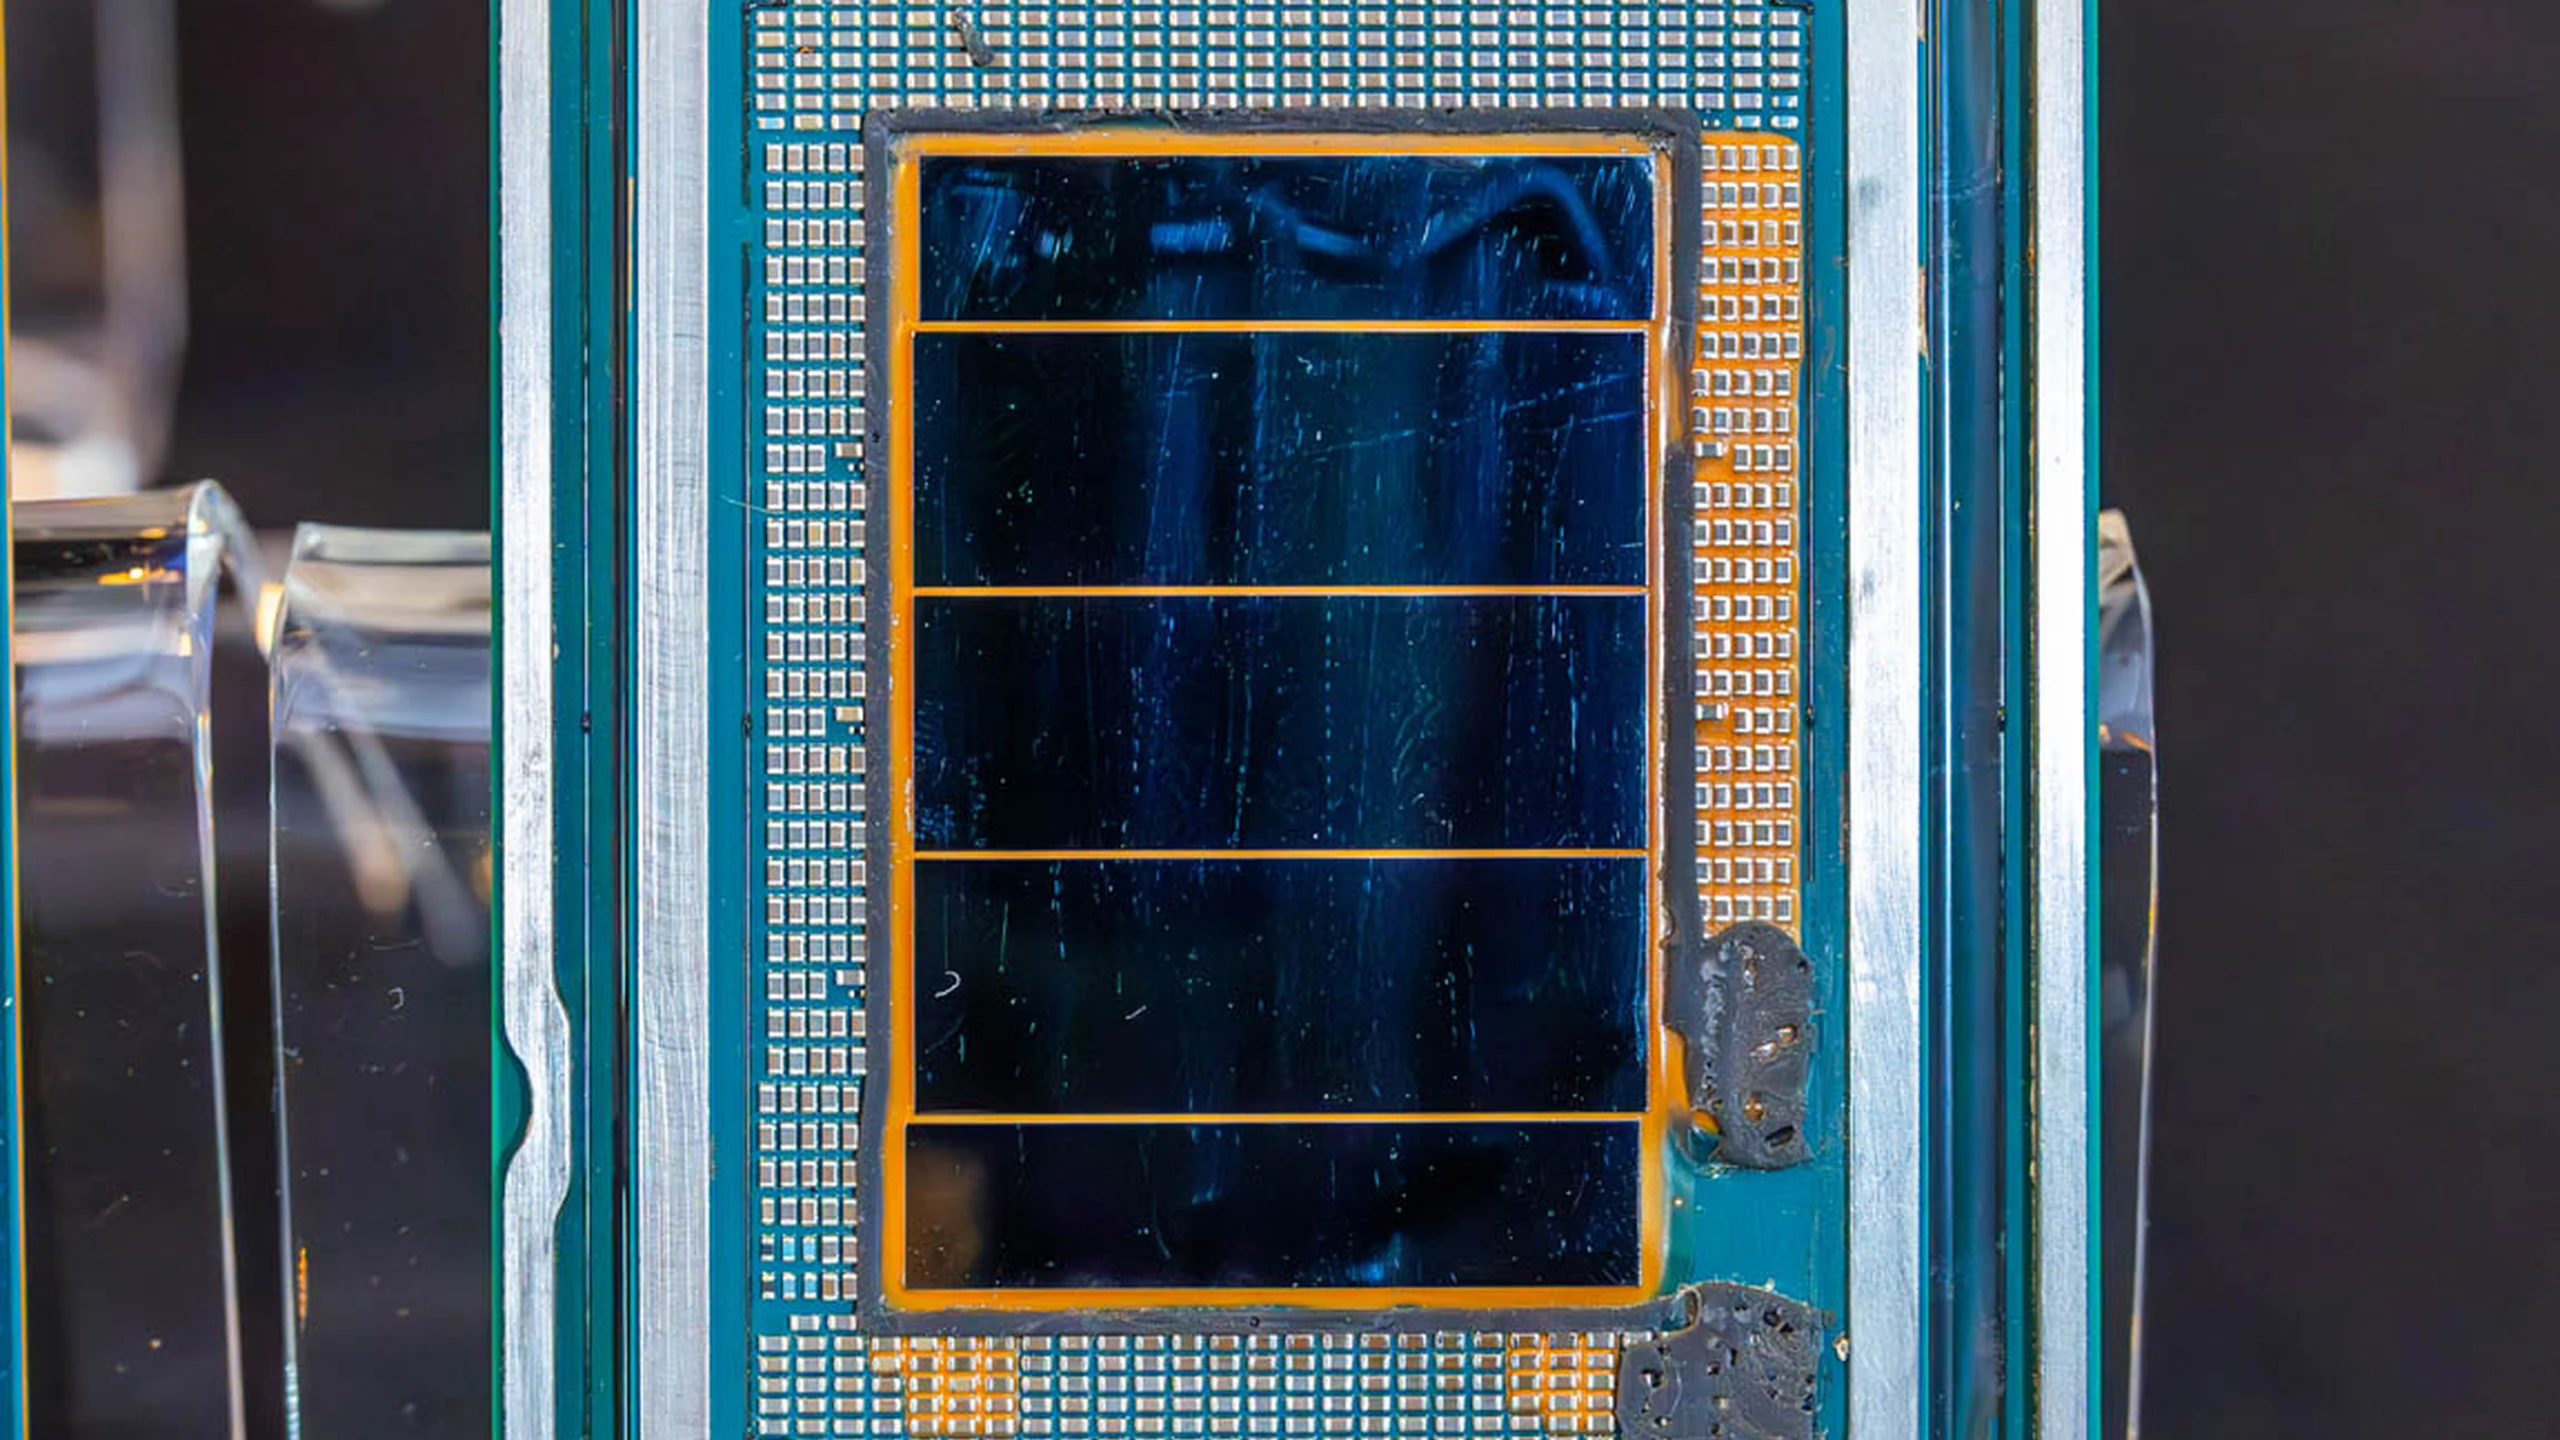
Szersza dystrybucja Intel Xeon 6+ Clearwater Forest udostępnia produkcyjny kamień milowy większej grupie nabywców serwerów. Rodzina zadebiutowała w drugim kwartale 2026 roku; ServeTheHome informuje o późniejszym wzroście produkcji poza pierwszych klientów hiperskalowych. Cztery modele obejmują 144–288 rdzeni efektywnościowych, lecz flagowiec nie jest automatycznie najlepszym zakupem. Wspólne zasoby platformy oznaczają, że kolejne rdzenie zmieniają też przepustowość, cache i budżet mocy przypadający na każdy z nich.
Analiza SKU ServeTheHome stawia więc pytanie ważniejsze od największej liczby: czy aplikacja skaluje się na setki niezależnych rdzeni, czy wcześniej wyczerpuje przepustowość pamięci, budżet licencji lub zapas opóźnień? Odpowiedź decyduje również, czy argument produkcji i gęstości Intela przyniesie przewagę kosztów operacyjnych.
Jedna platforma, cztery równowagi zasobów
Katalog Clearwater Forest Intela podaje: 6990E+ ma 288 rdzeni, 576MB cache i TDP 450W; 6980E+ 264 rdzenie, 528MB i 400W; 6970E+ 192 rdzenie, 480MB i 400W; 6960E+ 144 rdzenie, 432MB i 330W. To deklarowane limity procesora, nie pomiar obciążonego serwera z gniazdka.
Wszystkie używają E-core, priorytetyzując gęstość przepustowości i efektywność zamiast najwyższej szybkości jednego wątku. Każdy obsługuje dwa gniazda, 12 kanałów DDR5 i 96 linii PCIe. MRDIMM łączy dane dwóch rang pamięci, zwiększając transfer, do DDR5-8000 w odpowiednich konfiguracjach. Flagowiec nie jest konieczny, by odblokować te kanały, gniazda, akceleratory czy raporty energii.
Application Energy Telemetry także obejmuje całą rodzinę. Intel opisuje sprzętowe przypisywanie energii obciążeniom, kontenerom, maszynom wirtualnym, aplikacjom i poszczególnym wątkom. Może wspierać rozmieszczanie i ujawniać pracę zużywającą energię podczas oczekiwania na pamięć lub I/O. Dokładniejsza atrybucja nie zastępuje jednak pomiaru całej energii systemu.
Znaczenie ma sama konstrukcja produkcyjna. Clearwater Forest jest pierwszym procesorem centrum danych Intela z kaflami obliczeniowymi 18A, RibbonFET i zasilaniem od tylnej strony. Foveros Direct gęsto łączy warstwowy krzem. Obudowa zawiera 12 kafli obliczeniowych, trzy aktywne bazowe, dwa I/O i 12 wbudowanych mostków. Doświadczenia wolumenowe mogą wspierać przyszłe projekty, lecz wykonanie produkcyjne pokaże ciągła dostępność, nie nazwa procesu.
Mniej rdzeni może oznaczać więcej zasobów na wątek
6990E+ ma 2MB cache ostatniego poziomu na rdzeń, 6970E+ 2,5MB, a 6960E+ 3MB. 6980E+ utrzymuje 2MB przy redukcji z 288 do 264 rdzeni. Dolne dwa modele różnią się więc nie tylko całkowitą mocą obliczeniową: program nieskalujący się dobrze do 288 rdzeni otrzymuje więcej wsparcia dla każdego rdzenia.
Przy założeniu 12 kanałów DDR5-8000 MRDIMM teoretyczna przepustowość na rdzeń to około 2,67GB/s flagowca i 5,34GB/s modelu 144-rdzeniowego. Połowa rdzeni podwaja arytmetyczny przydział bez zmiany pamięci. Nie obiecuje dwukrotnie szybszej aplikacji. Dostępy, kompilator, rozmieszczenie danych i niejednorodny dostęp zmieniają rzeczywistą przepustowość i rywalizację.
Częstotliwość też różnicuje ofertę. Górne dwa modele mają maksymalne turbo 3,2GHz, 6970E+ bazę 2,3GHz, a 6960E+ 2,4GHz. ServeTheHome podaje 3,0GHz turbo wszystkich rdzeni dla 144 rdzeni przy deklarowanej mocy. Maksimum przy niewielu aktywnych rdzeniach nie jest trwałą szybkością setek zajętych. 6960E+ wraca do 144 rdzeni dawnego flagowca Sierra Forest, zwiększając cache do 432MB.
To punkty wyjścia testów, nie zwycięzcy każdej aplikacji. Bezstanowe strony, dystrybucja treści, mikrousługi, lekkie kontenery i gęste VM mogą wykorzystywać pulę flagowca. Wrażliwe na pamięć bazy, analityka, sieć i słabiej skalujące usługi mogą cenić 6960E+. 192-rdzeniowy 6970E+ daje o jedną trzecią więcej rdzeni niż 144 i więcej cache na rdzeń niż flagowiec. 264-rdzeniowy 6980E+ zależy bardziej od limitów mocy górnej klasy, dostępności i zachowania zadania.
Profile mocy zmieniają porównanie, nie odpowiadają na pytanie o energię
Intel Speed Select Technology daje zgodnym układom określone profile mocy i wydajności. Dwa najwyższe modele mają konfiguracje oszczędniejsze. 6990E+ może zejść z 450W do 330W, z raportowanym turbo wszystkich rdzeni spadającym z 2,8 do 2,4GHz: około 14% mniej częstotliwości i 27% mniej TDP. Bez nowego zakupu można wybierać maksymalny przepływ lub ciaśniejszy limit gniazda.
Przy 330W procesor 288-rdzeniowy daje około 1,15 deklarowanego wata na rdzeń; obniżony 6980E+ około 1,14W. 144-rdzeniowy 6960E+ dzieli swoje 330W między połowę rdzeni, zapewniając zapas zegara. Niskie W/rdzeń sprzyjają gęstości, a wyższy zegar może szybciej skończyć słabo skalujące zadanie. Żaden wskaźnik nie mierzy wykonanej pracy na kilowatogodzinę.
Pamięć, dyski, sieć, chłodzenie, regulacja napięcia i bezczynność wpływają na zużycie. Wolniejsze zadanie może potrzebować więcej energii, jeśli dłuższy czas przeważy mniejszą chwilową moc. Obiekty ograniczone elektrycznie lub cieplnie potrzebują pomiarów serwera. Więcej rdzeni nie pomoże, jeśli zasilanie i chłodzenie szafy nie podtrzymają produktywnego wykorzystania.
Premiera analizowana przez ServeTheHome obejmowała deklaracje Intela: 2,26 razy średnia wydajność i 55% lepsza wydajność/W wobec 144-rdzeniowego Xeon 6780E. Nowy flagowiec ma dwa razy więcej rdzeni i wyższą moc, więc przyrost łączny nie oznacza takiego skoku każdego rdzenia. Wybrane porównania telekomunikacyjne mówiły o maksymalnie 38% niższej mocy szafy i ponad 60% lepszej wydajności/W. Wszystko dotyczy wyboru zadań i konfiguracji Intela, nie niezależnych dowodów każdego wdrożenia.
Premia gęstości, licencje i domeny awarii
Mniej maszyn dla ustalonej przepustowości może obniżać powielane koszty sieci, zarządzania i miejsca. Koncentruje też awarie: niedostępny gęsty węzeł zabiera więcej pojemności. Planowanie, redundancja i odzyskiwanie muszą odpowiadać większej domenie awarii. Wymagania opóźnień mogą też wykluczyć niższy zegar, nawet gdy średnia przepustowość wystarcza.
6960E+ ma najniższy koszt CPU i najlepszą wartość rdzenia w opublikowanym pozycjonowaniu katalogowym Intela, podczas gdy góra pobiera premię gęstości. Nie wynika stąd automatycznie konkretna przewaga ceny rynkowej. Procesor jest częścią kosztu: pamięć, obudowa, płyta, interfejsy sieci, dyski, zasilacze, chłodzenie, programy, wsparcie i personel mogą uzasadnić droższy układ, jeśli unika dodatkowych serwerów.
Licencje potrafią odwrócić wynik. Umowy per gniazdo premiują gęstość, a per rdzeń mogą naliczać każdy aktywny rdzeń, zajęty lub nieużywany. Umowy VM i baz danych wymagają osobnego sprawdzenia. Moc, przepustowość, pojemność pamięci, dyski, sieć lub licencje mogą ograniczać system; sama lista rdzeni nie ustala wartości.
Reprezentatywne testy powinny mierzyć ukończoną pracę, trwały zegar i opóźnienia ogonowe przy kilku poziomach wykorzystania oraz energię obudowy CPU, pamięci i całości. Przy rezerwach chmurowych na skoki i cele usług 40% wykorzystania może znaczyć więcej niż szczyt. AET może przypisywać te wzorce, ale korzystny wynik na rdzeń lub wątek pozostaje tylko częścią decyzji.
AMD i Arm ujawniają luki benchmarków
Wobec AMD EPYC 9965 Intel deklaruje około 30% lepszą średnią wydajność na wątek i podobną przewagę na wątek na wat. AMD ma 192 rdzenie Zen 5 z SMT dla 384 wątków, a Clearwater Forest 288 fizycznych E-core i 288 wątków bez SMT. Wątek nie jest zatem równą jednostką zasobów obu projektów.
Relacja premierowa Tom’s Hardware wskazywała brak szerokiego porównania całych gniazd. Wyniki wątków pomagają dobierać VM, licencje i opóźnienia, ale nie pokazują większej pracy na gniazdo. SMT poprawia wykorzystanie, dzieląc zasoby rdzenia; niezależne E-core mogą dawać przewidywalność przy niektórych mapowaniach vCPU na rdzeń fizyczny. Żaden projekt nie wygrywa wszędzie.
Xeon 6+ obsługuje AVX2, nie AVX-512 ani AVX10, ograniczając naturalne dopasowanie do symulacji, HPC oraz niektórych wektorowych mediów i analiz. Zamiast tego Intel oferuje akceleratory kompresji, kryptografii, przenoszenia danych, równoważenia i analityki w pamięci. Oprogramowanie musi ich użyć. Duże zyski wybranych SHA czy SM3 nie przenoszą się automatycznie na zwykły kod.
AWS Graviton, Google Axion, Microsoft Cobalt i komercyjny AmpereOne tworzą drugi front gęstości i efektywności. Intel chce utrzymać cloud-native na znanym x86, lecz hiperskalerzy kontrolują coraz więcej oprogramowania, co pozwala obsługiwać inny zestaw instrukcji oraz integrować własny Arm z zakupami i obiektami. Intel twierdzi, że konkuruje korzystnie, jednak przy premierze brakowało szerokich bezpośrednich testów Arm. Znajomość jest zaletą, nie dowodem niższego kosztu.
Dostępność musi zamienić zgodność w dowody
Procesory dzielą rodzinę LGA 7529 z Xeon 6900P. Istniejące systemy mają według relacji obsługiwać Xeon 6+ przez firmware po weryfikacji dostawcy. Oszczędności zależą od kwalifikacji, chłodzenia, zasilania, topologii pamięci i zarządzania, nie samej nazwy gniazda. Więcej serwerów OEM potwierdzi wyjście poza wczesnych hiperskalerów.
Kolejnym dowodem pozostają powtarzalne niezależne testy czterech modeli i profili. Trwała przepustowość, moc całego systemu, obsada pamięci i opóźnienia ogonowe powinny towarzyszyć wynikom chmury, baz, telekomunikacji, VM, dysków, kompresji i kryptografii. Ile pracy zachowuje flagowiec 330W, znaczy więcej niż założenie jednakowego spadku częstotliwości i przepustowości.
Stabilna podaż 18A i większa baza sprawdzą też odbudowę produkcji oraz pokażą oprogramowanie rzeczywiście używające 288 rdzeni. Na razie oferta daje kilka celów: maksymalną gęstość na górze, środek 192-rdzeniowy i więcej przepustowości, cache oraz zegara na rdzeń przy 144. Wartość ujawnia połączenie ograniczenia aplikacji, pełnych kosztów i niezależnych pomiarów.