
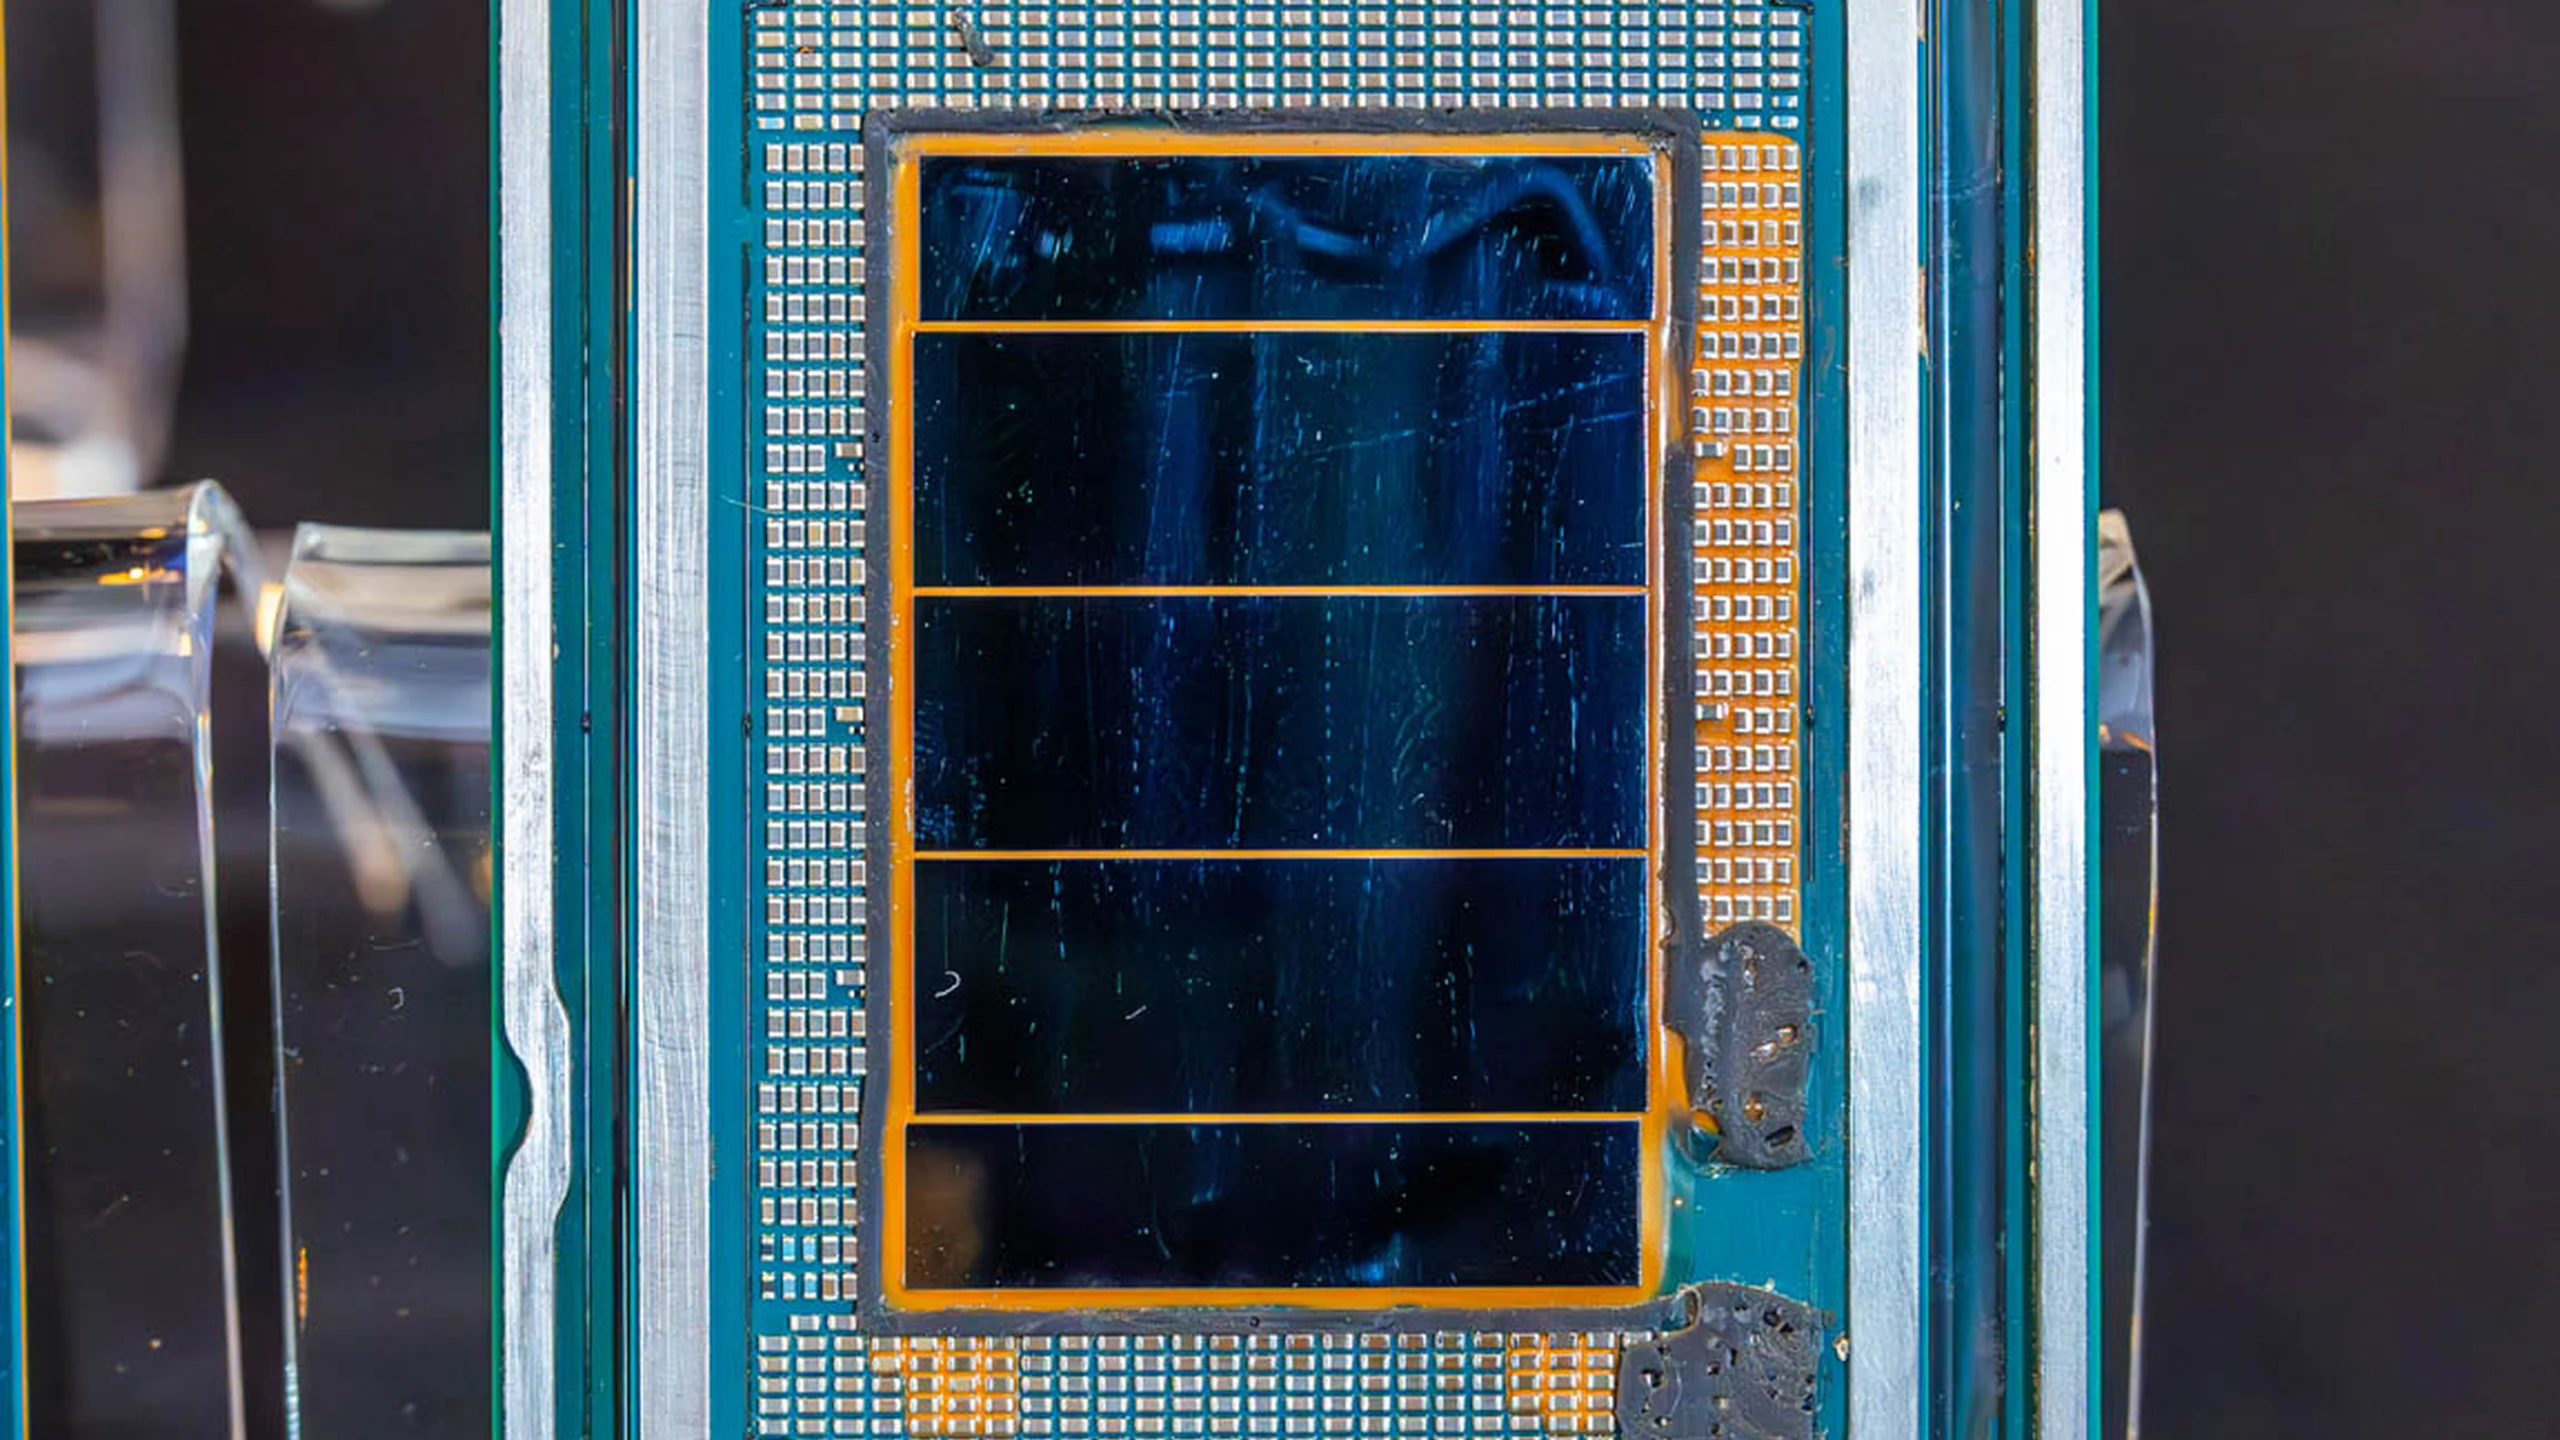
Intel의 Xeon 6+ Clearwater Forest 공급 확대는 제조 이정표를 더 많은 서버 구매자 앞에 놓는다. 제품군은 2026년 2분기에 출시됐고 ServeTheHome은 이후 초기 하이퍼스케일 고객 밖으로 생산이 확대됐다고 보도했다. 네 모델은 144~288개 효율 코어를 제공하지만 플래그십이 자동으로 최선의 구매는 아니다. 주요 플랫폼 자원을 공유하므로 코어 추가는 각 코어의 대역폭, 캐시와 전력 여유도 바꾼다.
ServeTheHome의 SKU 분석은 가장 큰 숫자보다 유용한 질문을 던진다. 앱이 수백 독립 코어까지 확장되는가, 아니면 메모리 대역폭, 라이선스 예산이나 지연 여유가 먼저 소진되는가? 이는 Intel의 밀도·제조 주장이 운영비 이점이 되는지도 결정한다.
하나의 플랫폼과 네 자원 균형
Intel의 Clearwater Forest 목록은 6990E+를 288코어·576MB 캐시·450W TDP, 6980E+를 264코어·528MB·400W, 6970E+를 192코어·480MB·400W, 6960E+를 144코어·432MB·330W로 명시한다. 프로세서의 명시된 전력 범위이지 부하 서버의 콘센트 실측이 아니다.
전부 E-core로 최고 단일 스레드 속도보다 처리 밀도와 효율을 중시한다. 모두 2소켓, DDR5 12채널, PCIe 96레인을 지원한다. MRDIMM은 두 메모리 랭크 데이터를 결합해 전송률을 높이며 적절한 구성에서 DDR5-8000까지 가능하다. 채널, 소켓, 가속기나 에너지 보고 기능만 해제하려고 상위 제품을 살 필요는 없다.
Application Energy Telemetry도 전 제품에 제공된다. Intel은 하드웨어로 워크로드, 컨테이너, VM, 앱과 개별 스레드에 에너지를 귀속한다고 설명한다. 배치 결정과 메모리·I/O를 기다리며 소비하는 작업 발견에 도움이 될 수 있다. 세밀한 귀속이지 전체 시스템 에너지 측정을 대신하지는 않는다.
제조 설계 자체도 중요하다. Clearwater Forest는 18A 컴퓨트 타일, RibbonFET과 후면 전력 공급을 쓰는 첫 Intel 데이터센터 CPU다. Foveros Direct가 적층 실리콘을 조밀하게 연결한다. 패키지는 컴퓨트 타일 12개, 활성 베이스 3개, I/O 2개와 내장 연결 브리지 12개를 쓴다. 양산 경험은 후속 설계를 돕지만 생산 실행력은 공정명보다 지속적인 공급이 보여 준다.
코어가 적으면 스레드당 지원 자원이 많아질 수 있다
6990E+는 코어당 최종 캐시 2MB, 6970E+는 2.5MB, 6960E+는 3MB다. 6980E+는 288에서 264코어로 줄여도 2MB를 유지한다. 하위 두 모델은 총 계산 능력만 다르지 않다. 288코어까지 잘 확장하지 못하는 소프트웨어는 코어당 더 많은 지원 자원을 받는다.
DDR5-8000 MRDIMM 12채널이라는 가정에서 이론 대역폭은 상위 모델 코어당 약 2.67GB/s, 144코어 모델 5.34GB/s다. 메모리 계통을 바꾸지 않고 코어를 반으로 줄이면 산술 할당은 두 배다. 앱 속도 두 배를 약속하지는 않는다. 접근 패턴, 컴파일러, 데이터 배치와 비균일 메모리 접근이 실제 대역과 경합을 바꾼다.
주파수도 다르다. 상위 둘의 최대 터보는 3.2GHz이며 6970E+ 기본 2.3GHz, 6960E+ 기본 2.4GHz다. ServeTheHome은 144코어 제품이 명시 전력에서 올코어 터보 3.0GHz에 도달한다고 보고한다. 소수 코어의 최대 터보는 수백 바쁜 코어의 지속 속도가 아니다. 6960E+는 이전 Sierra Forest 플래그십의 144코어로 돌아오되 캐시를 432MB로 높였다.
이는 시험 출발점이지 모든 앱의 검증된 승자가 아니다. 무상태 웹, 콘텐츠 전송, 마이크로서비스, 가벼운 컨테이너와 밀집 VM은 플래그십 병렬성을 쓸 수 있다. 메모리 민감 DB, 분석, 네트워크 처리와 확장이 불완전한 서비스는 6960E+를 선호할 수 있다. 192코어 6970E+는 144보다 3분의 1 많고 플래그십보다 코어당 캐시가 크다. 264코어 6980E+는 상위 전력 한도, 공급과 실제 부하에 더 좌우된다.
전력 프로필은 비교를 바꿔도 에너지 답은 아니다
Intel Speed Select Technology는 지원 제품에 정해진 전력·성능 프로필을 제공하며 상위 두 모델에 저전력 설정이 있다. 6990E+는 450W에서 330W로 바뀌고 보고된 올코어 터보는 2.8에서 2.4GHz로 내려간다. 주파수 약 14%, TDP 27% 감소다. 다른 CPU를 사지 않고 같은 칩으로 최대 처리량이나 좁은 소켓 예산을 선택할 수 있다.
330W에서 288코어는 코어당 명시 전력 약 1.15W이며 저전력 6980E+는 약 1.14W다. 144코어 6960E+는 330W를 절반 코어에 나눠 주파수 여유를 준다. 낮은 W/코어는 밀도에, 높은 클록은 확장이 나쁜 작업의 조기 완료에 유리할 수 있다. 어느 비율도 kWh당 완료 작업 실측이 아니다.
메모리, 저장장치, 네트워크, 냉각, 전압 조절과 유휴 동작이 소비에 더해진다. 느린 작업은 시간 증가가 순간 전력 감소를 넘으면 총에너지를 더 쓸 수 있다. 전기·열에 제한된 시설은 전체 서버 측정이 필요하다. 랙 전력과 냉각이 생산적 사용을 지원하지 못하면 코어 증가의 산술은 쓸모없다.
ServeTheHome이 다룬 출시 주장에서 Intel은 144코어 Xeon 6780E 대비 평균 성능 2.26배, 와트당 성능 55% 개선을 제시했다. 새 플래그십은 코어 두 배에 전력 한도도 높아 총증가가 같은 코어당 도약은 아니다. 선택 통신 비교는 랙 전력 최대 38% 감소와 와트당 성능 60% 초과 개선을 주장했다. 모두 Intel 선정 부하·구성이며 모든 배포의 독립 증거가 아니다.
밀도 프리미엄과 라이선스·장애 범위
일정 처리량을 적은 기계에 통합하면 네트워크, 관리와 랙 중복비를 줄일 수 있다. 장애도 집중돼 조밀한 노드 하나를 잃으면 더 많은 용량이 사라진다. 스케줄링, 이중화와 복구는 넓어진 장애 범위에 맞아야 한다. 평균 처리량이 충분해도 지연 요구는 저클록 설정을 부적합하게 만들 수 있다.
Intel 공개 가격표상의 위치로는 6960E+가 CPU 구입비가 가장 낮고 코어 가치가 높으며 위쪽은 밀도 프리미엄을 받는다. 특정 실거래 가격 우위를 자동으로 뜻하지 않는다. CPU는 일부다. 메모리, 섀시, 보드, 네트워크, 저장장치, 전원, 냉각, 소프트웨어, 지원과 인력이 있어 중복 시스템을 피하는 비싼 CPU도 경제적일 수 있다.
라이선스는 결과를 뒤집는다. 소켓 계약은 밀도를 보상하고 코어 계약은 바쁘거나 놀거나 모든 활성 코어에 비용을 부과할 수 있다. VM·DB 계약은 개별 검토해야 한다. 계산, 대역폭, 용량, 저장장치, 네트워크와 라이선스가 각각 제약일 수 있어 코어 순위만으로 총가치를 정할 수 없다.
대표 시험은 여러 활용률에서 완료 작업, 지속 주파수와 테일 지연 및 패키지·메모리·전체 에너지를 측정해야 한다. 급증과 서비스 목표를 위해 여유를 남기는 클라우드는 40% 활용 성능이 최고치보다 중요할 수 있다. AET가 패턴을 귀속해도 유리한 스레드·코어당 통계는 판단의 한 부분이다.
AMD와 Arm이 드러내는 비교 공백
Intel은 AMD EPYC 9965보다 평균 스레드 성능이 약 30% 높고 와트당 스레드 성능에서도 비슷한 이점이 있다고 주장한다. AMD는 Zen 5 192코어와 SMT로 384스레드를 제공한다. Clearwater Forest는 SMT 없는 물리 E-core 288개와 288스레드다. 따라서 스레드는 두 설계에서 같은 자원 단위가 아니다.
Tom’s Hardware 출시 보도는 광범위한 소켓 총성능 비교가 없다고 지적했다. 스레드 결과는 VM 크기, 라이선스와 지연 판단을 도와도 어느 소켓이 일을 더 끝내는지는 보여 주지 않는다. SMT는 자원을 공유하며 활용을 높이고 독립 E-core는 일부 vCPU–물리 코어 매핑에서 예측 가능할 수 있다. 모든 작업을 이기는 설계는 없다.
Xeon 6+는 AVX2를 지원하고 AVX-512·AVX10은 지원하지 않아 과학 시뮬레이션, HPC와 일부 벡터 중심 미디어·분석에 자연스러운 적합성이 줄어든다. Intel은 압축, 암호, 데이터 이동, 부하 분산과 인메모리 분석 가속기를 제공한다. 소프트웨어가 사용해야 이점이 생긴다. 선정 SHA·SM3의 큰 증가를 일반 코드에 적용해서는 안 된다.
AWS Graviton, Google Axion, Microsoft Cobalt와 상용 AmpereOne은 또 다른 효율·밀도 경쟁이다. Intel은 익숙한 x86에 cloud-native를 남기려 하지만 하이퍼스케일러는 다른 명령어를 지원할 만큼 소프트웨어를 통제하고 자체 Arm을 조달·시설 설계와 통합한다. Intel은 유리하다고 말하나 출시 시 광범위한 Arm 직접 비교가 부족했다. 친숙함은 이점이지 낮은 운영비 증명은 아니다.
공급이 호환성을 증거로 바꿔야 한다
CPU는 Xeon 6900P와 LGA 7529 소켓 계열을 공유한다. 기존 시스템은 공급자 검증 후 펌웨어로 Xeon 6+를 지원할 수 있다고 알려졌다. 실제 절감은 소켓명뿐 아니라 인증, 냉각, 전력, 메모리 토폴로지와 관리 지원에 달렸다. OEM 제품 확대는 초기 하이퍼스케일 배포를 넘었음을 확인할 것이다.
네 모델과 전력 프로필의 재현 가능한 독립 시험이 다음 성능 증거다. 클라우드, DB, 통신, VM, 저장장치, 압축과 암호 결과에는 지속 처리량, 전체 전력, 메모리 구성과 테일 지연이 따라야 한다. 330W 플래그십이 얼마의 일을 유지하는지가 주파수·처리량이 같은 비율로 떨어진다는 가정보다 중요하다.
안정적인 18A 공급과 큰 설치 기반은 제조 회복도 시험하며 어떤 소프트웨어가 288코어를 실제 쓰는지 보여 줄 것이다. 현재는 상위 최대 소켓 밀도, 192코어 절충, 144코어의 더 많은 코어당 대역·캐시·클록이라는 목표가 있다. 앱 병목, 전체 시스템 비용과 독립 측정을 함께 볼 때 가치가 드러난다.