
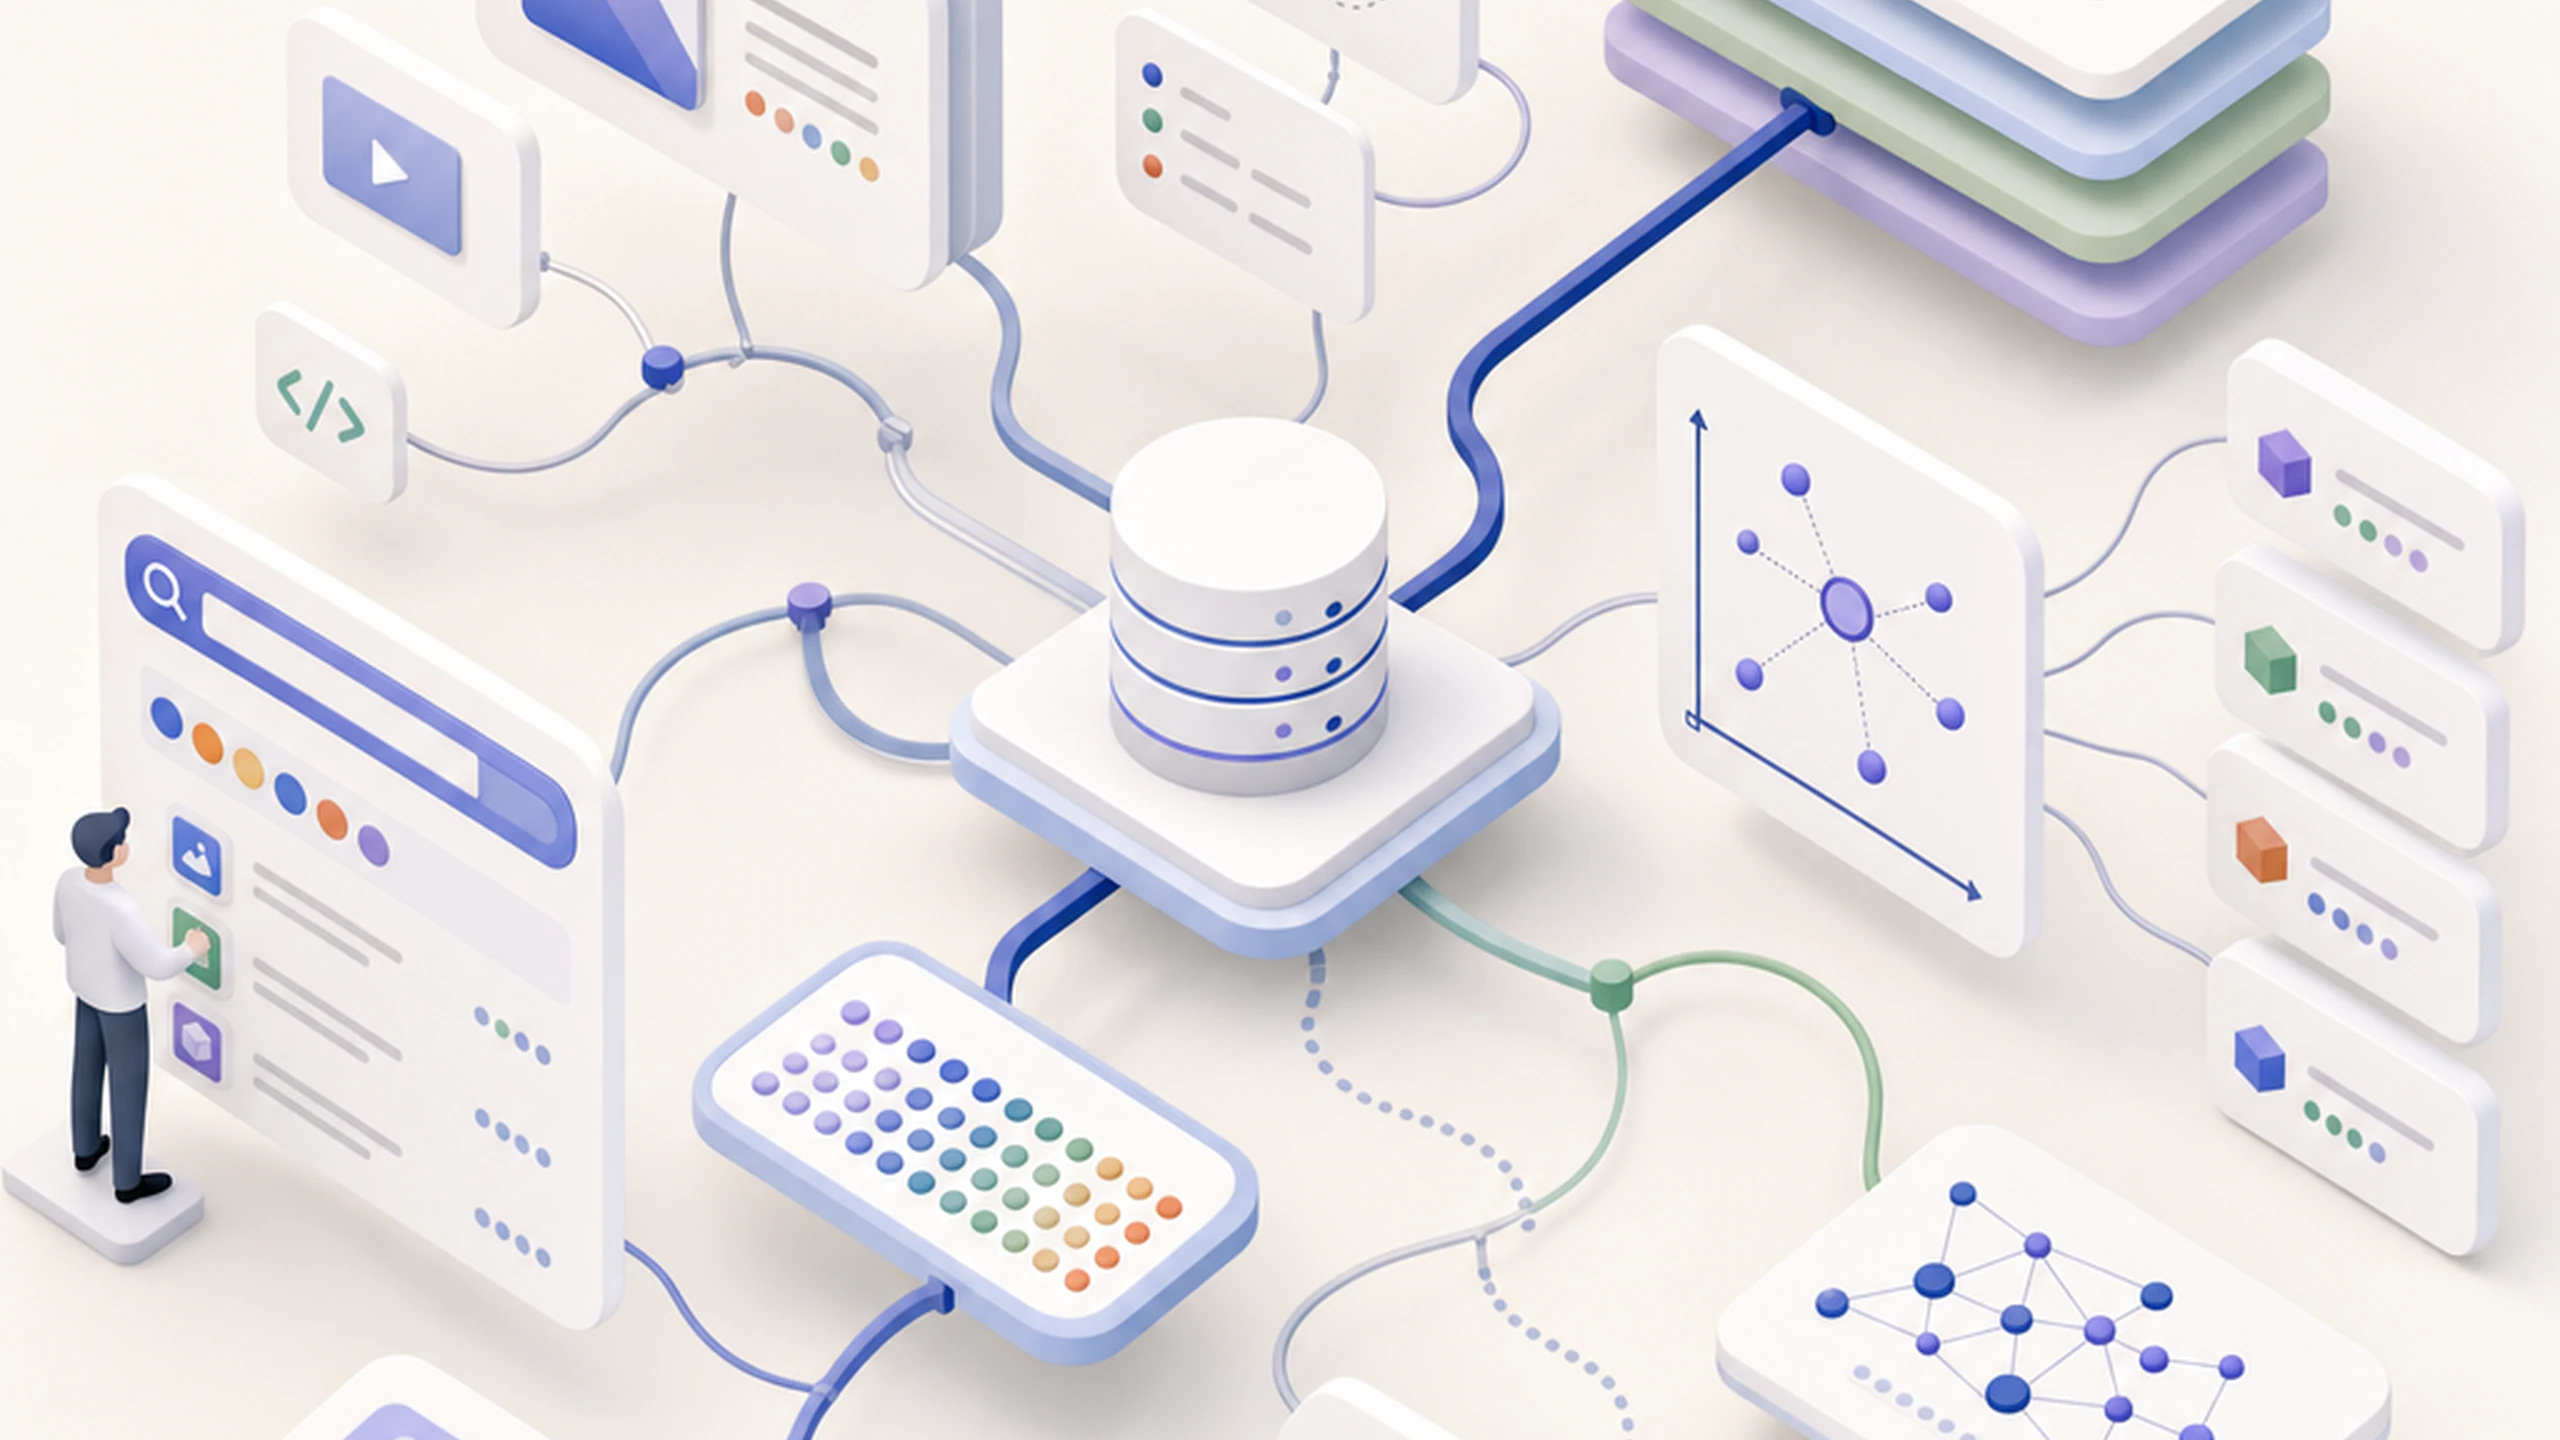
Eine Vektordatenbank speichert Daten als Zahlenfelder, sogenannte Vektoren, und durchsucht sie anhand mathematischer Distanz statt Textvergleich. Jeder Inhalt — Satz, Dokument oder Bild — wird in einen Vektor umgewandelt, der seine Bedeutung erfasst. Die Datenbank liefert Ergebnisse, indem sie Vektoren findet, die im hochdimensionalen Raum nahe am Anfragevektor liegen.
Ein Embedding ist eine numerische Repräsentation von Inhalt. Ein Machine-Learning-Modell, meist auf einer Transformer-Architektur aufgebaut, liest Text und gibt eine Liste von Zahlen aus, üblicherweise mit mehreren Hundert bis über Tausend Werten. Diese Zahlen kodieren Bedeutung: Sätze mit ähnlichen Themen erzeugen ähnliche Zahlen, während Sätze über unverbundene Themen andere erzeugen. „Leistungsbeurteilung“ und „Gespräch zur beruflichen Entwicklung“ erzeugen Embeddings, die im Vektorraum nahe beieinander liegen. „Leistungsbeurteilung“ und „Rezept für das Abendessen“ liegen weit auseinander.
Jeder gespeicherte Inhalt durchläuft vor dem Eintritt in die Datenbank ein Embedding-Modell. Das Modell liest den Inhalt und erzeugt einen Vektor fester Länge. Zwei Sätze, die dasselbe mit verschiedenen Worten sagen, produzieren nahe Embeddings. Zwei Sätze zu unverbundenen Themen produzieren weit entfernte Embeddings. Dieser Schritt erfolgt einmal pro Dokument beim Einlesen; die Embeddings werden neben dem Originalinhalt gespeichert.
Der Prozess ähnelt einer erfahrenen Bibliothekarin, die ein Buch liest und es nach Thema statt nur nach Titel in einen Bereich stellt. Das Embedding-Modell liest auf Bedeutung.
Millionen Embeddings zu speichern ist einfach. Die nächstgelegenen zu einer Anfrage in Millisekunden zu finden, erfordert einen Index. Vektordatenbanken verwenden Algorithmen für angenäherte nächste Nachbarn, etwa HNSW (Hierarchical Navigable Small World Graphs), um den Vektorraum so zu organisieren, dass ähnliche Vektoren nahe beieinander gruppiert sind. Laut der technischen Übersicht von Weaviate zu Vektor-Embeddings tauschen diese Indexstrukturen einen kleinen Teil der Abrufgenauigkeit gegen einen erheblichen Geschwindigkeitsgewinn. Für die meisten praktischen Anwendungen reichen angenäherte Ergebnisse aus, und der Leistungsvorteil ist groß.
Was gespeichert wird
- Traditionelle Datenbank: strukturierte Zeilen und Spalten oder Text, der nach seinen exakten Zeichen indexiert ist.
- Vektordatenbank: numerische Embeddings, die die Bedeutung unstrukturierter Inhalte darstellen.
Wie die Suche funktioniert
- Traditionelle Datenbank: sucht exakte oder musterpassende Werte, zeilenweise oder über einen Schlüsselwortindex.
- Vektordatenbank: berechnet die Distanz zwischen Anfrage-Embedding und gespeicherten Embeddings und liefert sortierte, angenäherte Treffer.
Wofür sie optimiert ist
- Traditionelle Datenbank: präzise Abfragen, Filterung, Transaktionen und Aggregationen auf strukturierten Daten.
- Vektordatenbank: Inhalte zu finden, die konzeptionell zu einer Anfrage passen, auch ohne gemeinsame Wörter.
Beste Eignung
- Traditionelle Datenbank: strukturierte Daten mit bekannten Schemata, bei denen exakte Antworten nötig sind — Nutzeraufzeichnungen, Finanztransaktionen, Inventarsysteme.
- Vektordatenbank: unstrukturierte Inhalte, Dokumente, Notizen, Audiotranskripte und Bilder, bei denen Bedeutung und Kontext wichtiger sind als exakter Text.
KI-Wissensbasen und Support-Tools. Kundensupport-Plattformen betten Dokumentation und frühere Support-Tickets in eine Vektordatenbank ein. Wenn ein Nutzer eine Anfrage stellt, ruft das System die semantisch ähnlichsten Dokumentationsabschnitte ab und zeigt sie dem Agenten oder direkt dem Nutzer, bevor ein Mensch eingreifen muss.
Persönliches Wissensmanagement. Nutzer, die über Monate oder Jahre Notizen, Webausschnitte und Dokumente erfassen, sammeln zu viele Inhalte an, um sie zuverlässig über Schlüsselwörter zu durchsuchen. Eine vektorbasierte Abrufschicht ermöglicht dem System, Einträge zu finden, die eine Frage beantworten, auch wenn sich der Nutzer weder an Formulierung noch Zeitpunkt erinnert.