
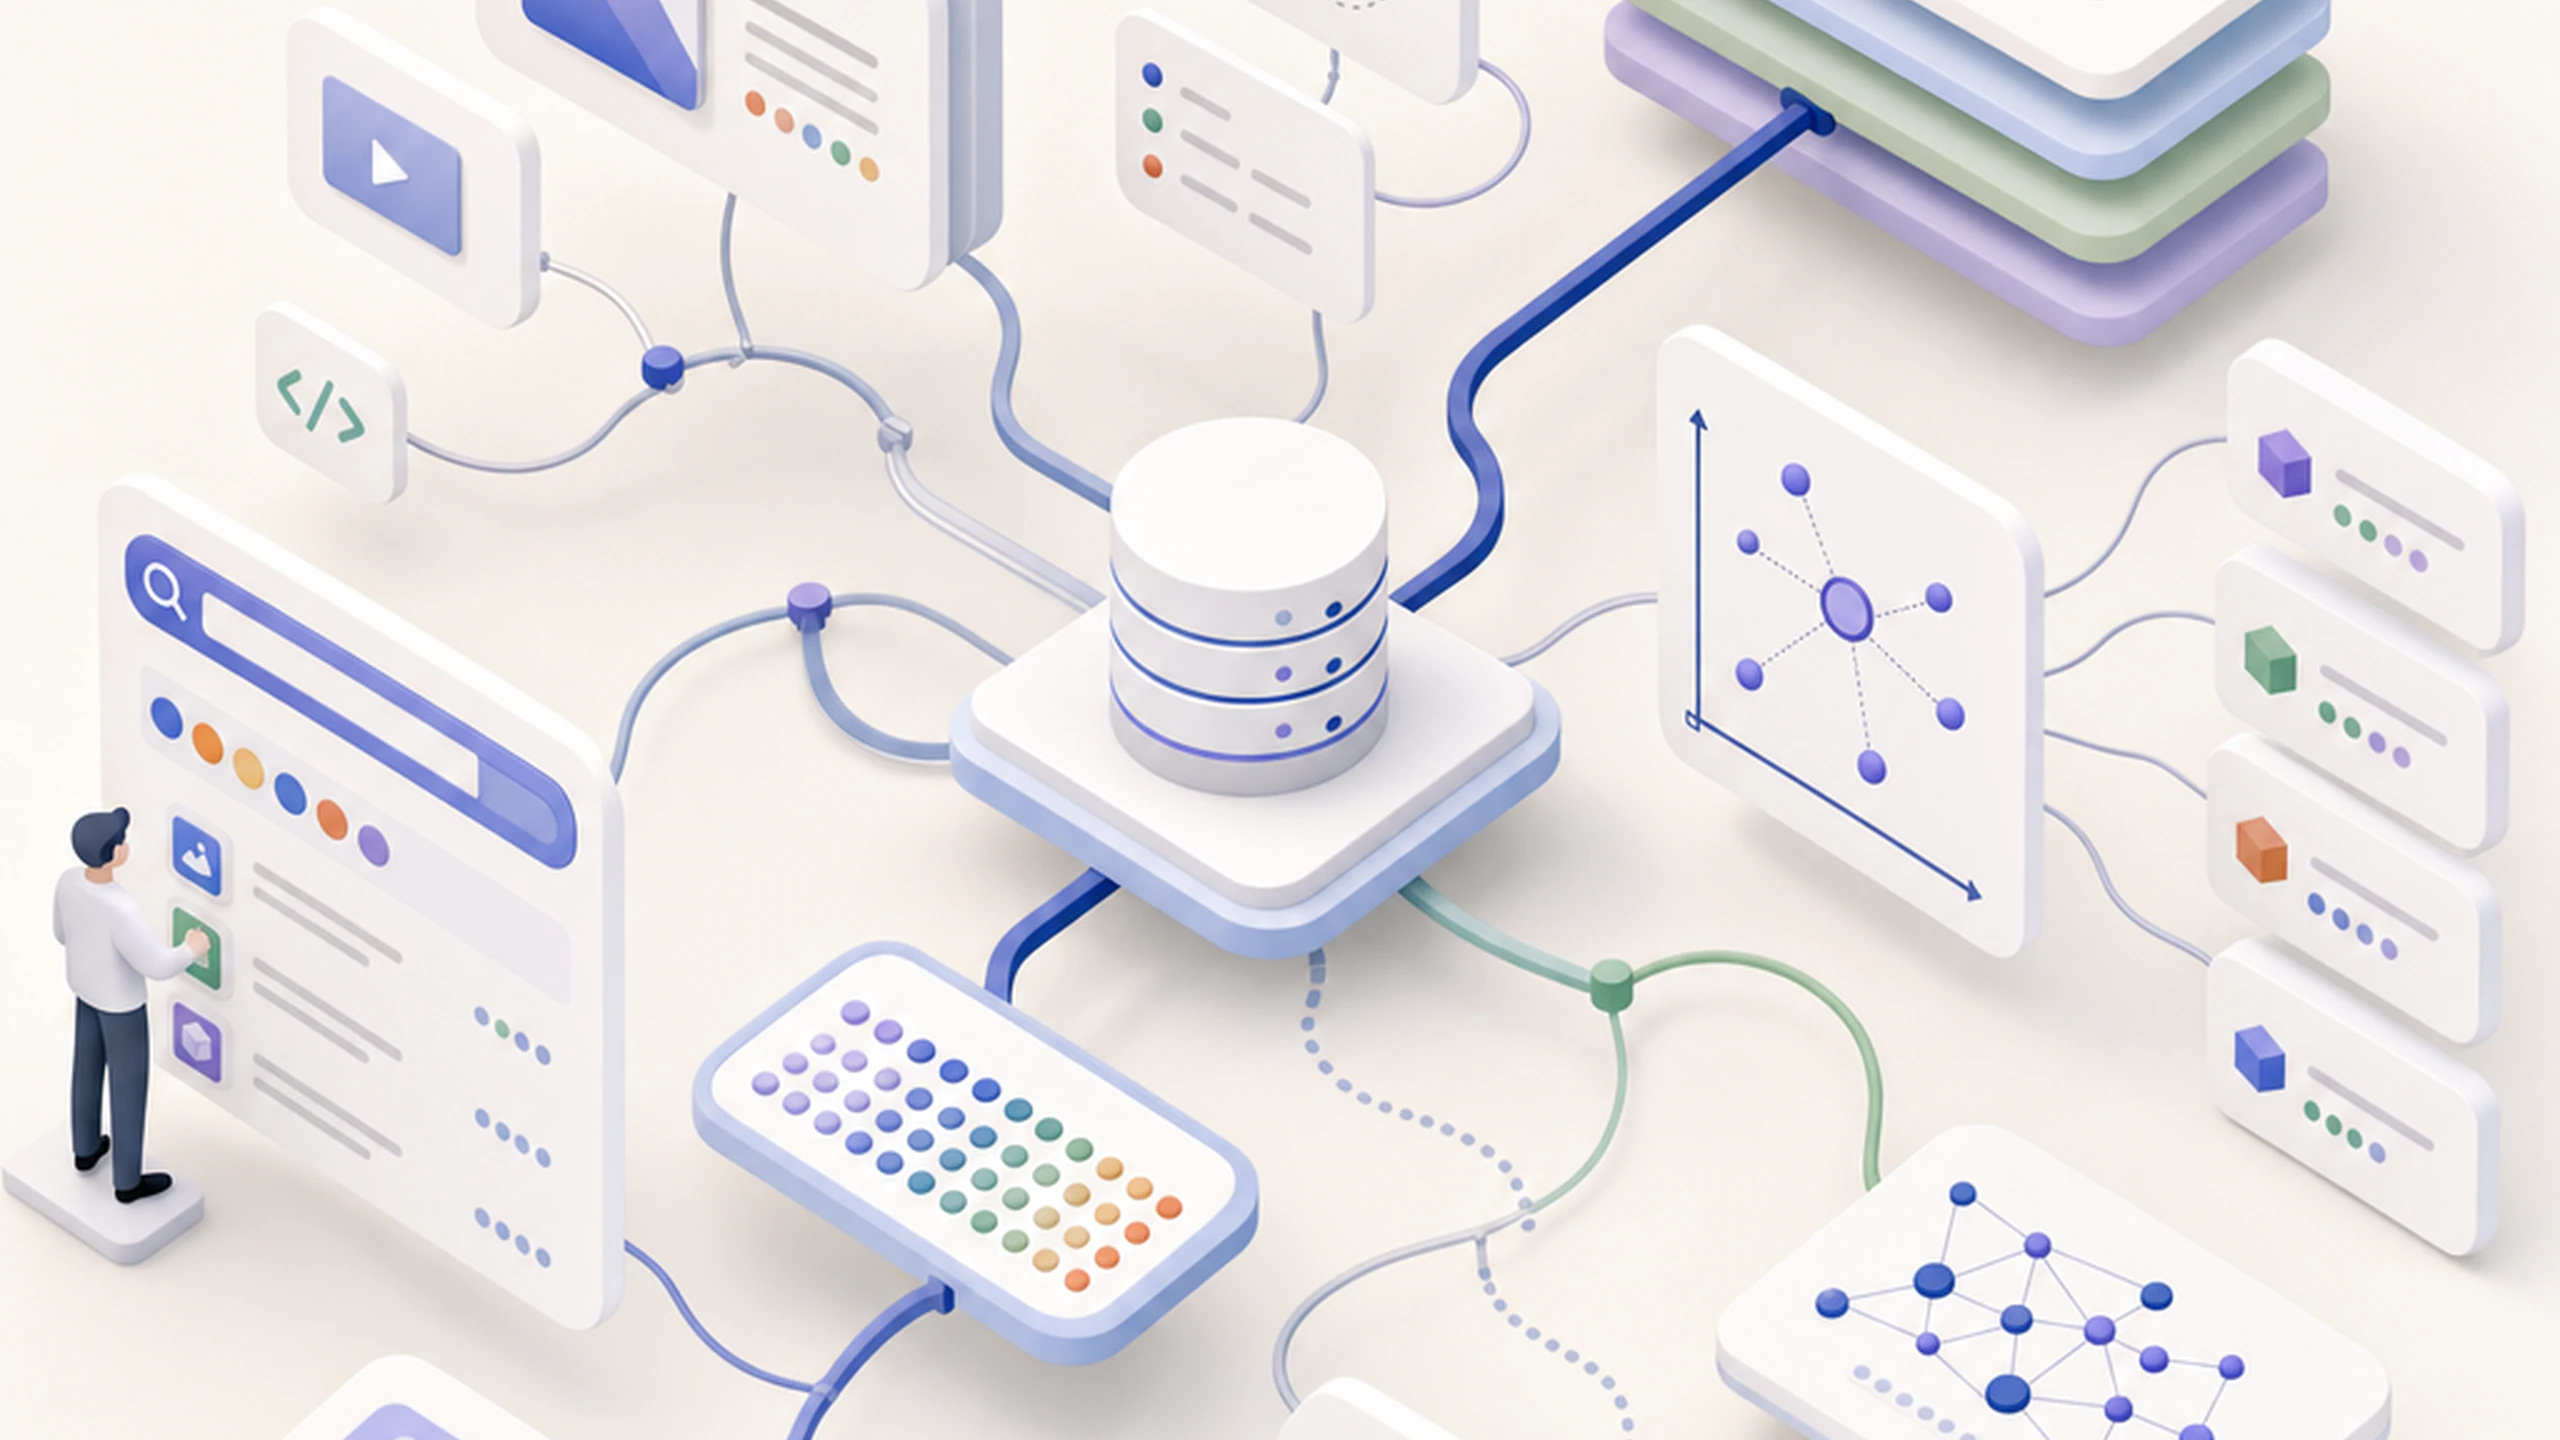
向量数据库将数据保存为一组称作向量的数字,并以数学距离而不是文字比较进行检索。无论是一句话、一篇文档还是一张图像,都会被转换为能表达其含义的向量;数据库在高维空间中寻找最靠近查询向量的结果。
嵌入向量是内容的数值表示。通常基于 Transformer 架构的机器学习模型读取一段文本,输出几百到上千个数值。这些数值编码了语义:主题相近的句子会得到相近的数值,不相关的话题则相距较远。“绩效评估”和“职业发展谈话”的嵌入会靠近,“绩效评估”和“今晚的晚餐食谱”则很远。
每段要储存的内容会在进入数据库前经过嵌入模型。模型读取内容并输出固定长度向量;表达相同意思但用词不同的两句话,向量会很接近;无关内容则相距较远。这一步在导入时为每份文档做一次,原文会和嵌入一起保存。
整个过程像一位熟练图书管理员:他按主题把书放入分类,而不是只按书名排序。嵌入模型是在按含义阅读。
储存数百万个嵌入并不困难;难点是毫秒内找到最近的结果。向量数据库使用近似最近邻算法,例如 HNSW 分层可导航小世界图,组织向量空间,让相似向量聚集。这样的索引以少量召回精度换取显著速度提升,对多数实际应用而言代价可接受。
储存内容
- 传统数据库:结构化行列,或按精确字符索引的文本。
- 向量数据库:表示非结构化内容含义的数值嵌入。
检索方式
- 传统数据库:逐行或经关键词索引寻找精确值或模式匹配。
- 向量数据库:计算查询嵌入和存储嵌入的距离,返回排序后的近似匹配。
优化目标
- 传统数据库:精确查找、过滤、事务和结构化数据聚合。
- 向量数据库:即使没有共同词,也能找到与查询概念相关的内容。
适用场景
- 传统数据库:有确定模式、要求精确答案的结构化数据,如用户记录、财务交易和库存。
- 向量数据库:文档、笔记、音频转录、图像等非结构化内容,含义与上下文比精确文字更重要。
AI 知识库和支持工具会把帮助文档与历史工单嵌入向量数据库。用户提出请求时,系统先找到语义最接近的文档片段,提供给客服人员或直接呈现给用户。
个人知识管理同样受益。积累数月或数年的笔记、网页剪藏和文档后,用户很难再靠关键词可靠搜索;向量检索让系统在用户忘记自己何时、如何记录时,仍能找到可以回答问题的条目。