
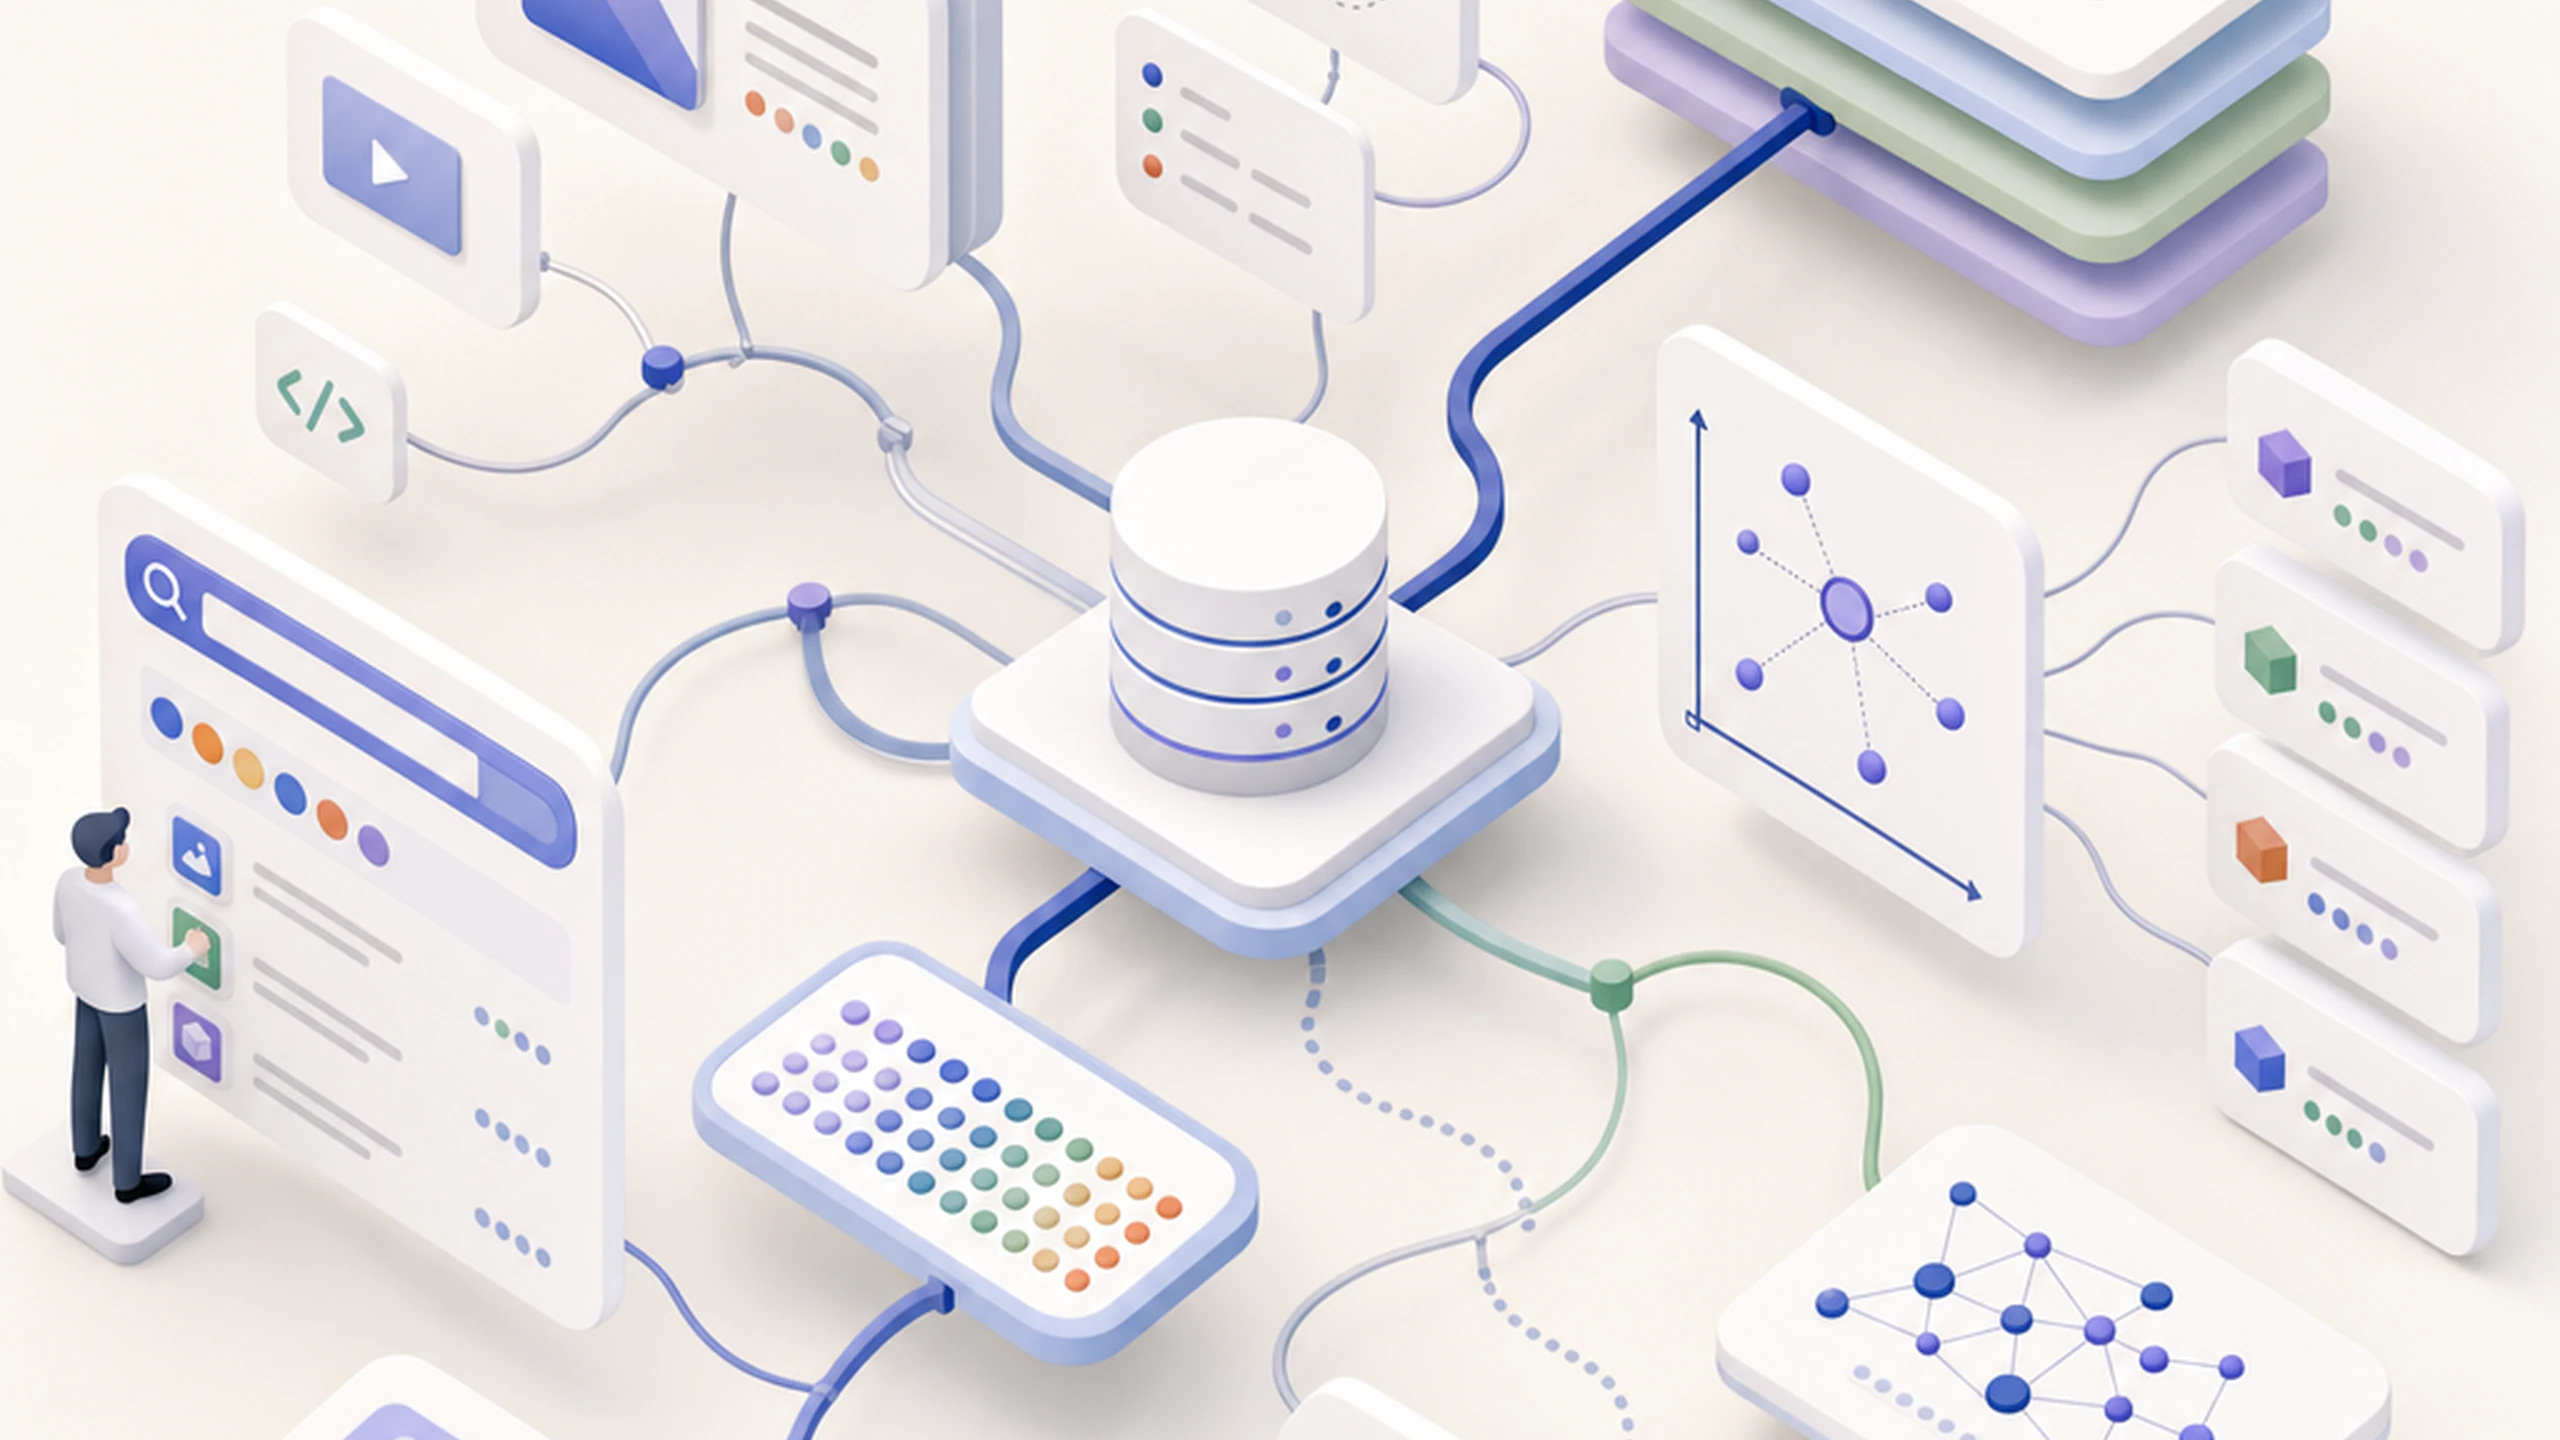
벡터 데이터베이스는 데이터를 벡터라는 숫자 배열로 저장하고 텍스트 비교가 아니라 수학적 거리로 검색합니다. 문장, 문서, 이미지 등 모든 콘텐츠는 의미를 담은 벡터로 변환됩니다. 데이터베이스는 고차원 공간에서 질의 벡터와 가까운 벡터를 찾아 결과를 반환합니다.
임베딩은 콘텐츠의 수치 표현입니다. 보통 transformer 아키텍처 기반의 머신러닝 모델이 텍스트를 읽고 수백 개에서 1,000개가 넘는 숫자 목록을 출력합니다. 숫자는 의미를 부호화해 주제가 비슷한 문장은 비슷하게, 무관한 문장은 다르게 나타냅니다. ‘성과 평가’와 ‘경력 개발 대화’의 임베딩은 벡터 공간에서 가깝지만, ‘성과 평가’와 ‘오늘 저녁 요리법’은 멀리 떨어집니다.
저장하는 모든 콘텐츠는 데이터베이스에 들어가기 전에 임베딩 모델을 거칩니다. 모델은 콘텐츠를 읽고 고정 길이 벡터를 출력합니다. 같은 내용을 다른 말로 표현한 두 문장은 가까운 임베딩을 만들고, 무관한 문장은 멀어집니다. 문서마다 수집 시 한 번 실행하며 임베딩은 원문과 함께 저장됩니다.
숙련된 사서가 제목만으로 정렬하지 않고 책을 읽어 주제에 맞는 구역에 배치하는 것과 비슷합니다. 임베딩 모델은 의미를 읽습니다.
수백만 개 임베딩을 저장하는 것은 어렵지 않습니다. 질의와 가장 가까운 것을 밀리초 안에 찾으려면 색인이 필요합니다. 벡터 데이터베이스는 HNSW(계층적 탐색 가능 소세계 그래프) 같은 근사 최근접 이웃(ANN) 알고리즘으로 비슷한 벡터를 가깝게 묶습니다. Weaviate의 기술 설명에 따르면 이 구조는 검색 정확도를 조금 양보하고 속도를 크게 높입니다. 대부분의 실제 용도에서는 근사 결과로 충분하며 성능 이점이 큽니다.
저장 대상
- 전통적 데이터베이스: 구조화된 행과 열 또는 정확한 문자로 색인된 텍스트
- 벡터 데이터베이스: 비정형 콘텐츠의 의미를 표현하는 수치 임베딩
검색 방식
- 전통적 데이터베이스: 행 단위 또는 키워드 색인으로 정확하거나 패턴이 일치하는 값을 찾음
- 벡터 데이터베이스: 질의 임베딩과 저장 임베딩의 거리를 계산해 순위가 있는 근사 결과를 반환함
최적화 대상
- 전통적 데이터베이스: 구조화된 데이터의 정확한 조회, 필터링, 트랜잭션, 집계
- 벡터 데이터베이스: 공통 단어가 없어도 질의와 개념적으로 관련된 콘텐츠 검색
적합한 용도
- 전통적 데이터베이스: 사용자 기록, 금융 거래, 재고 시스템처럼 스키마가 정해지고 정확한 답이 필요한 구조화 데이터
- 벡터 데이터베이스: 정확한 글자보다 의미와 맥락이 중요한 문서, 노트, 음성 녹취록, 이미지 같은 비정형 콘텐츠
AI 지식 베이스와 지원 도구. 고객 지원 플랫폼은 문서와 과거 티켓을 임베딩해 벡터 데이터베이스에 넣습니다. 사용자가 요청하면 의미적으로 가장 가까운 문서 구역을 찾아 상담원이나 사용자에게 제시해 사람이 개입하기 전에 도움을 줍니다.
개인 지식 관리. 수개월 또는 수년간 노트, 웹 스크랩, 문서를 모으면 키워드만으로 안정적으로 찾기 어려울 만큼 양이 늘어납니다. 벡터 기반 검색 계층은 사용자가 무엇을 언제 썼는지 기억하지 못해도 질문에 답하는 항목을 찾습니다.