
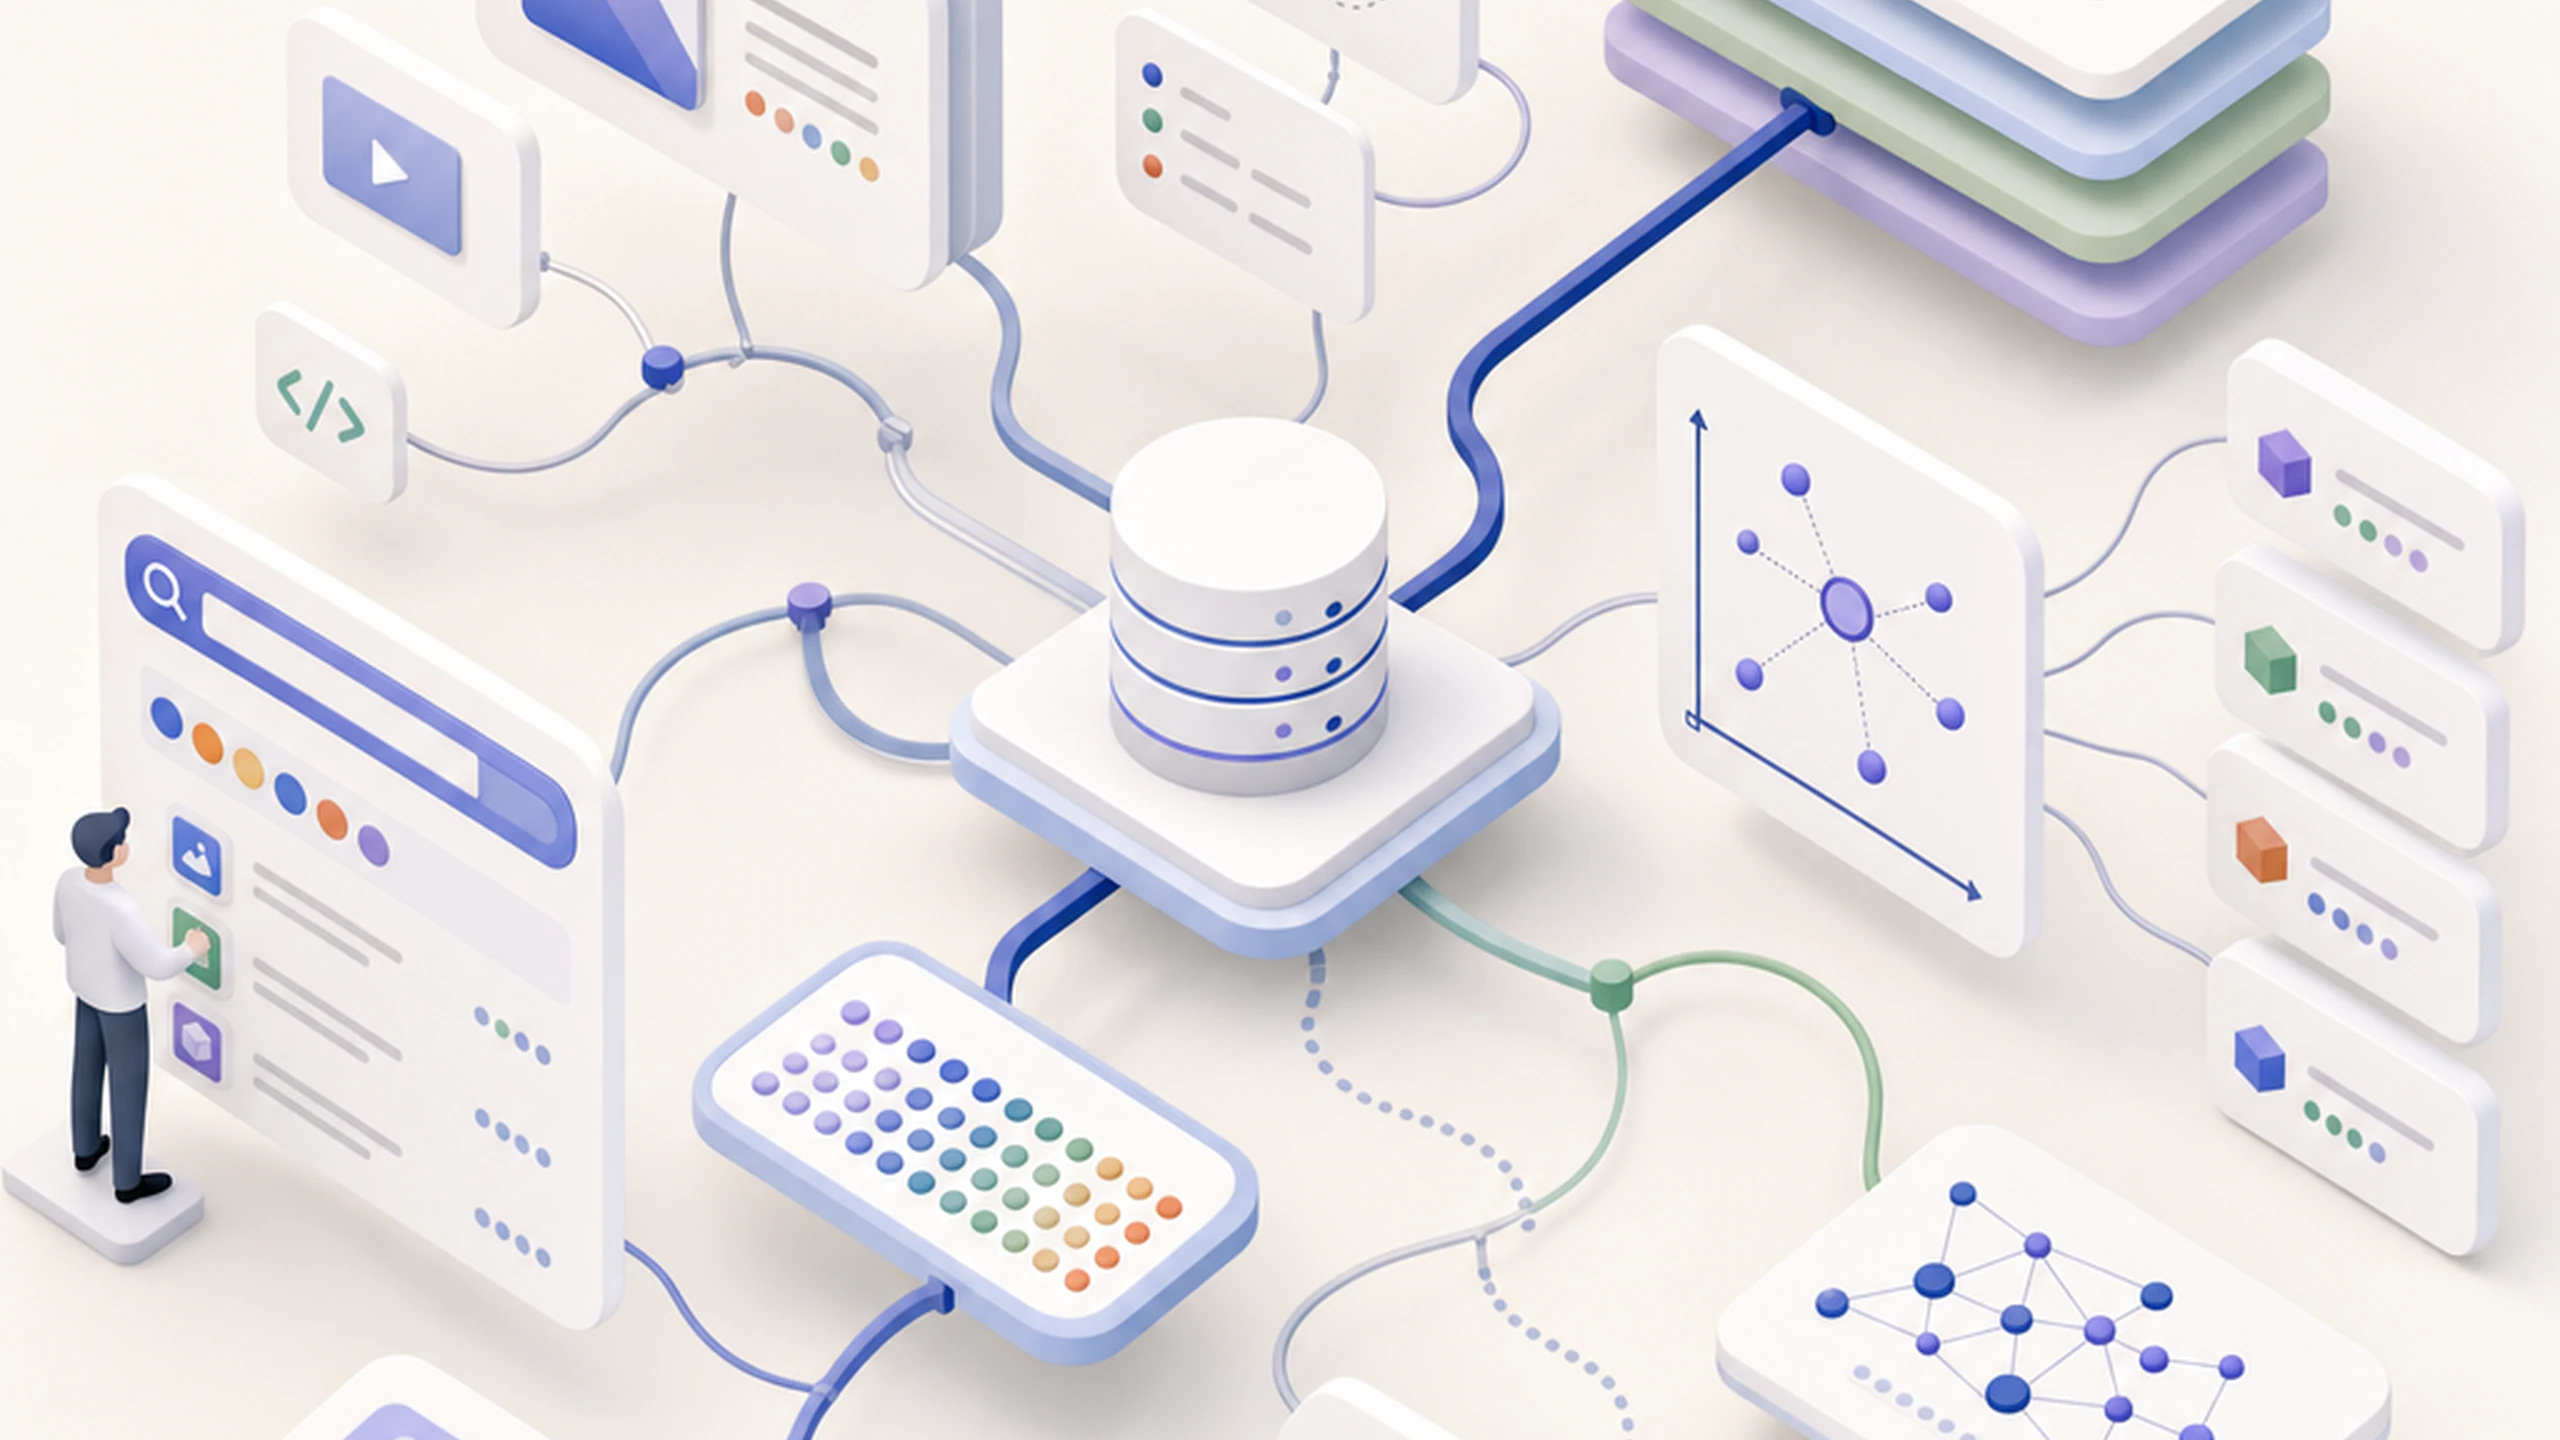
Une base de données vectorielle stocke les données sous forme de tableaux de nombres appelés vecteurs et effectue ses recherches selon une distance mathématique plutôt qu’une comparaison de texte. Chaque élément de contenu, qu’il s’agisse d’une phrase, d’un document ou d’une image, est converti en vecteur qui capture sa signification. La base récupère les résultats en trouvant les vecteurs proches du vecteur de la requête dans un espace à grande dimension.
Un embedding est une représentation numérique d’un contenu. Un modèle d’apprentissage automatique, généralement fondé sur une architecture de type transformeur, lit un texte et produit une liste de nombres, habituellement de plusieurs centaines à plus d’un millier de valeurs. Ces nombres encodent le sens : des phrases aux thèmes similaires produisent des nombres proches, tandis que des phrases sur des sujets sans rapport produisent des nombres différents. Les expressions « entretien d’évaluation » et « entretien d’évolution professionnelle » produisent des embeddings proches dans l’espace vectoriel. Les expressions « entretien d’évaluation » et « recette du dîner de ce soir » sont très éloignées.
Chaque élément de contenu que vous stockez passe par un modèle d’embedding avant d’entrer dans la base de données. Le modèle lit le contenu et produit un vecteur de longueur fixe. Deux phrases qui expriment la même idée avec des mots différents produisent des embeddings proches. Deux phrases sur des sujets sans rapport produisent des embeddings éloignés. Cette étape intervient une seule fois par document, lors de l’ingestion, et les embeddings sont stockés avec le contenu d’origine.
L’ensemble du processus ressemble à celui d’un bibliothécaire compétent qui lit un livre et le place dans une section selon son sujet, au lieu de le classer uniquement par titre. Le modèle d’embedding lit en cherchant le sens.
Stocker des millions d’embeddings est simple. Trouver les plus proches d’une requête en quelques millisecondes exige un index. Les bases de données vectorielles utilisent des algorithmes de voisinage approximatif (ANN), tels que HNSW (Hierarchical Navigable Small World graphs), pour organiser l’espace vectoriel afin que des vecteurs similaires soient regroupés. Selon la présentation technique des embeddings vectoriels de Weaviate, ces structures d’indexation échangent une faible part de précision de récupération contre un gain de vitesse significatif. Pour la plupart des applications pratiques, les résultats approximatifs sont suffisants et le gain de performance est important.
Ce qui est stocké
- Base de données traditionnelle : lignes et colonnes structurées, ou texte indexé par ses caractères exacts.
- Base de données vectorielle : embeddings numériques qui représentent le sens de contenu non structuré.
Fonctionnement de la recherche
- Base de données traditionnelle : recherche des valeurs exactes ou correspondant à un motif, ligne par ligne ou via un index de mots-clés.
- Base de données vectorielle : calcule la distance entre l’embedding de la requête et les embeddings stockés, puis renvoie des correspondances approximatives classées.
Ce pour quoi elles sont optimisées
- Base de données traditionnelle : recherches précises, filtrage, transactions et agrégations sur des données structurées.
- Base de données vectorielle : trouver un contenu conceptuellement lié à une requête, même sans mot commun.
Cas d’usage idéal
- Base de données traditionnelle : données structurées avec des schémas connus, nécessitant des réponses exactes. Fiches utilisateurs, transactions financières, systèmes d’inventaire.
- Base de données vectorielle : contenu non structuré, documents, notes, transcriptions audio et images, lorsque le sens et le contexte comptent davantage que le texte exact.
Les bases de connaissances et outils d’assistance IA. Les plateformes de support client vectorisent la documentation et les tickets d’assistance précédents dans une base de données vectorielle. Lorsqu’un utilisateur soumet une demande, le système récupère les sections de documentation sémantiquement les plus proches et les présente à l’agent ou directement à l’utilisateur, avant qu’une intervention humaine ne soit nécessaire.
La gestion des connaissances personnelles. Les personnes qui capturent des notes, des extraits web et des documents pendant des mois ou des années accumulent trop de contenu pour pouvoir effectuer une recherche fiable par mots-clés. Une couche de récupération fondée sur les vecteurs permet au système de trouver les entrées qui répondent à une question, même lorsque l’utilisateur ne se souvient plus de ce qu’il a écrit ou du moment où il l’a écrit.