
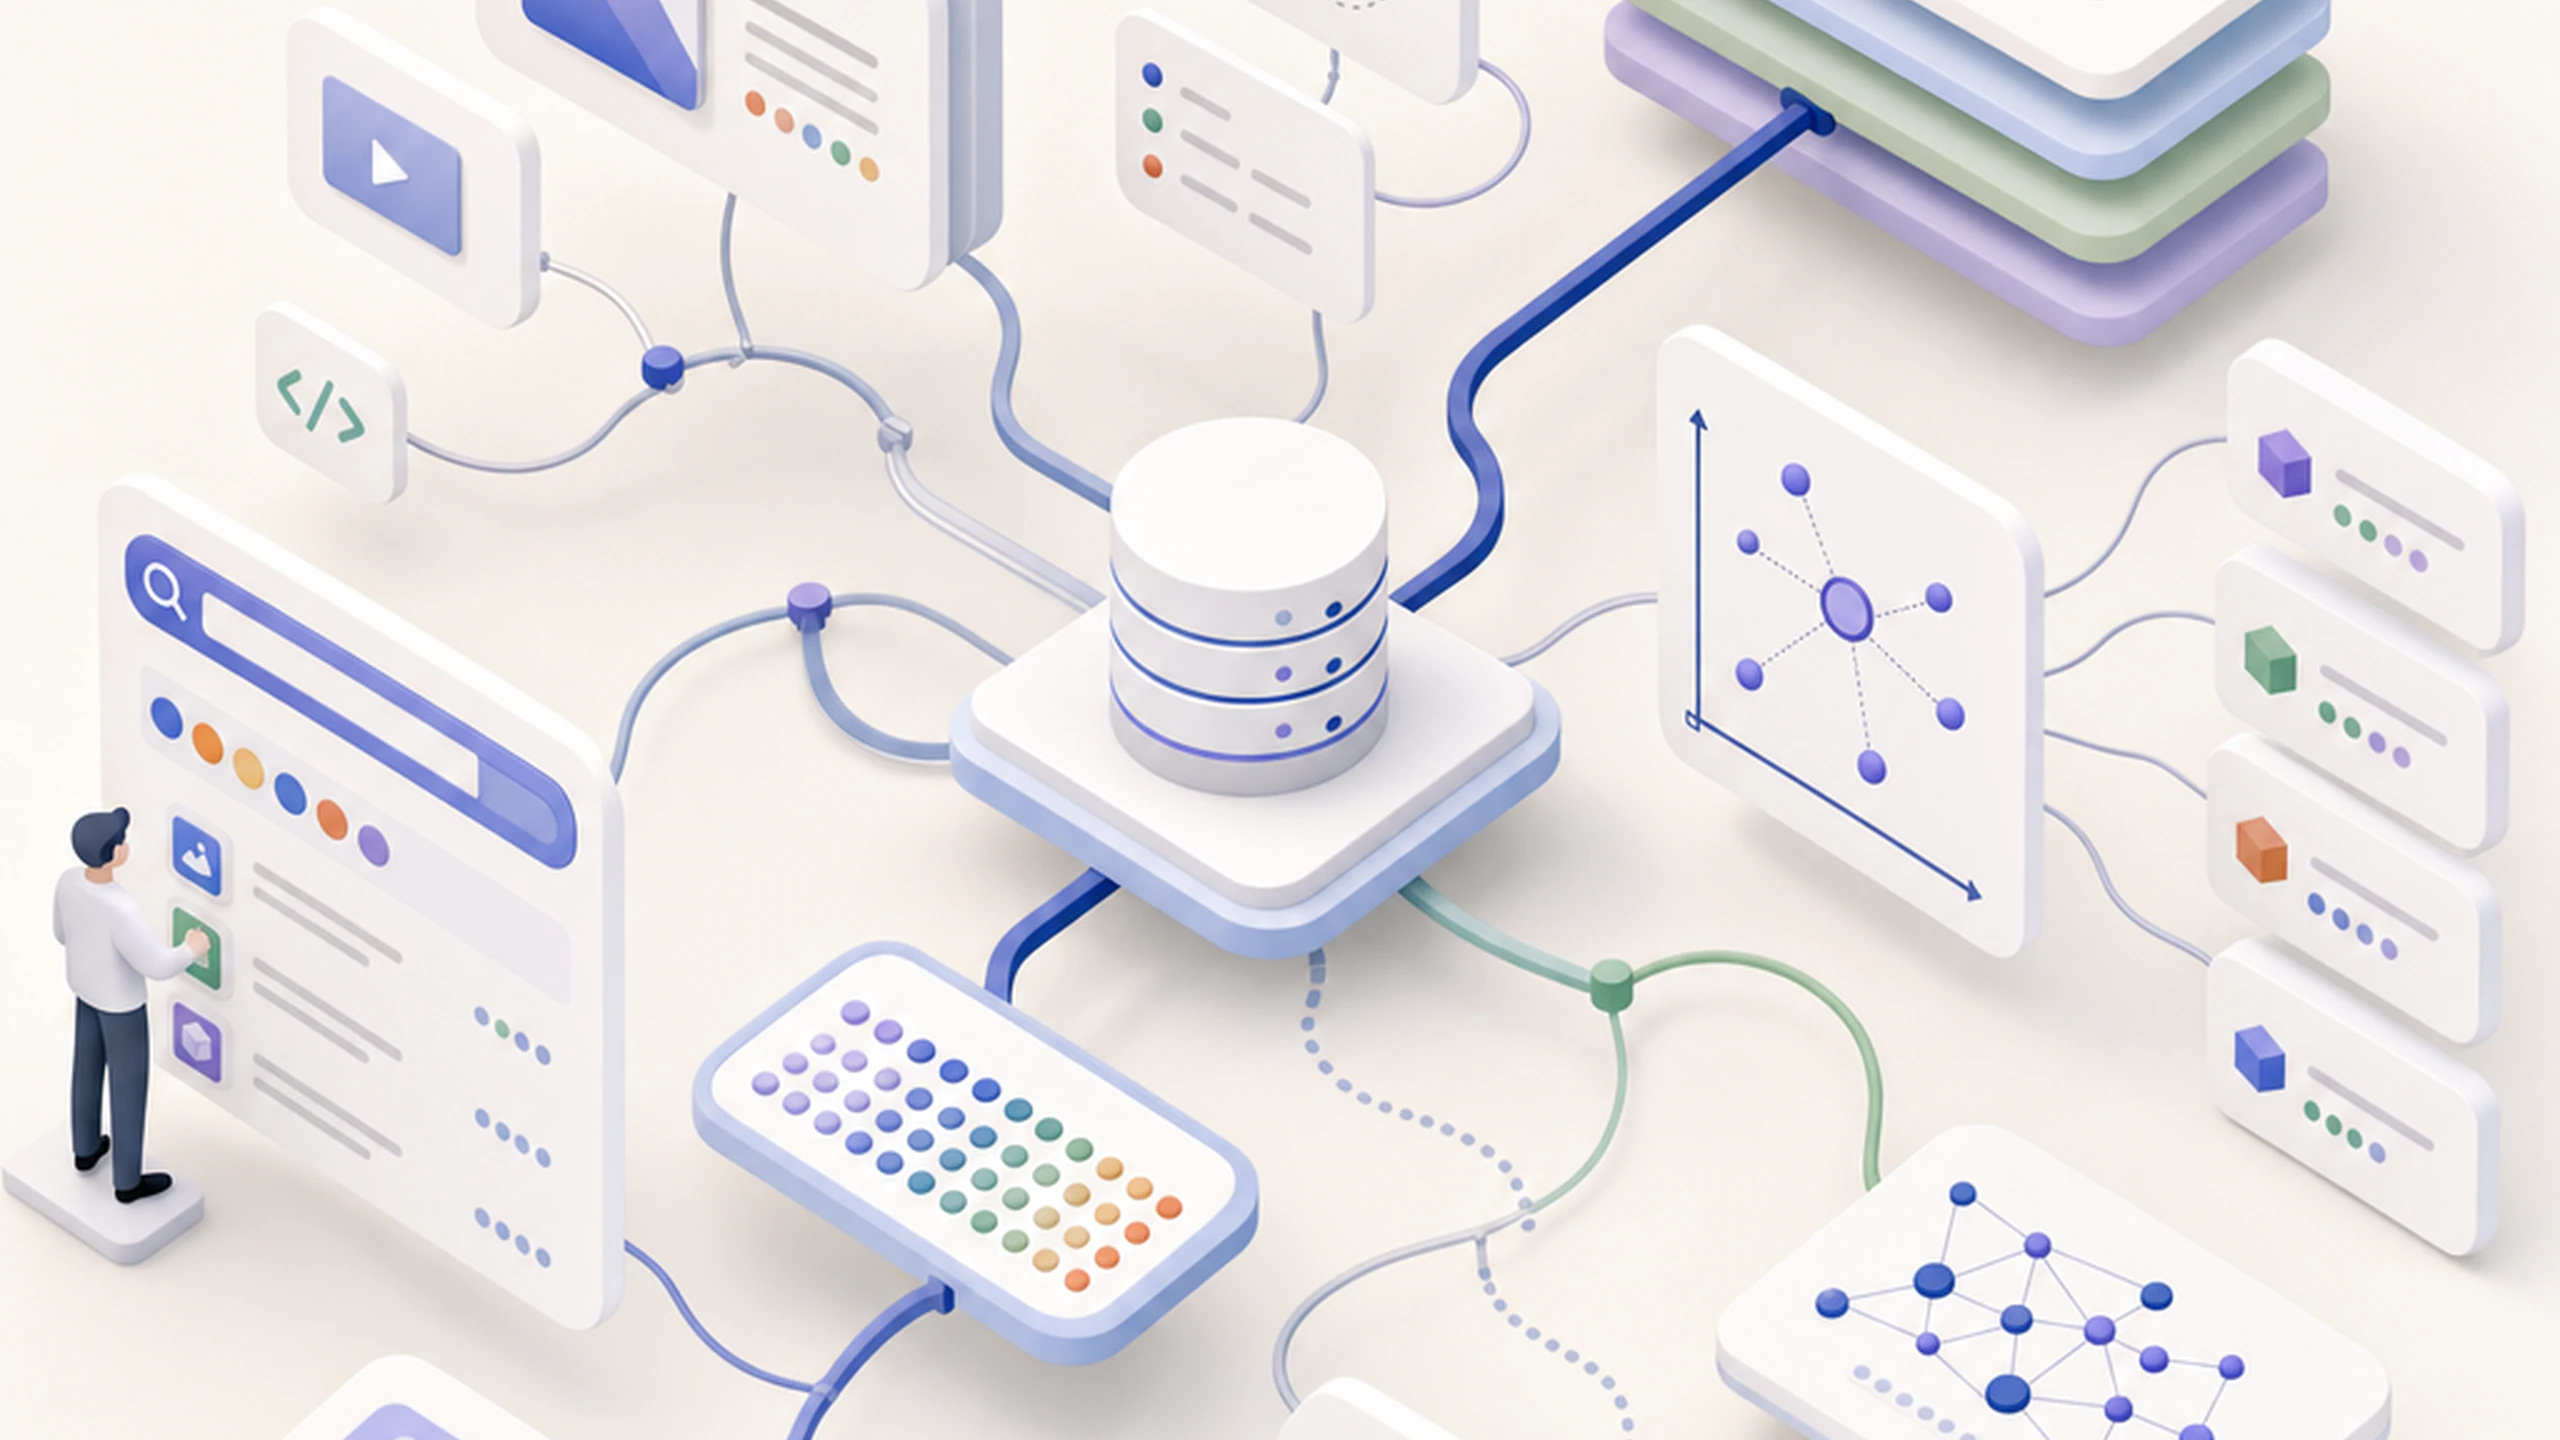
ベクトルデータベースは、ベクトルと呼ばれる数値の配列としてデータを保存し、テキスト比較ではなく数学的距離を使って検索します。文、文書、画像などの各コンテンツは、その意味を捉えたベクトルに変換されます。データベースは、高次元空間でクエリベクトルに近いベクトルを見つけて結果を取得します。
埋め込みはコンテンツの数値表現です。通常はトランスフォーマーアーキテクチャにもとづく機械学習モデルがテキストを読み、通常数百から千を超える値の数値リストを出力します。これらの数値は意味を符号化します。似た話題の文は似た数値を生み、無関係な話題の文は異なる数値を生みます。「人事評価」と「キャリア開発の面談」はベクトル空間で近くに置かれる埋め込みを生みます。「人事評価」と「今夜の夕食レシピ」は遠く離れます。
保存するすべてのコンテンツは、データベースに入る前に埋め込みモデルを通ります。モデルはコンテンツを読み、固定長のベクトルを出力します。同じことを異なる言葉で述べる二つの文は近い埋め込みを生みます。無関係な話題の二つの文は遠い埋め込みを生みます。このステップは取り込み時に文書ごと一度行われ、埋め込みは元のコンテンツとともに保存されます。
この全体の仕組みは、熟練した司書が本を読み、タイトル順に並べるだけでなく主題にもとづいて棚へ置く方法に似ています。埋め込みモデルは意味を読むのです。
何百万もの埋め込みを保存することは簡単です。クエリに最も近いものをミリ秒単位で見つけるにはインデックスが必要です。ベクトルデータベースは、HNSW(Hierarchical Navigable Small Worldグラフ)のような近似最近傍(ANN)アルゴリズムを使い、似たベクトルが互いに近くに集まるようベクトル空間を整理します。Weaviateのベクトル埋め込みに関する技術概要によれば、これらのインデックス構造は、少量の取得精度と引き換えに大幅な速度向上を得ます。多くの実用アプリケーションでは近似結果で十分であり、性能上の利点は大きいものです。
保存されるもの
- 従来のデータベース:構造化された行と列、または完全な文字列でインデックス化されたテキスト。
- ベクトルデータベース:非構造化コンテンツの意味を表す数値埋め込み。
検索の仕組み
- 従来のデータベース:行ごと、またはキーワードインデックス経由で、完全一致またはパターン一致の値を探す。
- ベクトルデータベース:クエリ埋め込みと保存済み埋め込みの距離を計算し、順位付きの近似一致を返す。
最適化の対象
- 従来のデータベース:構造化データに対する正確な検索、フィルタリング、トランザクション、集計。
- ベクトルデータベース:共有語がなくても、クエリと概念的に関連するコンテンツを見つけること。
最適な用途
- 従来のデータベース:正確な回答が必要な既知スキーマの構造化データ。ユーザー記録、金融取引、在庫システム。
- ベクトルデータベース:文書、メモ、音声文字起こし、画像など、完全なテキストより意味と文脈が重要な非構造化コンテンツ。
AIナレッジベースとサポートツールです。カスタマーサポートプラットフォームは、ドキュメントと過去のサポートチケットをベクトルデータベースに埋め込みます。ユーザーが依頼を送ると、人が介入する前に、システムは意味的に最も近いドキュメントのセクションを取得し、エージェントまたはユーザーへ直接提示します。
パーソナルナレッジマネジメントです。数か月または数年にわたりメモ、ウェブクリップ、文書を保存するユーザーは、キーワードでは信頼して検索できないほど多くのコンテンツを蓄積します。ベクトルを利用した取得層により、ユーザーが何を書いたか、いつ書いたかを覚えていなくても、質問に答える項目をシステムが見つけられます。