
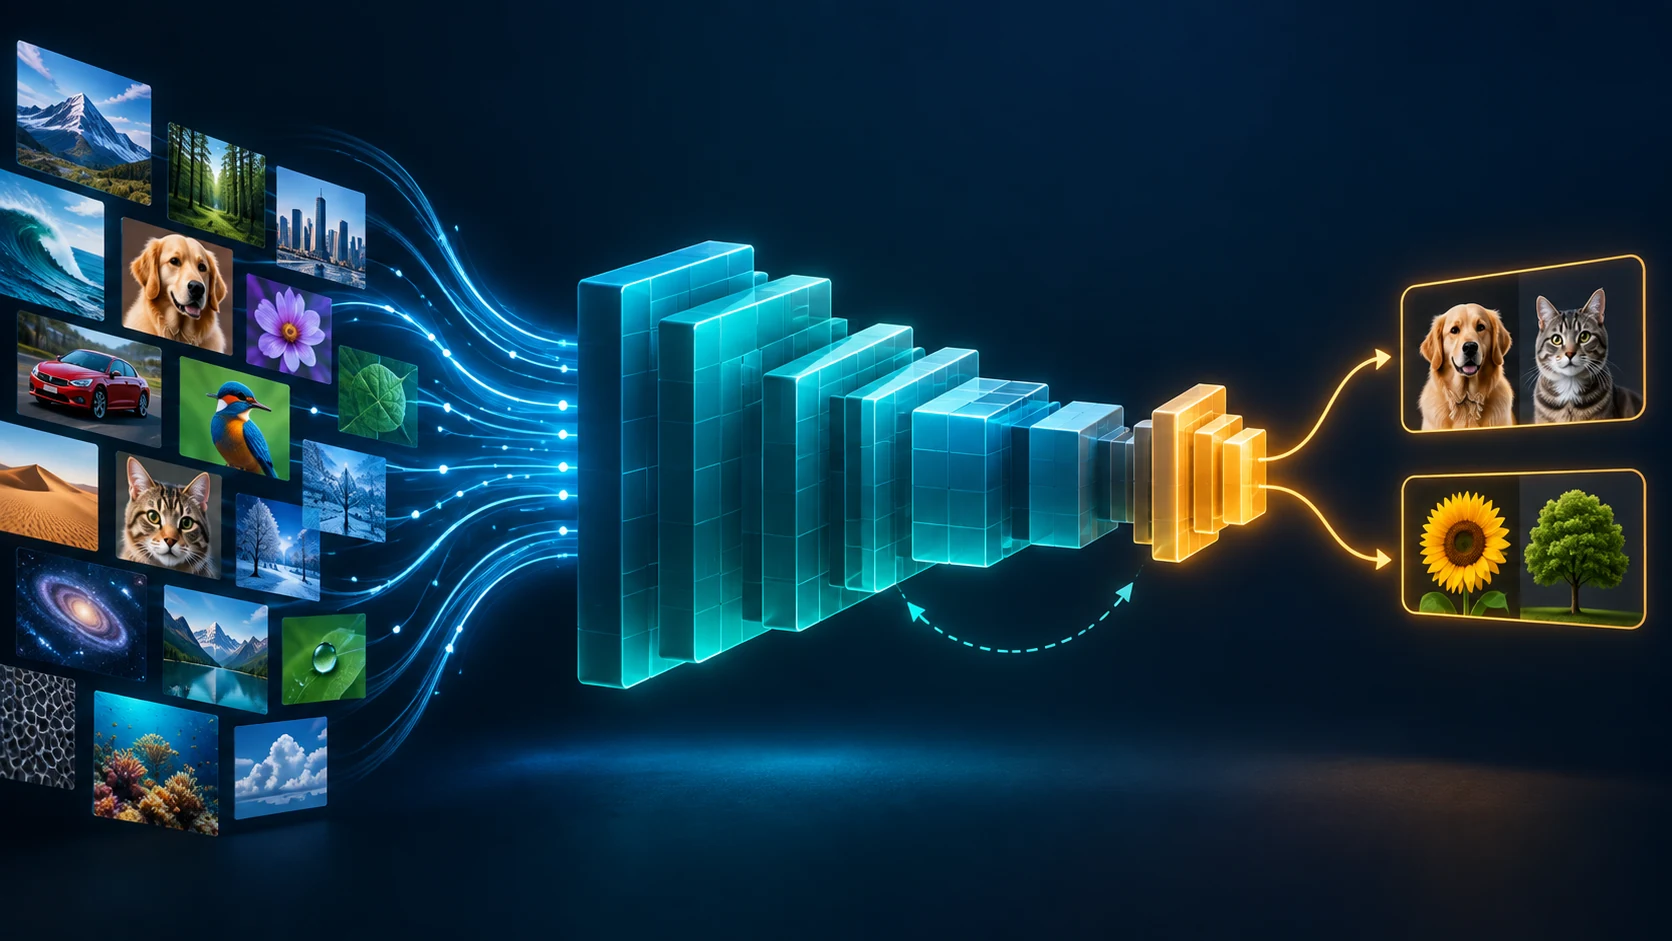
Beim Transfer Learning wird ein Modell, das bereits für eine Aufgabe oder einen Datensatz trainiert wurde, an eine neue Aufgabe angepasst. Statt alle Merkmale aus zufälligen Gewichten neu zu lernen, kann ein Team eine vortrainierte Repräsentation verwenden. Das ist bei wenigen markierten Beispielen oft hilfreich, doch der Nutzen hängt von der Ähnlichkeit zwischen Ausgangs- und Zielaufgabe ab. Eine feste Ersparnis an Trainingsdaten gilt nicht für jedes Projekt.
Zwei verbreitete Wege. Bei der Merkmalsextraktion bleibt das vortrainierte Grundmodell eingefroren; nur ein neuer Ausgabekopf wird mit Zieldaten trainiert. Beim Fine-Tuning wird zunächst ein brauchbarer Ausgabekopf aufgebaut und danach werden zusätzlich einige vortrainierte Schichten aktualisiert. Das TensorFlow-Tutorial zur Bildklassifikation beschreibt diese Reihenfolge und warnt davor, einen zufällig initialisierten Kopf sofort zusammen mit dem gesamten Grundmodell stark zu verändern: Nützliche Merkmale können dadurch verloren gehen. PyTorch stellt beide Ansätze an einem kleinen Bilddatensatz gegenüber. Sprachmodelle folgen der Grundidee vortrainierter Gewichte, unterscheiden sich aber in Aufbau und Training.
Ein fairer Test. Definieren Sie zuerst Zielaufgabe und getrennten Testsatz. Vergleichen Sie mit derselben Datenaufteilung eine einfache Baseline, eingefrorene Merkmale und einen vorsichtig abgestimmten Fine-Tuning-Lauf. Erfassen Sie Qualität, Trainings- und Inferenzkosten sowie typische Fehler. Wenn sich Zieldaten stark von den Vortrainingsdaten unterscheiden, prüfen Sie ausdrücklich, ob übertragene Merkmale helfen oder schaden. Ein Ergebnis aus einem Tutorial verspricht keine Leistung für medizinische Bilder, Werkskameras oder juristische Texte.
Wann es scheitern kann. Negativer Transfer liegt vor, wenn Wissen aus der Ausgangsaufgabe die Leistung bei der Zielaufgabe verschlechtert. Unterschiede zwischen Domänen oder Labels und unpassende Vorverarbeitung können dazu beitragen. Kleine Zieldatensätze können überangepasst werden; aggressives Fine-Tuning kann vorhandene Fähigkeiten beeinträchtigen. Behalten Sie einen Validierungssatz und beurteilen Sie den Erfolg nicht allein nach der Trainingsgenauigkeit.
Wie viele Labels spart es? Es gibt keine allgemeingültigen Werte wie zehn- oder hundertfach. Modell, Aufgabenähnlichkeit, gewünschte Qualität und Messmethode bestimmen den Bedarf. Eine Lernkurve auf den eigenen Zieldaten ist aussagekräftiger als ein pauschaler Multiplikator.
Quellen: TensorFlow-Tutorial, PyTorch-Tutorial, Hugging-Face-Leitfaden, Studie zu negativem Transfer.