
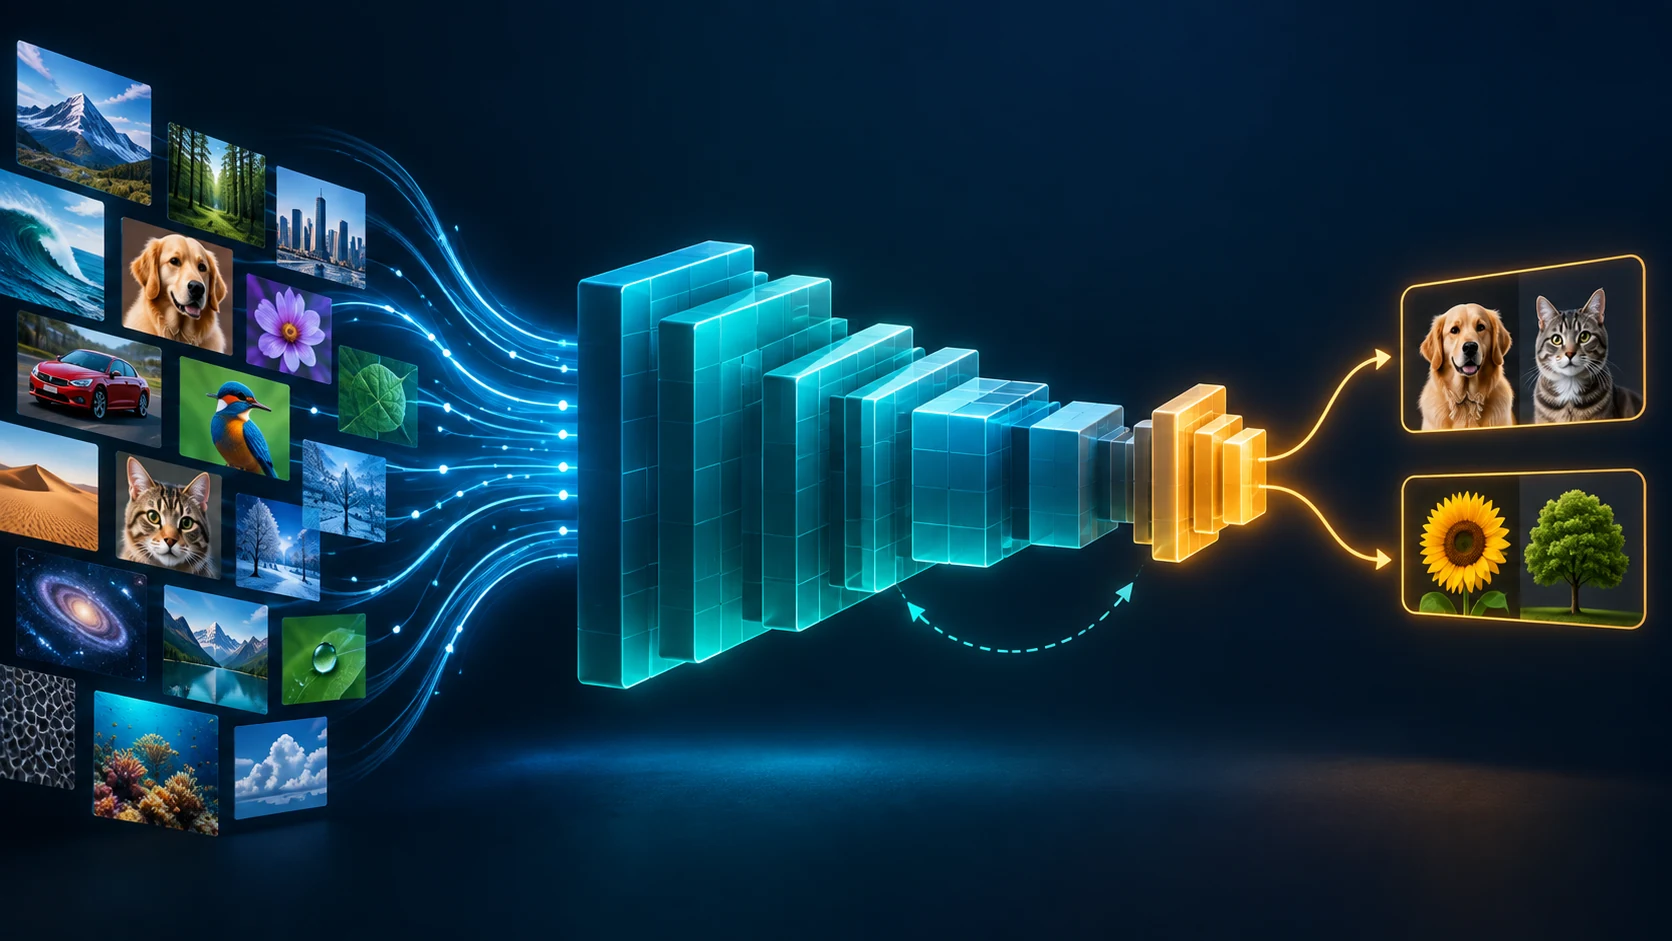
L’apprentissage par transfert consiste à partir d’un modèle entraîné sur une tâche ou un jeu de données, puis à l’adapter à une autre tâche. On réutilise des représentations apprises plutôt que de repartir de poids aléatoires. Cette approche peut aider lorsque les données annotées sont limitées, mais le bénéfice dépend de la proximité entre les tâches source et cible. Aucun multiplicateur de réduction des données ne s’applique à tous les projets.
Deux approches courantes. Pour l’extraction de caractéristiques, on gèle le réseau préentraîné et on entraîne une nouvelle tête de sortie sur les données cibles. Pour l’ajustement fin, on établit d’abord une tête fonctionnelle, puis on met aussi à jour certaines couches préentraînées. Le tutoriel d’images de TensorFlow illustre cet ordre et avertit qu’entraîner immédiatement toute la base avec une tête initialisée au hasard peut détériorer des caractéristiques utiles. PyTorch compare également les deux méthodes sur un petit jeu d’images. Les modèles de langue réutilisent eux aussi des poids préentraînés, mais leurs détails de structure et d’entraînement diffèrent.
Comment mesurer l’effet. Définissez la tâche cible et un jeu de test séparé avant de choisir un modèle. Avec la même répartition des données, comparez une solution de référence simple, l’extraction de caractéristiques gelées et un ajustement fin prudent. Mesurez la qualité, le coût d’entraînement, le coût d’inférence et les types d’erreurs. Si les données cibles s’éloignent des données de préentraînement, vérifiez si les caractéristiques transférées aident réellement. Un résultat de tutoriel ne garantit aucun gain pour l’imagerie médicale, une caméra d’usine ou des documents juridiques.
Le transfert négatif. Les connaissances de la tâche source peuvent réduire les performances sur la cible. Un décalage de domaine, des étiquettes incompatibles, un prétraitement différent, un surapprentissage ou un ajustement trop agressif peuvent en être la cause. Gardez un jeu de validation et ne concluez pas à partir de la seule précision d’entraînement.
Combien de données annotées économiser ? Il n’existe pas de règle universelle de facteur dix ou cent. Le besoin dépend du modèle source, de la similarité des tâches, du niveau de qualité attendu et de la méthode d’évaluation. Mesurez une courbe d’apprentissage sur vos propres données cibles.
Sources : tutoriel TensorFlow, tutoriel PyTorch, guide Hugging Face, étude du transfert négatif.